
Overview
本篇整理 2022–2024 年机器人操作(manipulation)学习中的八篇代表性工作。它们看似分散,其实共同回答两个问题:如何表达示范中的多模态动作分布(multimodal action distribution),以及如何把机器人策略「做大」(scaling)。按这两条线索,可以把八篇论文归为三组:
- 小规模模仿 + 表达力更强的动作模型:ACT 用 action chunking + CVAE 处理复合误差与多模态;Diffusion Policy(DP)改用扩散过程直接建模动作分布;DP3 把观测从 2D 图像换成 3D 点云以提升泛化。
- 机器人 Transformer 的规模化与 VLA 的出现:RT-1 在其真实机器人数据集上展示了 Transformer 策略的规模化训练;RT-2 进一步把互联网级 VLM 的表征用于控制,推动了 Vision-Language-Action(VLA)范式。
- 开源通才 / 基础模型:Octo 与 OpenVLA 是两条开源路线(轻量扩散头 vs. 7B VLM);RDT-1B 把扩散策略推到十亿参数级的双臂基础模型。
这些工作在方法上互相借用:action chunking 贯穿 ACT、DP、Octo、RDT;扩散动作头从 DP 扩散到 DP3、Octo、RDT;动作 token 化从 RT-1 延续到 RT-2、OpenVLA。
Paper List
| 简称 | 年份 / Venue | 主题 | 机器人 / Benchmark | 核心思想 |
|---|---|---|---|---|
| ACT | RSS 2023 | 模仿学习 / action chunking | ALOHA 双臂真机 | 一次预测动作块 + CVAE,缓解复合误差 |
| DP | RSS 2023(后扩展 IJRR 2024) | 扩散策略 | Robomimic 等 4 类 + UR5/Franka | 用条件扩散建模动作分布 |
| DP3 | RSS 2024 | 3D 扩散策略 | 72 仿真任务 + Franka/Allegro | 稀疏点云 + 轻量 3D 编码器提升泛化 |
| RT-1 | RSS 2023 | 机器人 Transformer | Everyday Robots 移动操作机 | 大规模真机数据 + 动作离散 token |
| RT-2 | CoRL 2023 | VLA / 知识迁移 | Everyday Robots 移动操作机 | VLM 直接输出动作 token,涌现语义泛化 |
| Octo | RSS 2024 | 开源通才策略 | 9 套真机(WidowX/UR5/Franka) | 模块化 Transformer + 扩散头,快速微调 |
| OpenVLA | CoRL 2024 | 开源 7B VLA | WidowX / Google robot / Franka | 双视觉编码器 + Llama 2,全开源可微调 |
| RDT | ICLR 2025 | 双臂扩散基础模型 | ALOHA 双臂真机 | 1.2B DiT 扩散 + 统一动作空间 |
ACT
Learning Fine-Grained Bimanual Manipulation with Low-Cost Hardware(ACT,Action Chunking with Transformers)
一句话用 Transformer 一次性预测未来一段动作块(action chunk),配合 CVAE 隐变量与时序集成,从约 50 条示范里学会低成本双臂硬件上的细粒度操作。
会议 / 年份 RSS 2023 | 机构 Stanford · UC Berkeley · Meta | 方向 Imitation learning, action chunking, CVAE | 真机 ✅ ALOHA 双臂(14-DoF,4 相机)
材料 Paper · Project · Code (ACT) · Code (ALOHA 硬件)
BibTeX
@inproceedings{zhao2023learning,
  title     = {Learning Fine-Grained Bimanual Manipulation with Low-Cost Hardware},
  author    = {Zhao, Tony Z. and Kumar, Vikash and Levine, Sergey and Finn, Chelsea},
  booktitle = {Robotics: Science and Systems},
  year      = {2023},
  url       = {https://arxiv.org/abs/2304.13705}
}
Motivation
细粒度双手操作(穿扎带、插电池、开调料杯盖)对硬件精度要求高,而低成本遥操作硬件本身不精确、示范带噪声。逐帧模仿学习在长时程上会累积复合误差(compounding error):某一步偏差导致观测分布偏移,后续预测越漂越远。ACT 的目标是让这类精细任务在约 10 分钟示范、廉价硬件上也能学会。
Method
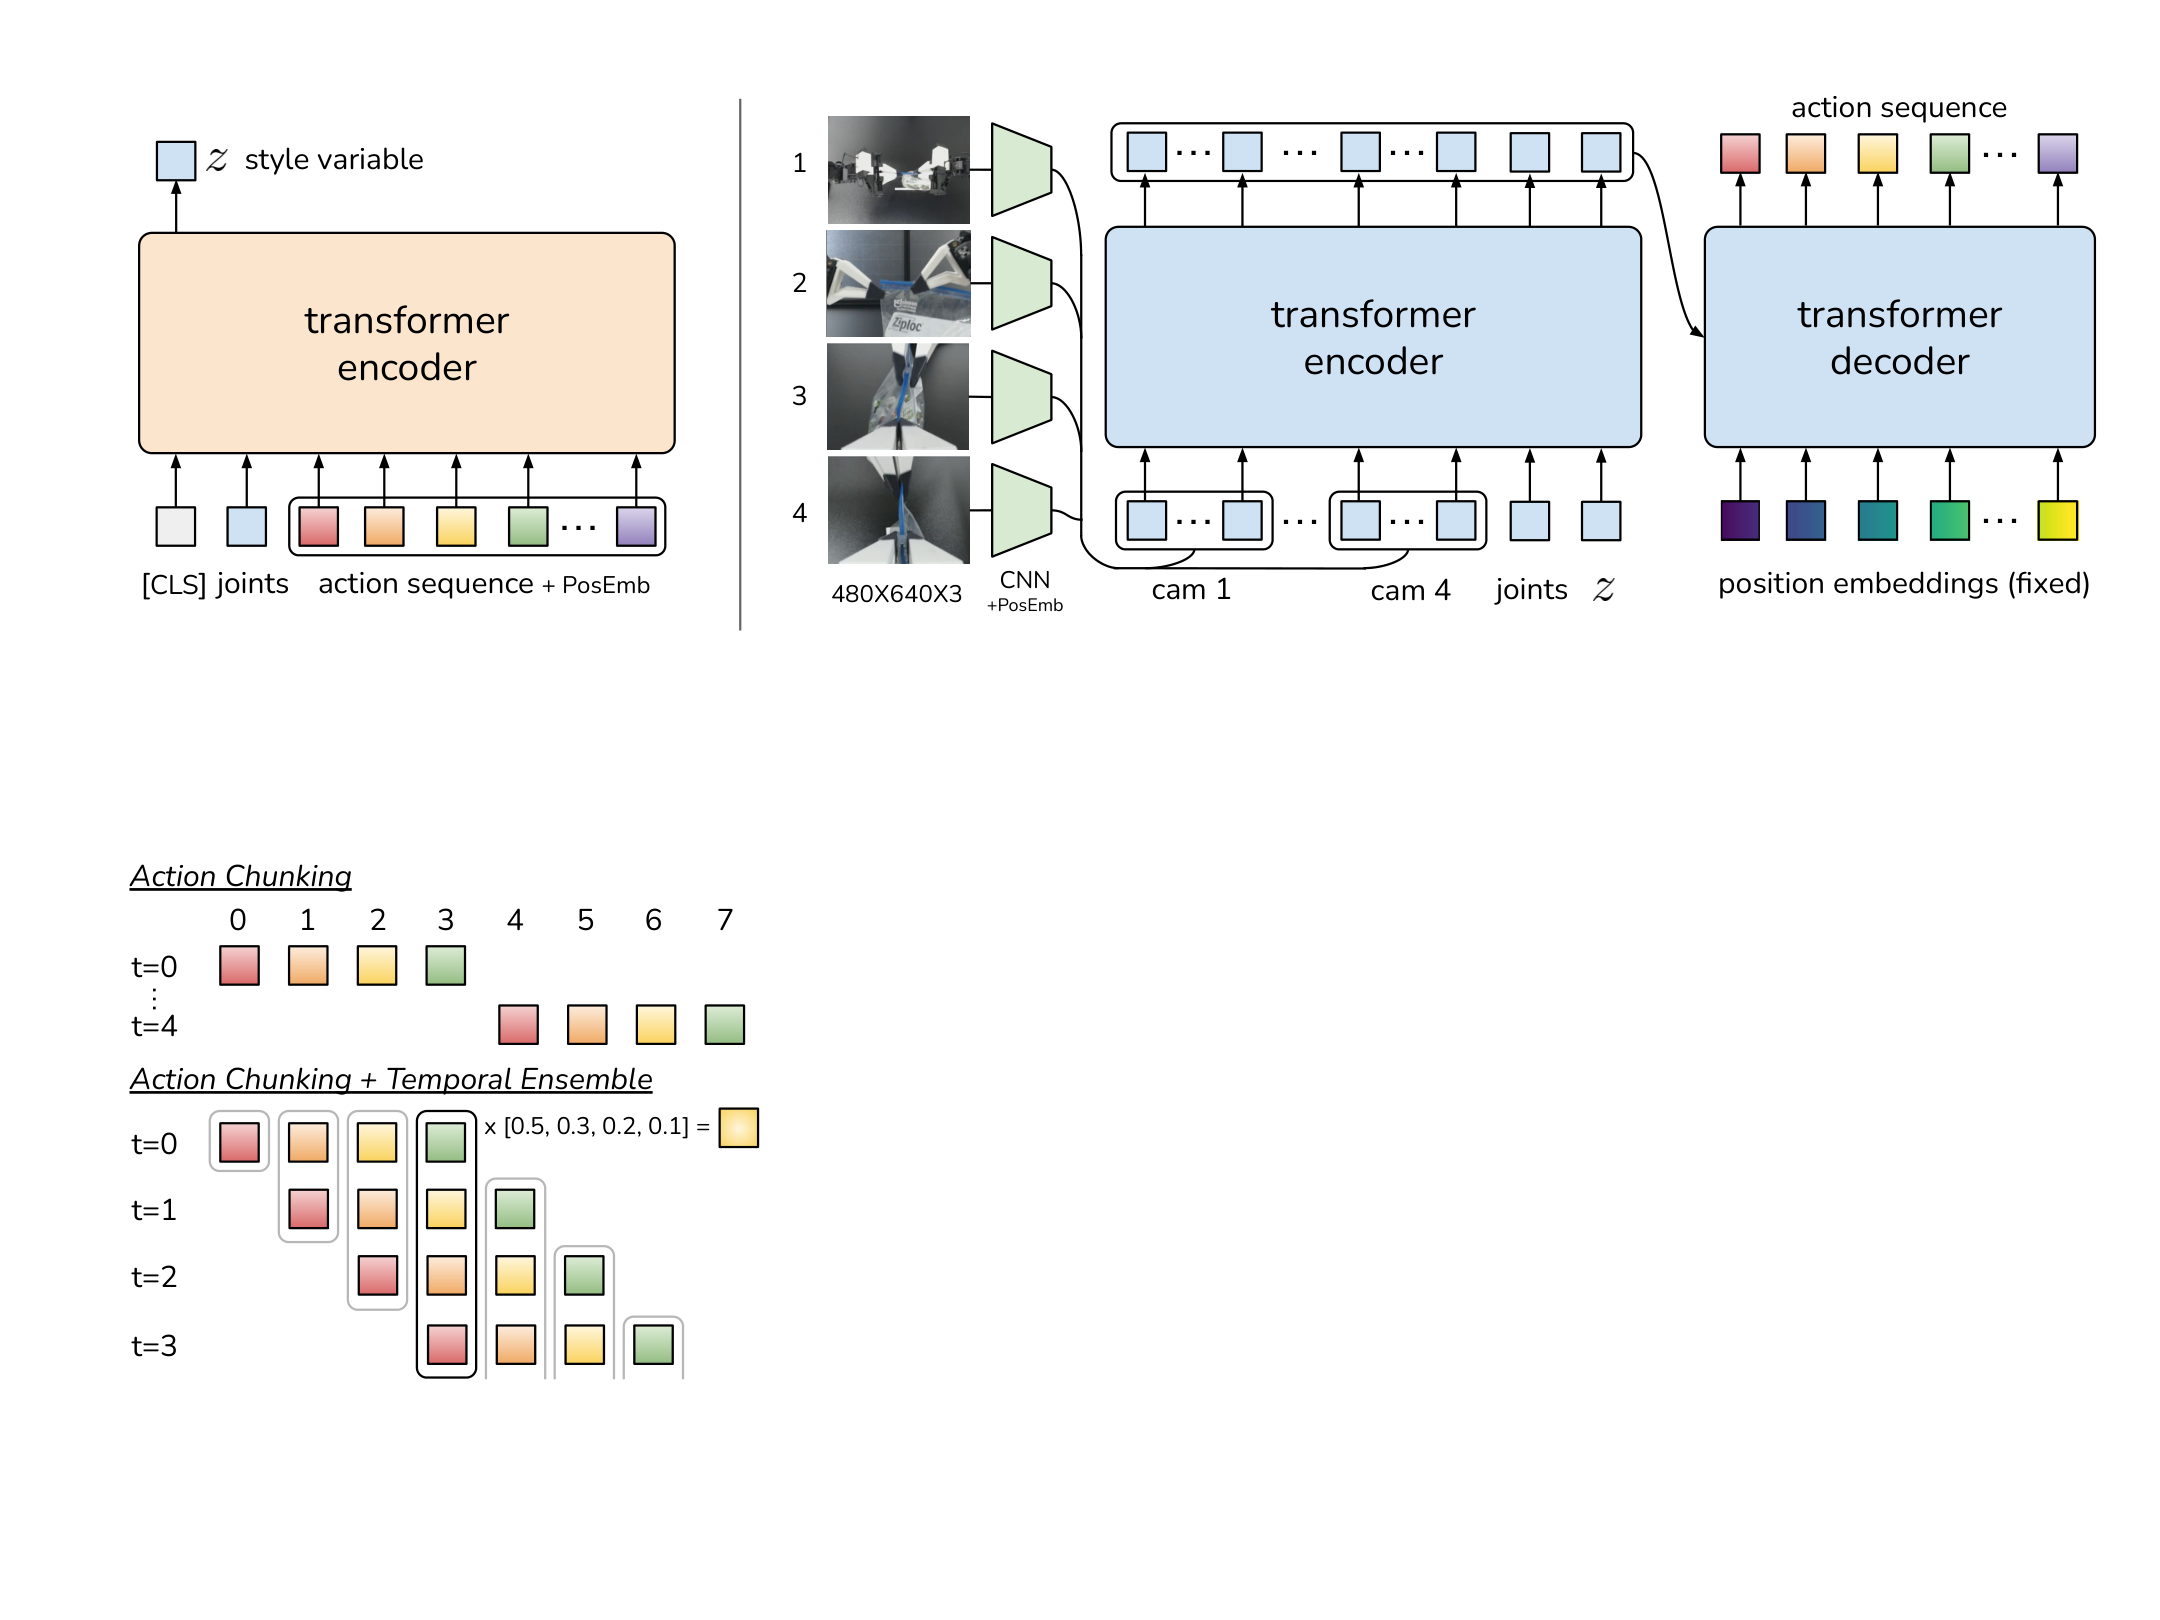
ACT 以 CVAE 形式训练,核心是把预测粒度从「每帧」抬到「每段」:
- Action Chunking:策略一次预测未来 k 步动作,把有效决策步数缩短到原来的 1/k,直接压制复合误差。
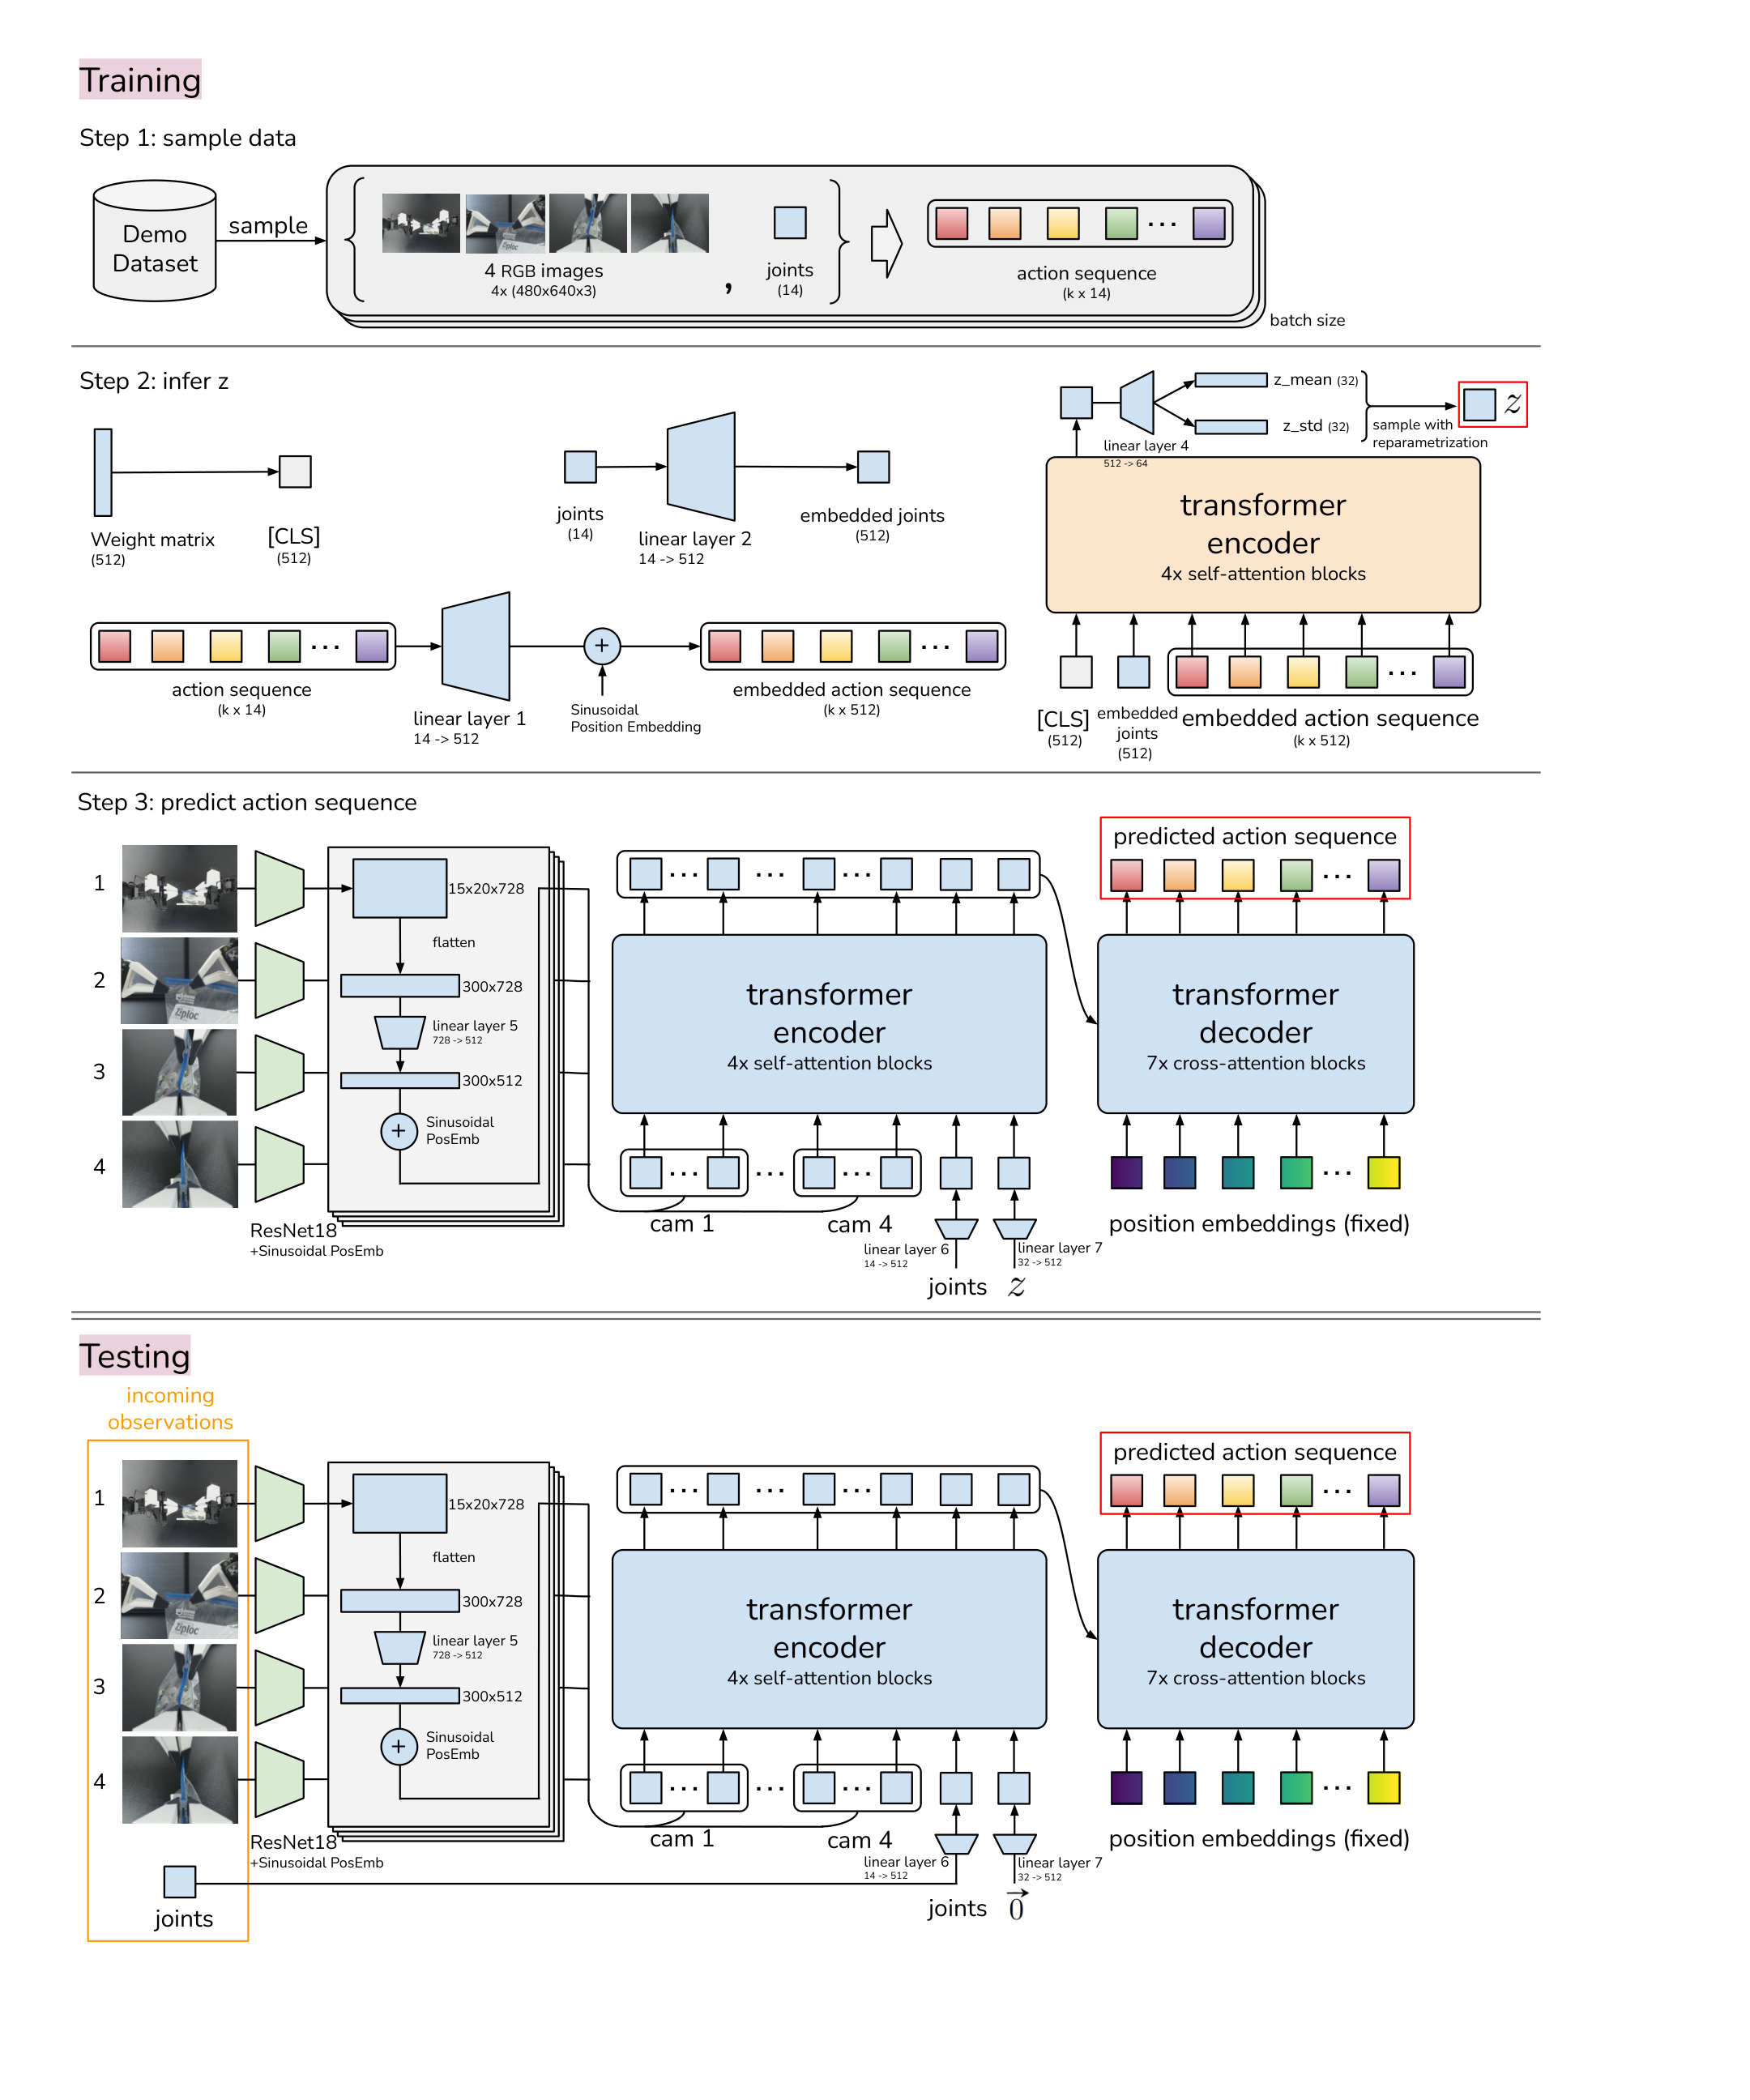
- CVAE + Transformer:训练时一个 style encoder 把专家动作序列 + 关节状态压成隐变量 z;观测(ResNet-18 图像特征 + 关节 token)与 z 一起送入 Transformer decoder。推理时 z 取先验均值(即 z = 0),而非从 N(0, I) 采样。
- 非自回归解码:decoder 在一次前向中输出完整的 动作块,而不是逐步自回归生成。
- Temporal Ensemble:相邻时刻预测的动作块在时间上重叠,对重叠部分做指数加权平均(权重 )平滑输出、抑制抖动。
结构规模:ResNet-18 编码每帧图像,4 层 encoder + 7 层 decoder,隐变量维度 32,参数量约 80M;论文设置可在单张 GPU 上训练。
Experiments
- 平台与数据:真机为 ALOHA 双臂(约 2 万美元级、开源),6 个细粒度真实任务 + 2 个仿真任务(Transfer Cube、Bimanual Insertion);每任务约 50 条示范(Thread Velcro 用 100 条)。
- 结果:真实任务成功率大致落在 80–90%(单任务从 64% 到 96% 不等)。
- Baseline:论文对比 BC-ConvMLP、BeT(Behavior Transformer)、RT-1 和 VINN;不同基线在不同任务上的差距并不一致,例如 BeT 在部分任务可达到约 60%。
- 消融:动作块长度 k = 100(对应 50Hz 下约 2s)是常用甜点;隐变量维度 32 足够。Temporal ensemble 有正向增益,但论文未给出可直接引用的固定百分点数值。
- 超参数:论文采用 KL 权重 β = 10。
Strengths and Limitations
Strengths:样本高效(约 50 条示范即可);action chunking + temporal ensemble 直击复合误差并平滑轨迹;非自回归单次解码,推理可跟上 50Hz 实时控制;低成本开源硬件降低了双臂研究门槛。
局限(分析):评测集中在短时程桌面任务,k 需按域调参(反应性 vs. 平滑性权衡);纯模仿、无在线纠错,性能上限受示范质量约束;单一 embodiment(ALOHA),跨机器人泛化非其目标。
Takeaways
Action chunking 是这一批工作里最有生命力的设计之一,后续 DP、Octo、RDT 都在动作块上做文章;ACT 与 DP 分别用 CVAE 与扩散回答同一个「多模态」问题,为后面扩散路线埋下对照。
DP
Diffusion Policy: Visuomotor Policy Learning via Action Diffusion
一句话把动作序列的生成建模成一个**条件去噪扩散(conditional denoising diffusion)**过程:给定观测,从高斯噪声迭代去噪出动作块,天然表达多模态分布。
会议 / 年份 RSS 2023(Best Paper,后扩展为 IJRR 2024)| 机构 Columbia · Toyota Research Institute · MIT | 方向 Diffusion policy, imitation learning | 真机 ✅ UR5 · Franka
BibTeX
@inproceedings{chi2023diffusion,
  title     = {Diffusion Policy: Visuomotor Policy Learning via Action Diffusion},
  author    = {Chi, Cheng and Xu, Zhenjia and Feng, Siyuan and Cousineau, Eric and Du, Yilun and Burchfiel, Benjamin and Tedrake, Russ and Song, Shuran},
  booktitle = {Robotics: Science and Systems},
  year      = {2023},
  url       = {https://arxiv.org/abs/2303.04137}
}
元数据说明:代码仓库位于
real-stanford组织,但论文署名机构为 Columbia、TRI 和 MIT;会议为 RSS 2024。
Motivation
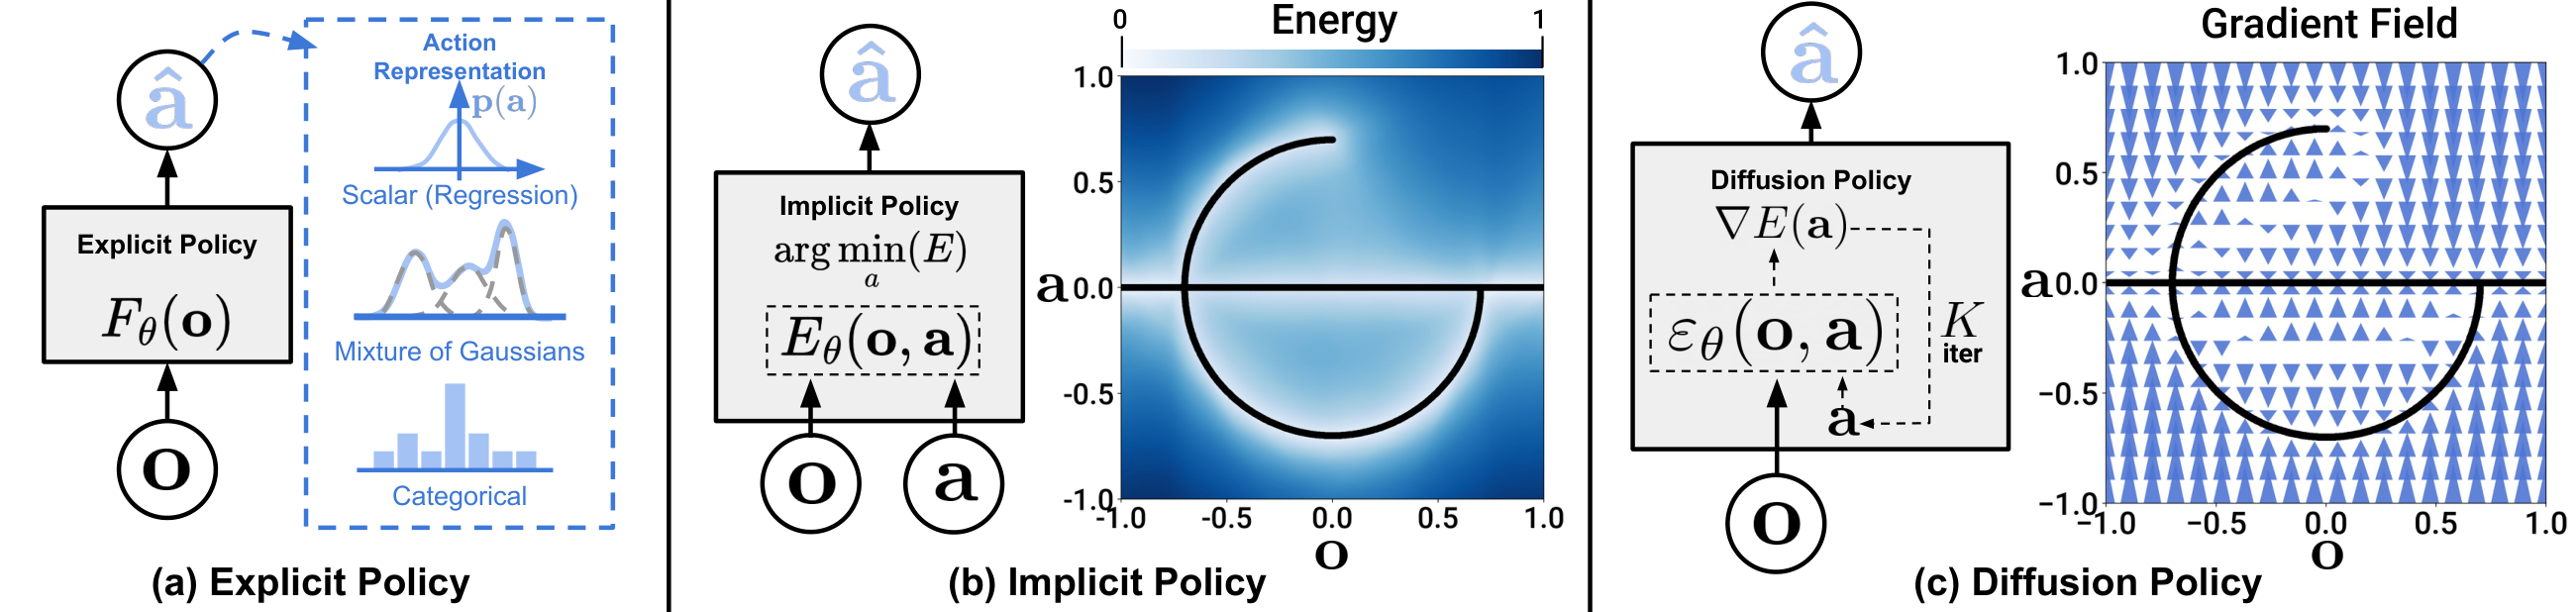
行为克隆(behavior cloning)面对多模态示范时会「取中间」:同一局面可以左推也可以右推,回归(MSE)或混合高斯(GMM)会把两个模式平均成一个都不对的动作。DP 的出发点是用扩散过程直接学习动作分布的(近似)梯度,通过迭代去噪表达任意复杂的多模态分布,同时保持训练稳定。
Method
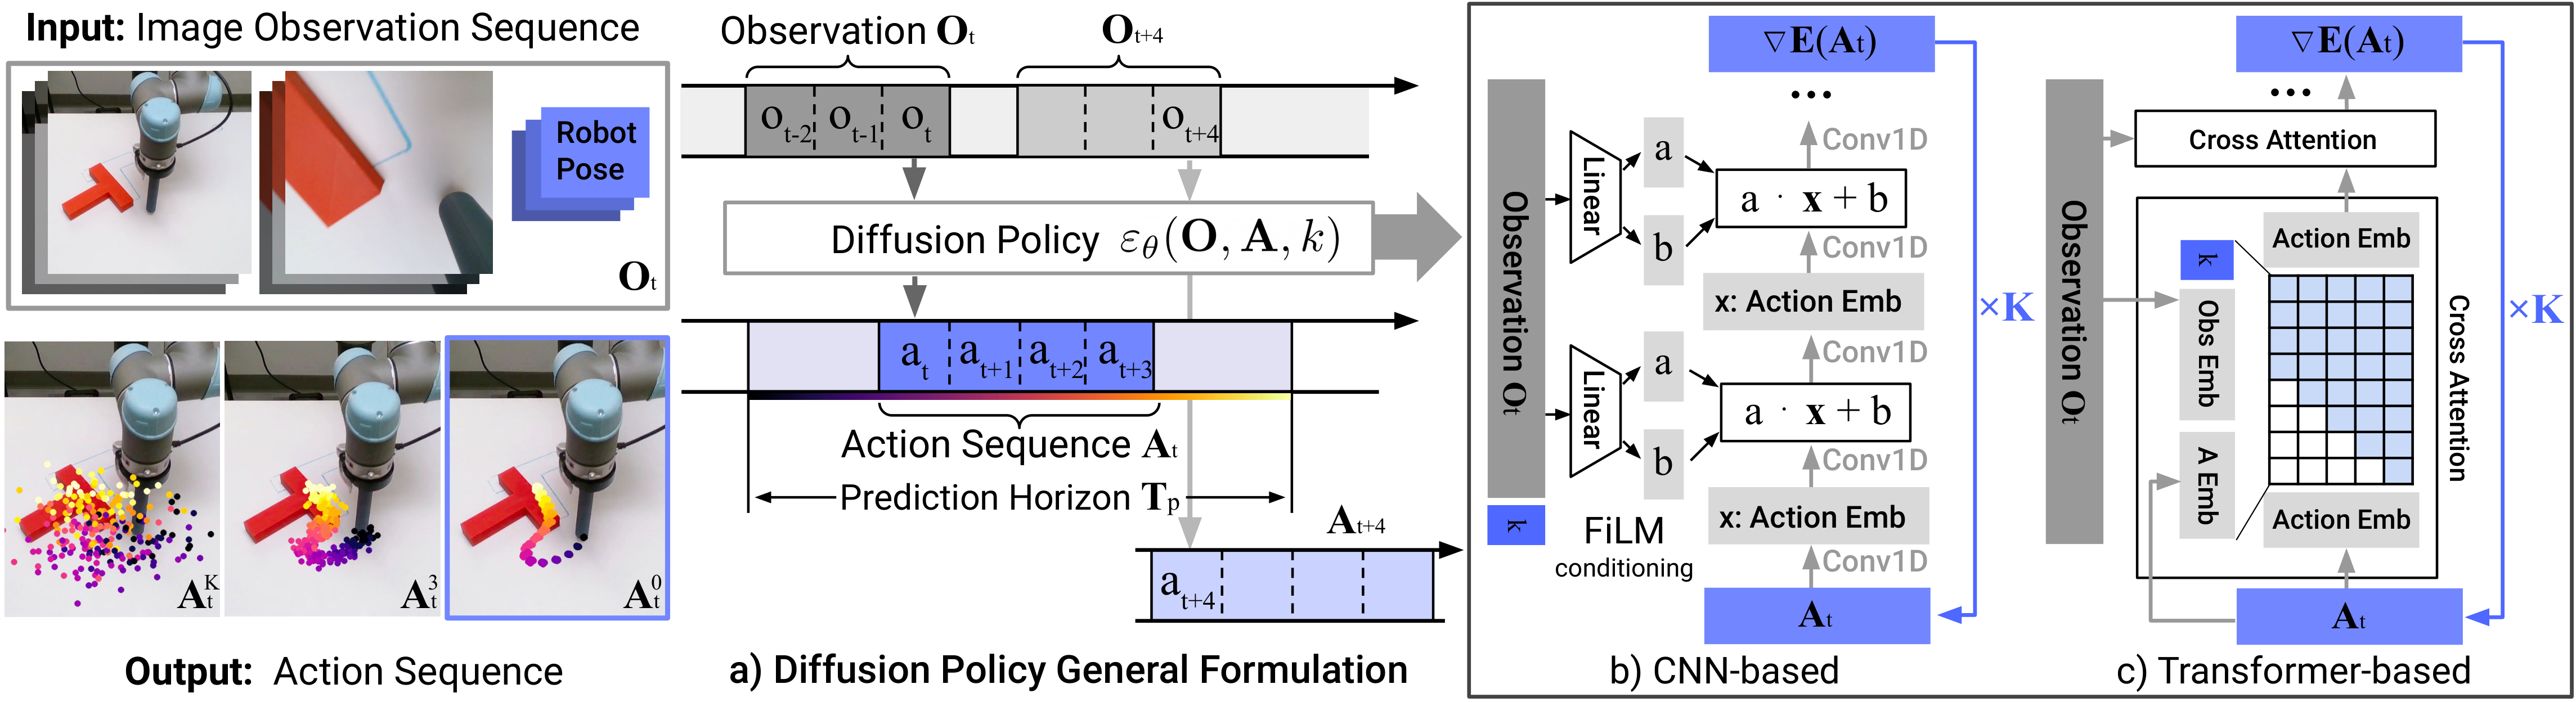
- 动作空间上的 DDPM:训练一个噪声预测网络 ,学习在扩散第 k 步加到动作上的噪声(标准 DDPM 目标),推理时从高斯噪声迭代去噪成动作序列。
- 两种去噪骨干:CNN 版(1D temporal U-Net,观测经 FiLM 条件化)与 Transformer 版(改自 minGPT)。论文的结论不是简单的「CNN 更快」,而是:CNN U-Net 是好调、鲁棒的默认选择,但对高频/快速变化的动作较弱;Transformer 在这类任务上更好,但对超参更敏感。
- 视觉编码:ResNet-18(从零训练),把全局平均池化换成 spatial-softmax、BatchNorm 换成 GroupNorm 以稳定 EMA。
- Receding horizon:观测窗口 、预测视野 、执行步数 ;常用 ,推理用 DDIM 10 步即可保持性能。
Experiments
- 仿真:12 个任务、4 类 benchmark(Robomimic、Push-T、Multimodal Block Pushing、Franka Kitchen),相对已有方法平均成功率提升约 46.9%。
- Push-T 是刻意设计的多模态任务:MSE 回归几乎失败、GMM 也差,DP 大幅领先——直观说明为何需要多模态动作建模。
- Baseline:LSTM-GMM、IBC、BET 等,DP 全面更优且训练更稳(无 IBC 的能量模型不稳定问题)。
- 真机:UR5(真实 Push-T)与 Franka(含多阶段「倒/抹酱」任务)。
- 推理:论文在 RTX 3080 上报告 DDIM 10 步约 0.1 秒;正文不引用论文没有报告的其他延迟数字。
Strengths and Limitations
Strengths:自然表达多模态、避免模式平均;训练稳定;能处理高维、时间连贯的动作序列;跨 12 个仿真任务与两类真机验证充分。
局限(分析):迭代去噪比单步回归更贵,需 DDIM 才能接近实时(仍约 0.1s/次);骨干与视野选择敏感;纯行为克隆,受示范覆盖约束;主设定下视觉编码器从零训练,未用大规模预训练。
Takeaways
Diffusion Policy 系统展示了用扩散模型表示多峰机器人动作分布,并影响了 DP3、Octo 的扩散头和 RDT 等后续工作。它与 ACT 都采用动作序列预测和 receding-horizon 执行,但机器人策略仍存在单步动作、自回归 token 和分层控制等其他设计。
DP3
3D Diffusion Policy: Generalizable Visuomotor Policy Learning via Simple 3D Representations
一句话在稀疏点云上做扩散策略:用一个极简的 3D 编码器把点云压成紧凑特征来条件化扩散,换取更好的泛化与样本效率。
会议 / 年份 RSS 2024 | 机构 上海期智研究院 · 上海交通大学 · 清华大学 IIIS · 上海人工智能实验室 | 方向 3D diffusion policy | 真机 ✅ Franka + Allegro 灵巧手
BibTeX
@inproceedings{ze2024dp3,
  title     = {3D Diffusion Policy: Generalizable Visuomotor Policy Learning via Simple 3D Representations},
  author    = {Ze, Yanjie and Zhang, Gu and Zhang, Kangning and Hu, Chenyuan and Wang, Muhan and Xu, Huazhe},
  booktitle = {Robotics: Science and Systems},
  year      = {2024},
  url       = {https://arxiv.org/abs/2403.03954}
}
项目页、代码仓库与作者机构以上方列出的论文元数据为准。
Motivation
DP 依赖 2D 图像,对视角、光照、纹理变化的泛化有限。DP3 的设想是:几何比纹理更稳定的泛化信号——用一台深度相机得到点云,直接在 3D 表征上条件化扩散策略,从而在更少示范下获得更好的泛化与安全性。
Method
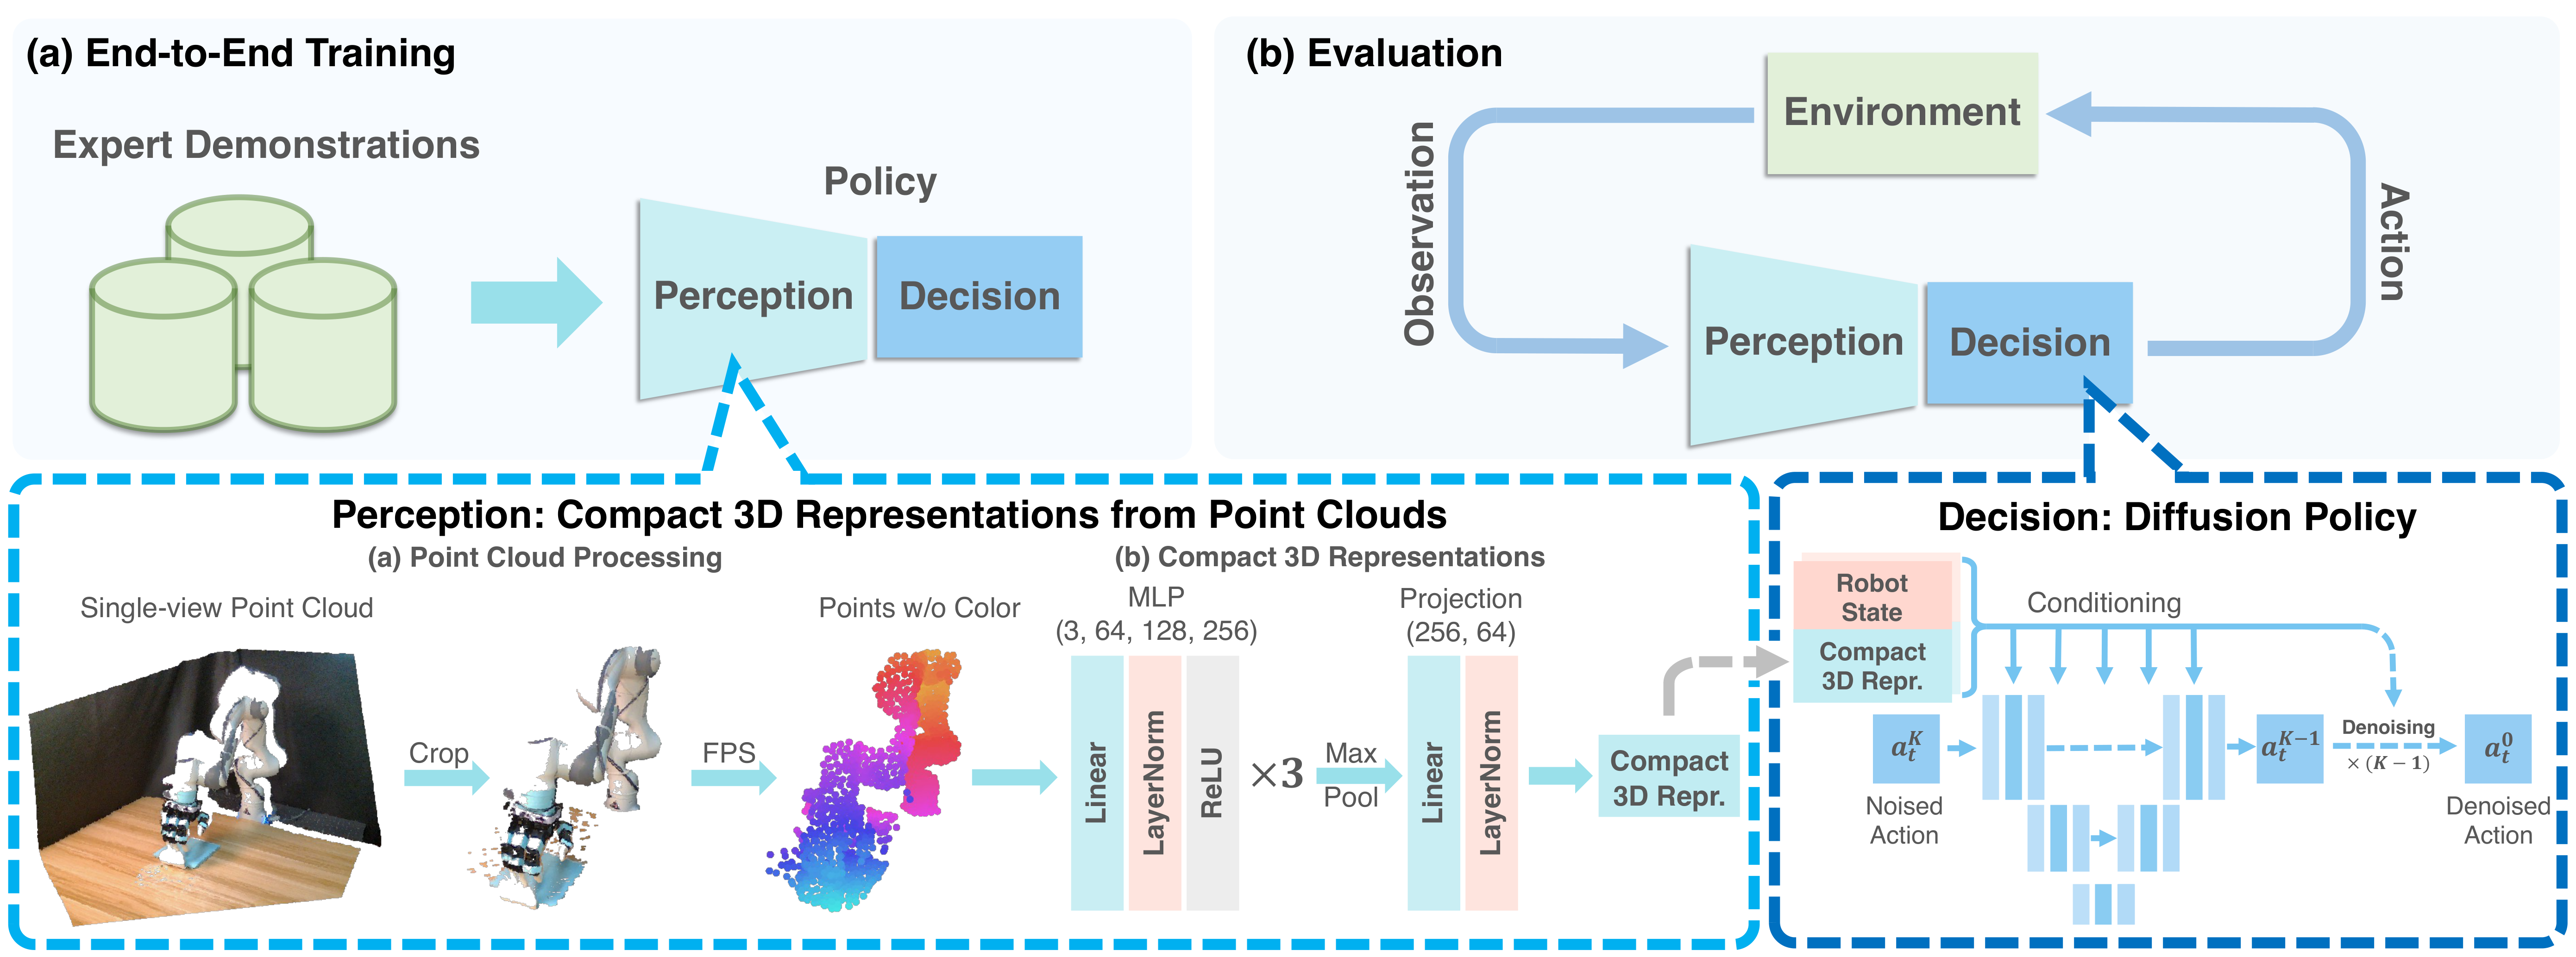
- 3D 输入:单深度相机的稀疏点云,用**最远点采样(FPS)**下采到 512 或 1024 点。
- DP3 Encoder:使用三层 MLP、max-pooling 和投影头,将点云编码为 64 维紧凑向量;论文没有采用 PointNet++ 或 Point Transformer。
- 去噪网络:与 DP 相同的条件扩散 + 1D temporal U-Net,训练 100 步、推理 DDIM 10 步。与 DP 的差异仅在观测编码,故代码改动很小。
Experiments
- 仿真:72 个任务、跨 7 个域(Adroit、Bi-DexHands、DexArt、DexDeform、DexMV、HORA、MetaWorld);每任务仅 10 条示范时相对 baseline 约 +24.2%(相对提升)。
- 真机:Franka 机械臂 + Allegro 灵巧手(RealSense L515),4 个任务、每任务 40 条示范:Roll-Up 90%、Dumpling 70%、Drill 80%、Pour 100%,平均 85%。
- 结果口径:85% 是论文四个真机任务的平均成功率,不对应单独的“更换马克杯”任务。正文只保留能够与论文表格逐项对应的任务和数字。
Strengths and Limitations
Strengths:编码器极轻(3 层 MLP),无重型 3D 骨干;样本高效(10 条示范即有效);相对 2D DP 在视角/实例/外观变化下泛化更好、安全违规更少。
局限(分析):依赖标定良好、干净的点云,对深度噪声、透明/反光物体敏感;单视角稀疏点云,性能与裁剪、点云质量强相关;扩散推理成本仍在(靠 10 步 DDIM 缓解)。
Takeaways
DP3 的价值在于「简单 3D 表征也能显著提升泛化」,而不是堆更复杂的 3D backbone。它提示:当任务对几何敏感时,换观测表征往往比换策略更有效。
RT-1
RT-1: Robotics Transformer for Real-World Control at Scale
一句话可消化大规模异构真机数据的机器人 Transformer:图像历史 + 语言指令 → 离散动作 token,体现机器人里的 scaling 思路,为 RT-2 铺路。
会议 / 年份 RSS 2023 | 机构 Google(Robotics at Google + Everyday Robots)| 方向 Robot Transformer, imitation learning | 真机 ✅ Everyday Robots 移动操作机
BibTeX
@inproceedings{brohan2023rt1,
  title     = {{RT-1}: Robotics Transformer for Real-World Control at Scale},
  author    = {Brohan, Anthony and others},
  booktitle = {Robotics: Science and Systems},
  year      = {2023},
  url       = {https://arxiv.org/abs/2212.06817}
}
官方项目页为
robotics-transformer1.github.io。
Motivation
把视觉/NLP 里「大而多样的数据 → 通才模型」的配方搬到机器人:让单个 Transformer 策略吸收大规模、任务无关的真机数据,零样本泛化到新任务、新物体、新环境,并能融合仿真与异构机器人的数据,同时吞吐量要够在真机上实时运行。
Method
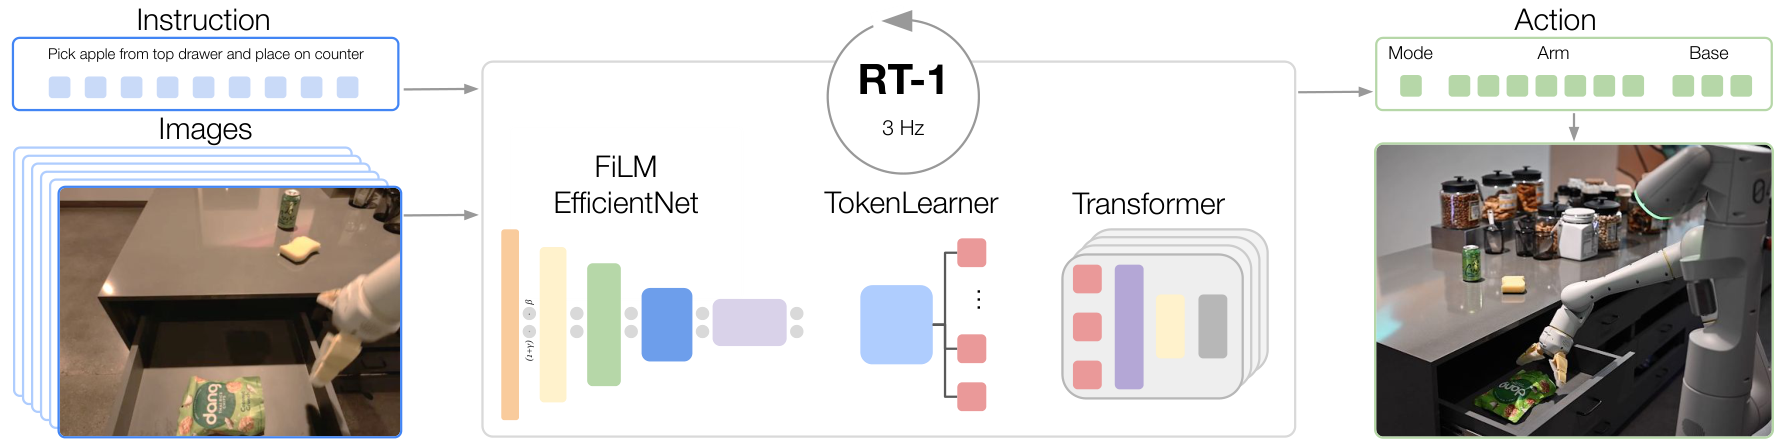
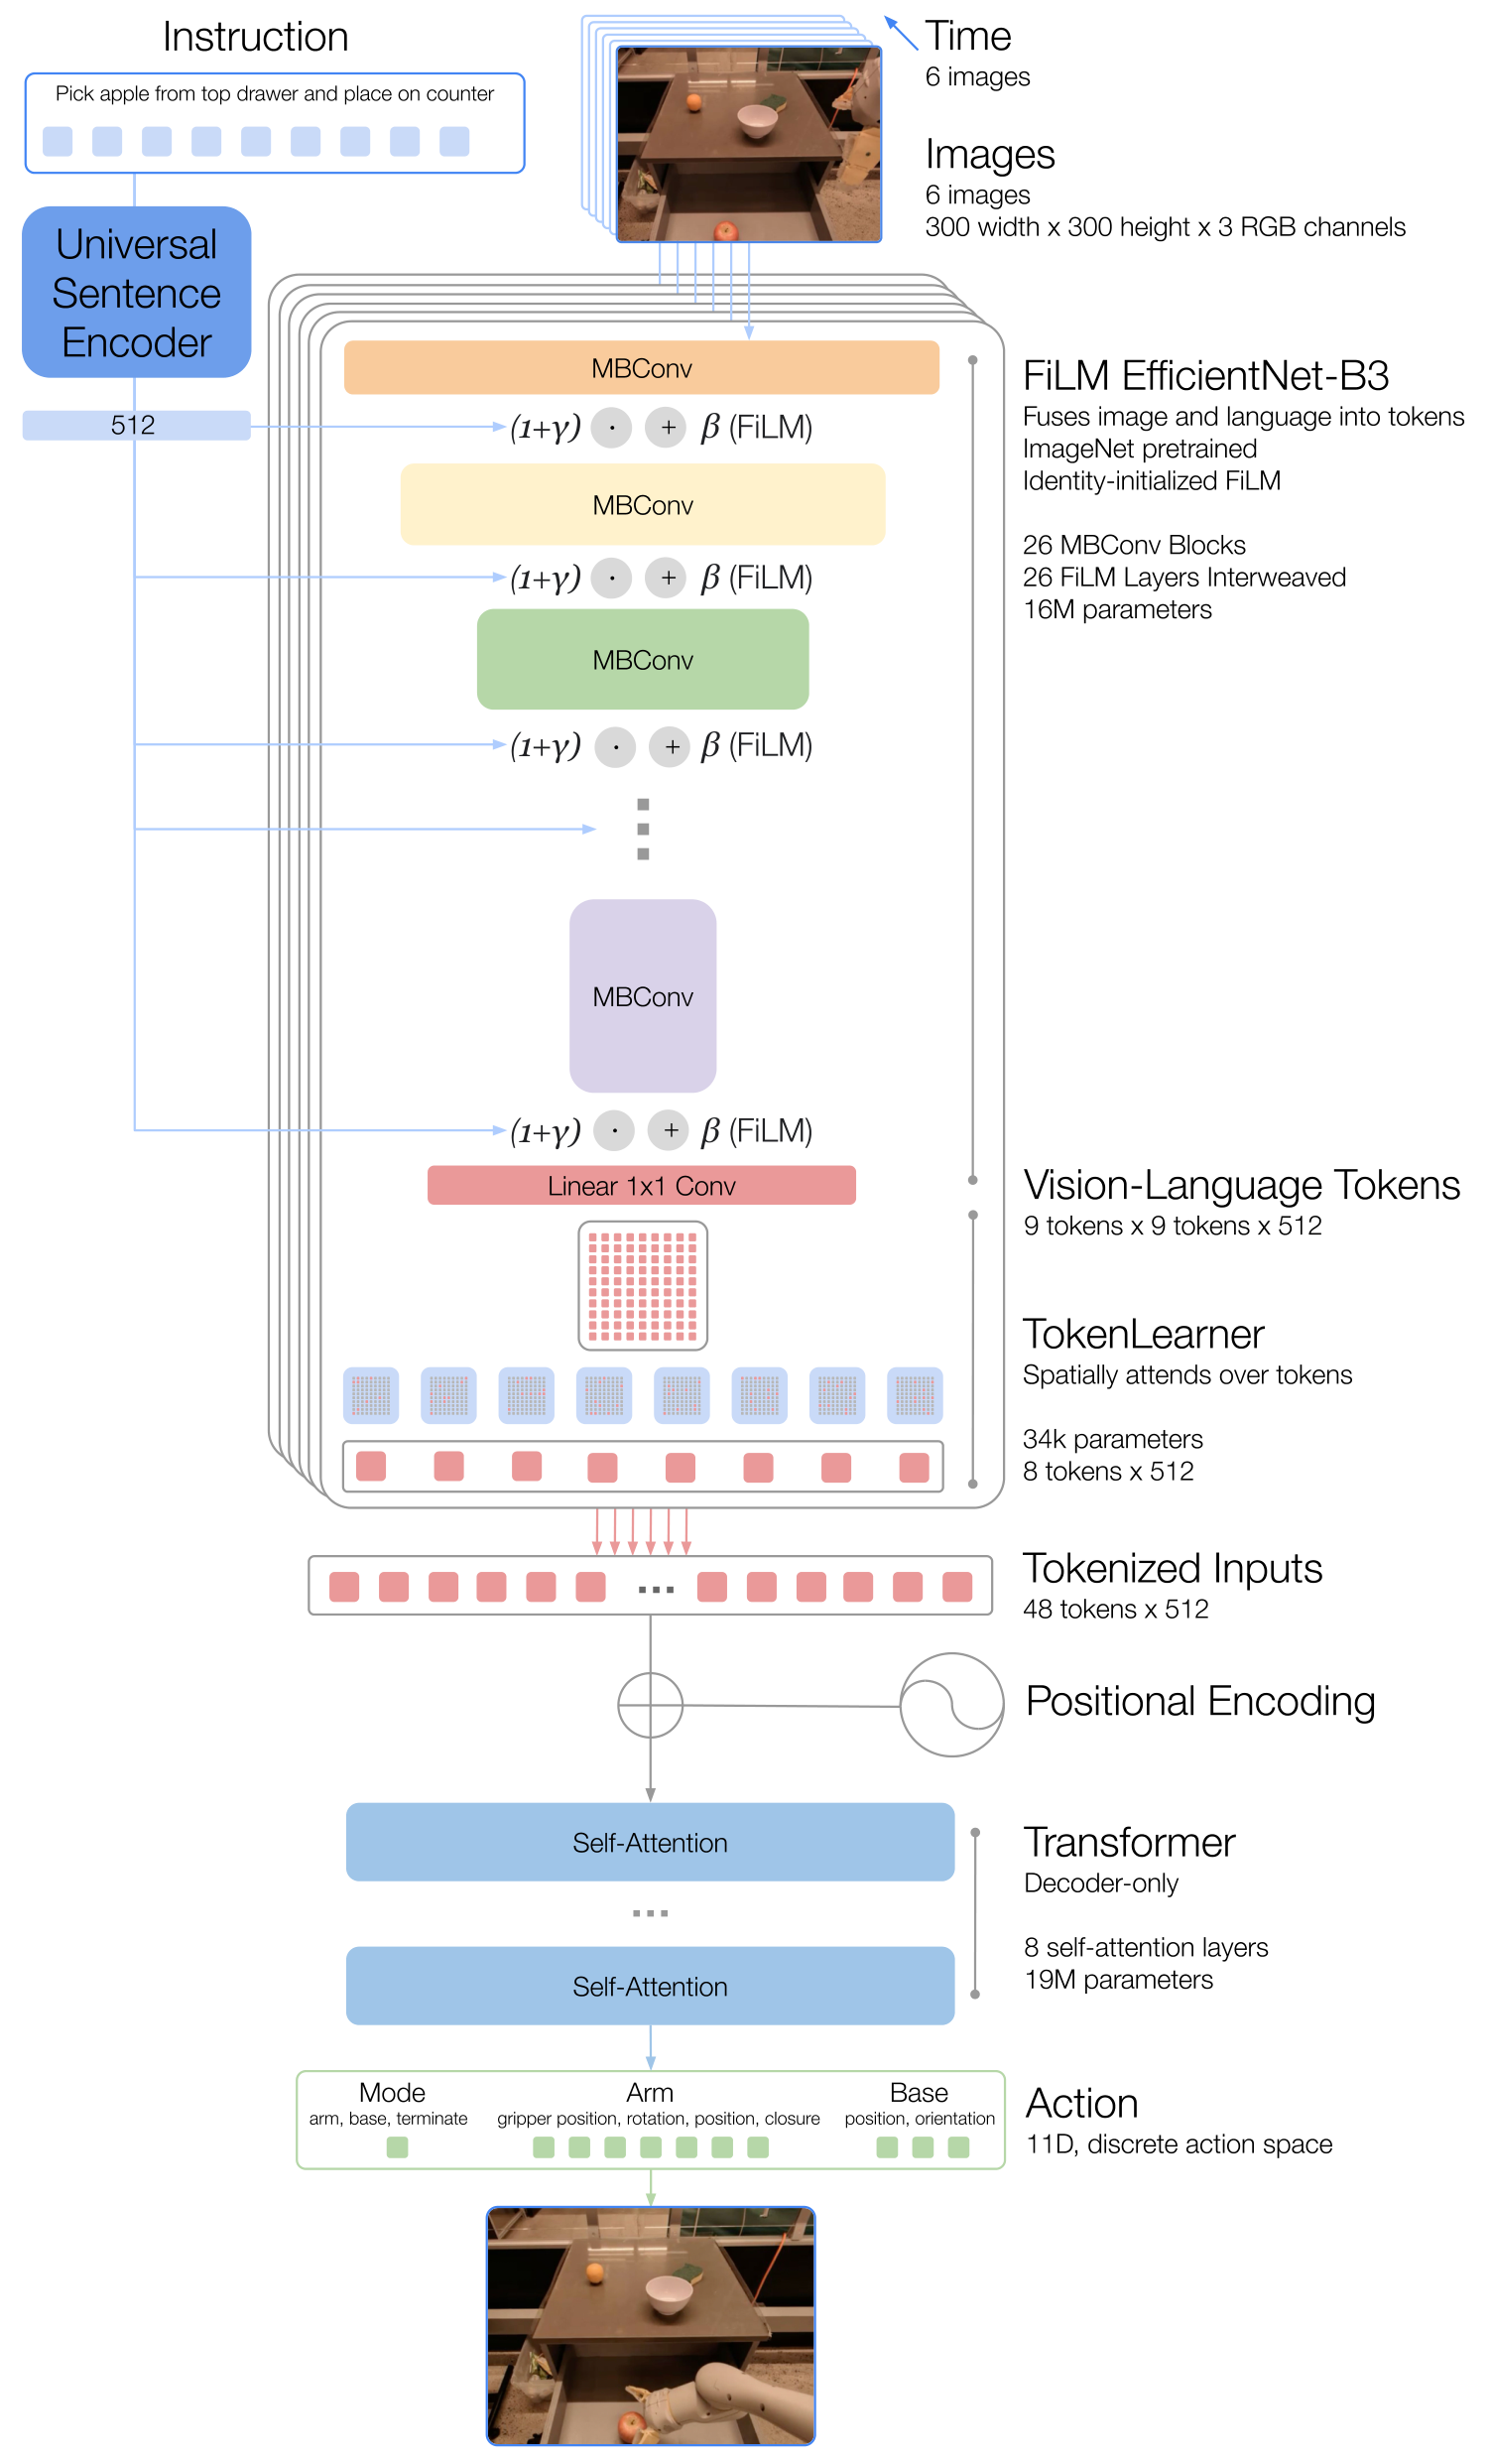
- 动作离散为 token:每个动作维度均匀离散为 256 个 bin,每维一个 token,用交叉熵训练。
- 11 维动作空间:7 维手臂(x/y/z、roll/pitch/yaw、夹爪)+ 3 维底盘(x/y/yaw)+ 1 维模式切换(控臂 / 控底盘 / 终止)。
- 高效视觉骨干:EfficientNet-B3 提特征,语言经 Universal Sentence Encoder 编码并以 FiLM 注入,TokenLearner 把每帧压成 8 个 token;6 帧历史共 48 token,送入 8 层 decoder-only Transformer。
- 实时性:论文系统约 3 Hz,模型参数量约 35M。
Experiments
- 数据:约 13 万条示范、13 台机器人、700+(744)条指令,历时 17 个月采集。
- 主结果与 baseline(成功率):
| 方法 | Seen | Unseen 指令 | Distractors | Backgrounds |
|---|---|---|---|---|
| RT-1 | 97% | 76% | 83% | 59% |
| BC-Z | 72% | 19% | 47% | 41% |
| Gato | 65% | 52% | 43% | 35% |
评测口径:Gato 在论文对应设置中的结果分别为 52% 与 35%;RT-1 的 76% 指 unseen 指令/任务,不是 unseen object。
- 数据规模消融:在论文的消融设置中,减少约 25% 的任务类型造成的性能下降,与减少约一半数据量相近,说明任务覆盖度对该实验很重要。这是特定数据集上的比较,不应外推成“多样性永远比数量重要”。
Strengths and Limitations
Strengths:吸收大规模、多样真机数据且有正向 scaling;对 unseen 指令、干扰物、背景的泛化明显强于 BC-Z / Gato;能融合仿真和异构(如 Kuka)数据而不损原有技能;3 Hz、<100ms 推理,可实时闭环。
局限(分析):该方法以模仿学习为主,性能受示范数据覆盖和质量约束;论文展示的泛化主要来自已见概念的新组合,并未证明能够自行获得数据中缺失的新动作或新技能;数据采集成本较高(17 个月、13 台机器人),且只覆盖单一本体,任务灵巧度与时程仍有限。
Takeaways
RT-1 在论文的移动操作任务中展示了扩大真实数据和任务覆盖度的收益,同时也反映出真机采集成本。它没有使用互联网级视觉—语言预训练;RT-2 随后研究这类预训练知识能否迁移到控制。
RT-2
RT-2: Vision-Language-Action Models Transfer Web Knowledge to Robotic Control
一句话让大型 VLM 直接输出机器人动作:把动作编码为文本 token 加入词表,在互联网 VQA 数据 + 机器人示范上 co-fine-tune,从而继承 VLM 的语义理解与推理。
会议 / 年份 CoRL 2023 | 机构 Google DeepMind | 方向 VLA, web-knowledge transfer | 真机 ✅ Everyday Robots 移动操作机 | 代码 无官方开源
BibTeX
@inproceedings{brohan2023rt2,
  title     = {{RT-2}: Vision-Language-Action Models Transfer Web Knowledge to Robotic Control},
  author    = {Brohan, Anthony and others},
  booktitle = {Conference on Robot Learning},
  year      = {2023},
  url       = {https://arxiv.org/abs/2307.15818}
}
Motivation
传统「感知 + 策略」栈难以把互联网级语义带进控制。RT-2 的洞见是:既然大型 VLM 已经会视觉推理和常识,就让它直接以文本 token 的形式吐出动作,用一个模型同时做 web VQA 与机器人控制,让语义能力自然迁移到操作上。
Method
- backbone:两个变体,RT-2-PaLI-X(55B)与 RT-2-PaLM-E(12B)。
- 动作 token 化:8 维动作包含 6-DoF 末端位移、夹爪和终止指令;每维离散为 256 个 bin,由 VLM 自回归生成并解码为连续动作。
- co-fine-tuning:混合互联网 VQA 数据与机器人示范,让 VLM 既保住语义能力又学会控制。混合比例并非统一 50/50——机器人数据在 PaLI-X 中约占 50%,在 PaLM-E 中约占 66%。
Experiments
- 涌现能力评测(RT-2-PaLI-X-55B):Symbol Understanding 82%、Reasoning 46%、Person Recognition 53%,平均约 60%;对照 RT-1 约 17%、VC-1 约 11%。
在论文的涌现/语义任务设置中,RT-1 与 VC-1 基线约为 17% 和 11%,RT-2 的汇总结果约为这些基线的 3 倍;该倍率仅适用于相同评测集合。
- 泛化:A/B 评测中约 2× 于 baseline;标准 RT-1 任务上与 RT-1 基本持平(未因 VLM 预训练损害操作能力)。
- 规模:PaLI-X-55B(约 63%)与 PaLM-E-12B(约 62%)在 unseen 泛化上基本打平,且 PaLM-E 在更难的场景上更好——不宜简单断言「55B > 12B」。
- 真机:约 6000 次评测试验,7-DoF 移动操作机;Language-Table 上刷新 SoTA(90% vs 77%)。
Strengths and Limitations
Strengths:统一 VLA,一套模型兼做 VQA 与控制;强语义泛化与推理(涌现约 3×、泛化约 2×);co-fine-tuning 保住 web 知识;支持链式推理执行多步语义指令;真机评测规模大。
局限(分析):只带来语义泛化,不产生新的物理技能(动作仍受机器人数据限制);模型巨大(至 55B),实时推理需云端 TPU,频率受限;闭源、无权重与代码;依赖 RT-1 级别的示范数据。
Takeaways
RT-2 定义了 VLA 范式,但把两个问题留给后人:部署成本(催生 OpenVLA、TinyVLA 等轻量路线)与开源(催生 OpenVLA)。
Octo
Octo: An Open-Source Generalist Robot Policy
一句话开源的跨 embodiment 通才策略:模块化 Transformer + 扩散动作头,在 Open X-Embodiment 上预训练,可在消费级 GPU 上数小时内微调到新机器人。
会议 / 年份 RSS 2024 | 机构 UC Berkeley · Stanford · CMU · Google DeepMind | 方向 开源通才策略, diffusion head | 真机 ✅ 9 套真机 / 4 家机构(WidowX、UR5、Franka 等)
BibTeX
@inproceedings{octo2024,
  title     = {Octo: An Open-Source Generalist Robot Policy},
  author    = {{Octo Model Team} and Ghosh, Dibya and Walke, Homer and Pertsch, Karl
               and Black, Kevin and Mees, Oier and Dasari, Sudeep and Hejna, Joey
               and Xu, Charles and Luo, Jianlan and Kreiman, Tobias and Tan, You Liang
               and Sanketi, Pannag and Vuong, Quan and Xiao, Ted and Sadigh, Dorsa
               and Finn, Chelsea and Levine, Sergey},
  booktitle = {Robotics: Science and Systems},
  year      = {2024},
  url       = {https://arxiv.org/abs/2405.12213}
}
Motivation
RT-2 这类强通才策略闭源且昂贵。Octo 想做一个完全开源、拿来即可高效微调的通才策略:在大规模异构机器人数据上预训练,让用户用少量目标域数据、在消费级 GPU 上几小时内适配到自己的机器人、传感器与动作空间。
Method
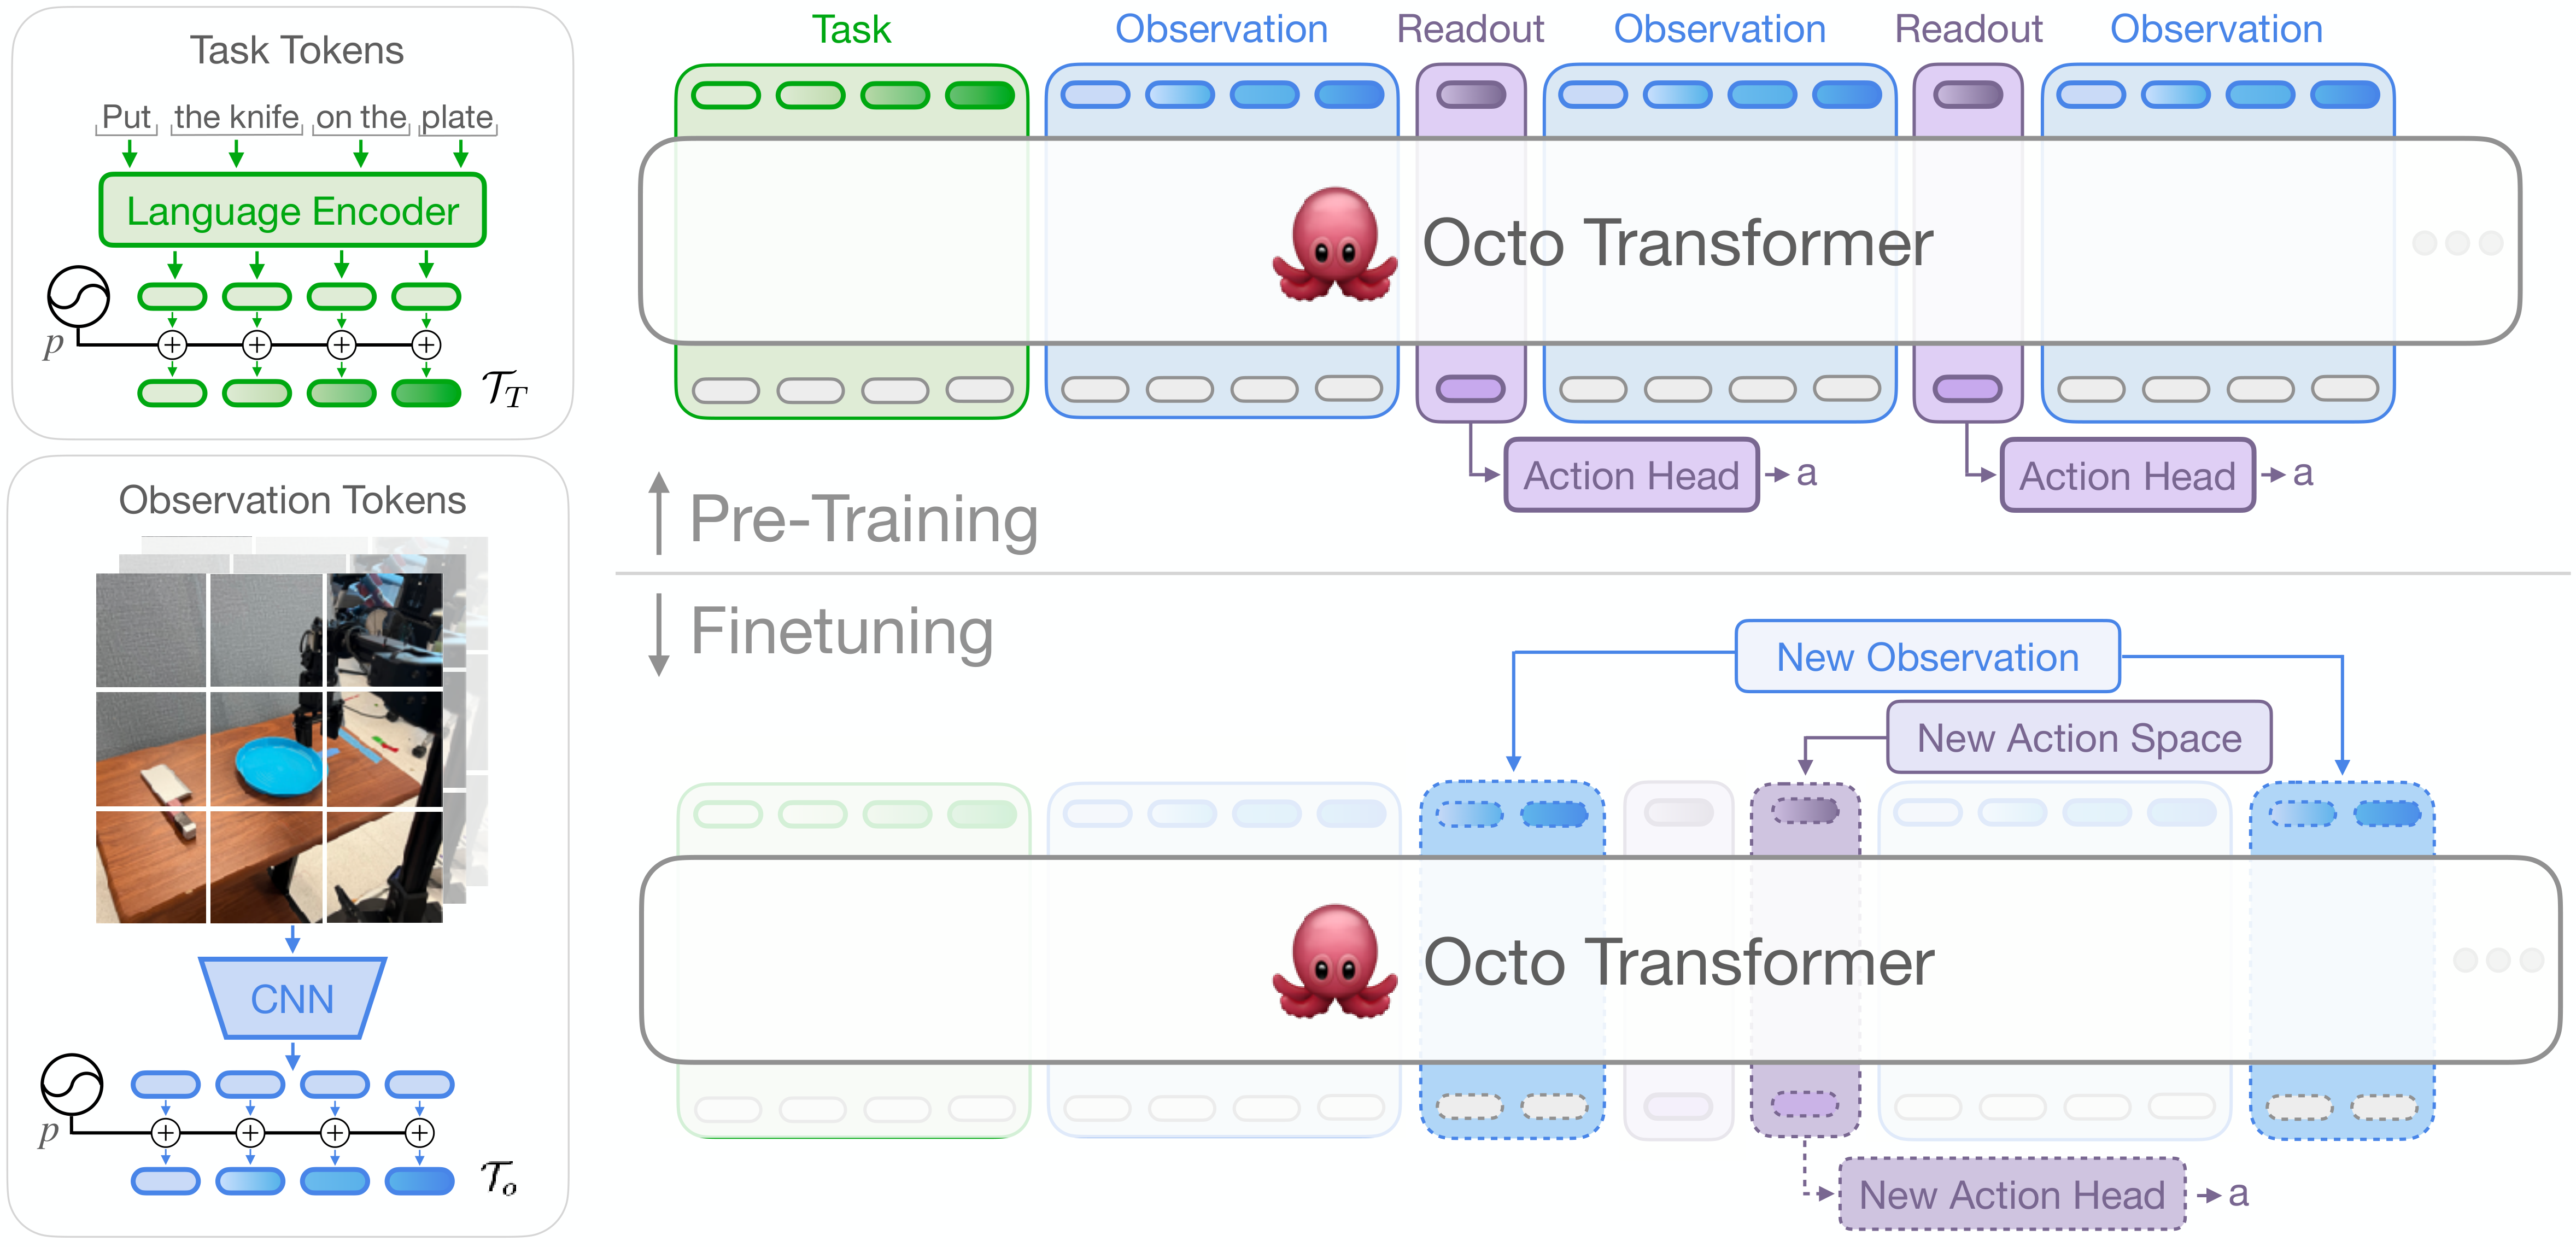
- 模块化输入:task tokens(语言 / 目标图像)+ observation tokens(图像 + 本体感觉),送入 Transformer backbone。
- 扩散动作头:接在 readout token 上的扩散头,输出连续多模态动作(动作块,预测未来 4 步)。
- readout token + 块状注意力(block-wise attention):readout token 只「读」前面的观测/任务 token 而不被它们读,从而可以增删观测/任务/头而不扰乱已训练 token 的语义——这是 Octo 易扩展的关键。
- 规模与组件:Octo-Small 27M / Octo-Base 93M;语言用 T5-base;图像 tokenizer 是浅层卷积 + patch(并非 ResNet/ViT)。
- 微调:论文实验推荐更新全模型,结果优于冻结部分参数;readout 与 block 设计主要用于方便增加输入和输出接口,不代表默认冻结 backbone。
Experiments
- 预训练数据:Open X-Embodiment,25 个数据集的精选混合,约 80 万条 episode(应表述为「25 个数据集、覆盖多种 embodiment」,而非「25 个 embodiment」)。
- 对比:论文在其评测集合中报告相对 RT-1-X(35M)平均提高约 29%,并取得与 RT-2-X(55B)相近的汇总结果。模型规模相差约 600 倍,但训练数据、结构与任务设置仍需同时考虑。
- 动作头消融:扩散头在多模态任务上明显优于 MSE / 离散 token 头(方向明确;具体百分比以论文表格为准)。
- 真机:9 套真机 / 4 家机构,含 WidowX、UR5、Franka;零样本 WidowX 约 0.50,微调后 6 任务平均约 0.72。
Strengths and Limitations
Strengths:Octo 同时公开权重、训练代码和数据管线,覆盖多种机器人本体;模块化接口便于适配新观测与动作空间。论文/代码报告的 27M–93M 规模和 RTX 4090 吞吐应结合 batch size、精度、输入尺寸以及训练或推理模式理解,不能作为跨实现的统一速度。
局限(分析):与规模更大的 RT-2-X 相比,OpenVLA 在论文选定的评测中表现相当,但难任务的绝对成功率仍有限;模型对相机和观测配置敏感,语言 grounding 受冻结 T5-base 能力约束,混合异构动作空间仍具挑战。
Takeaways
Octo 与 OpenVLA 是开源双子星:前者轻量、微调快、偏几何/操作泛化;后者重 VLM、偏语义。Octo 的 readout/块状注意力是一种优雅的「可扩展 Transformer」工程范式。
OpenVLA
OpenVLA: An Open-Source Vision-Language-Action Model
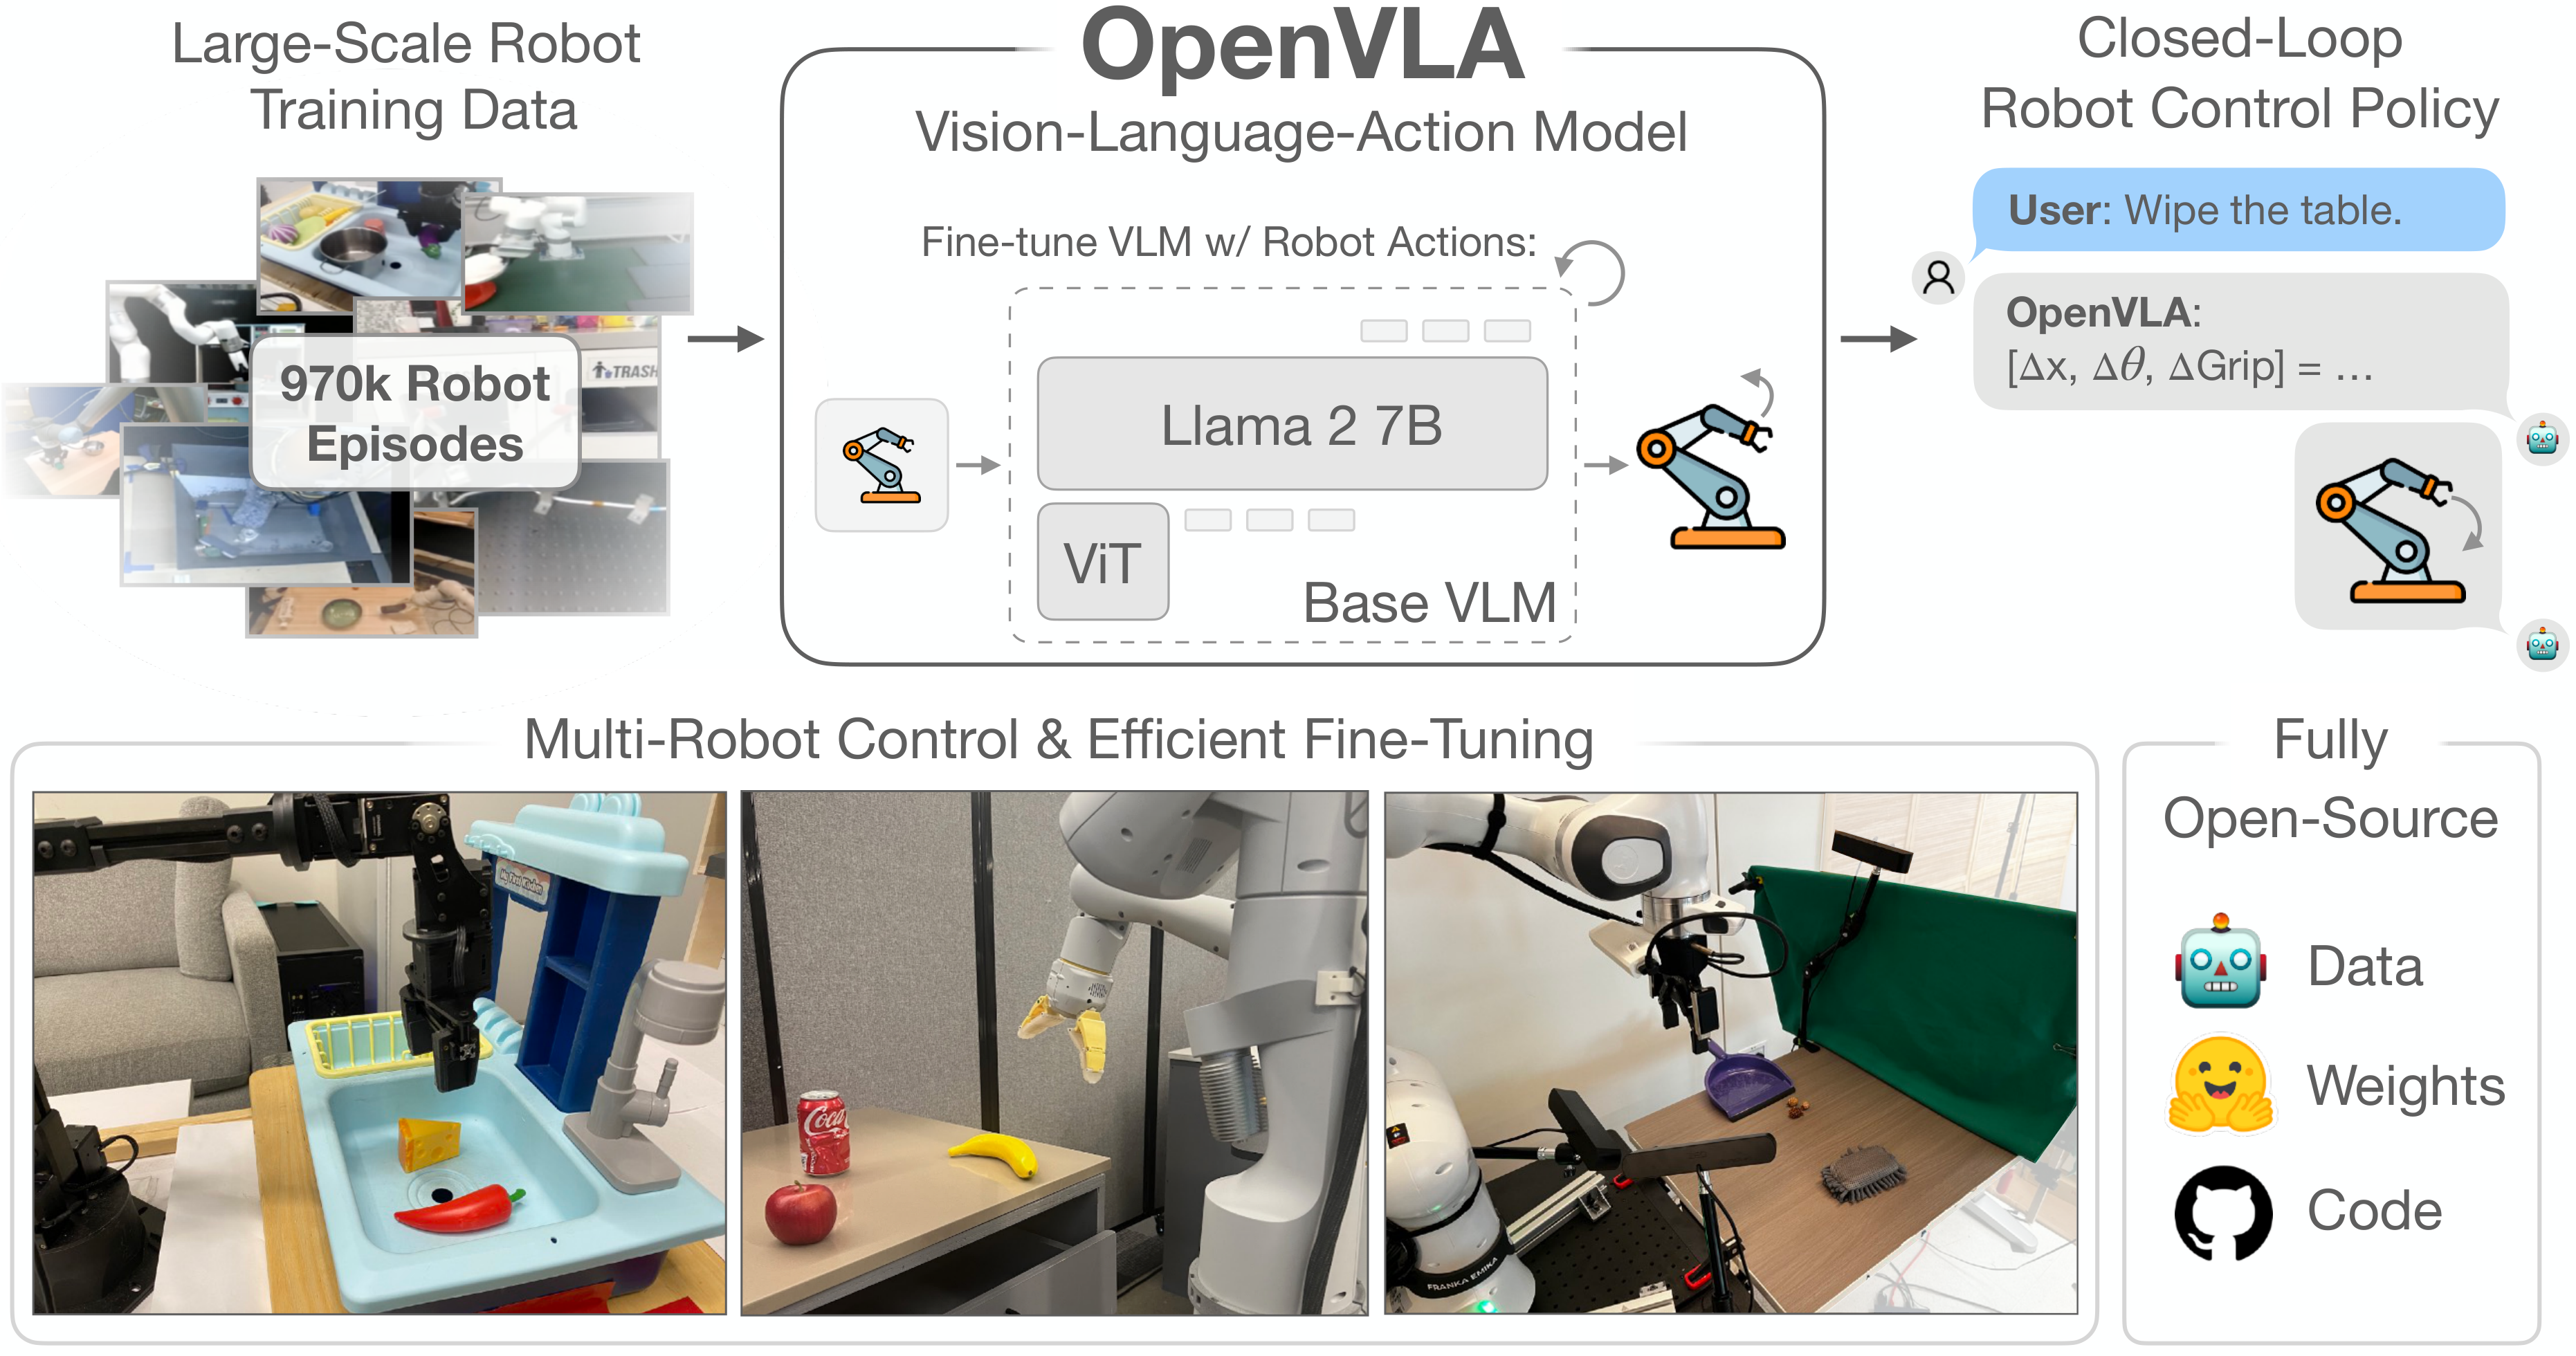
一句话开源 7B 级 VLA:SigLIP + DINOv2 双视觉编码器 + Llama 2 语言骨干,在 97 万条真机示范上做动作微调,可用 LoRA 在消费级 GPU 上适配。
会议 / 年份 CoRL 2024 | 机构 Stanford · UC Berkeley · TRI · Google DeepMind · Physical Intelligence · MIT | 方向 开源 VLA | 真机 ✅ WidowX · Google robot · Franka
BibTeX
@inproceedings{kim2024openvla,
  title     = {OpenVLA: An Open-Source Vision-Language-Action Model},
  author    = {Kim, Moo Jin and Pertsch, Karl and Karamcheti, Siddharth and Xiao, Ted
               and Balakrishna, Ashwin and Nair, Suraj and Rafailov, Rafael and Foster, Ethan
               and Sanketi, Pannag and Vuong, Quan and Kollar, Thomas and Burchfiel, Benjamin
               and Tedrake, Russ and Sadigh, Dorsa and Levine, Sergey and Liang, Percy and Finn, Chelsea},
  booktitle = {Conference on Robot Learning},
  year      = {2024},
  url       = {https://arxiv.org/abs/2406.09246}
}
论文元数据:会议为 CoRL 2024,作者列表与机构以上方论文链接为准。
Motivation
RT-2/RT-2-X 这类 VLA 闭源、难以适配。OpenVLA 提供一个开源 7B VLA,在大规模真机数据上训练,重点是易微调(含 LoRA、消费级 GPU)与跨 embodiment 泛化,作为闭源方案的开放替代。
Method
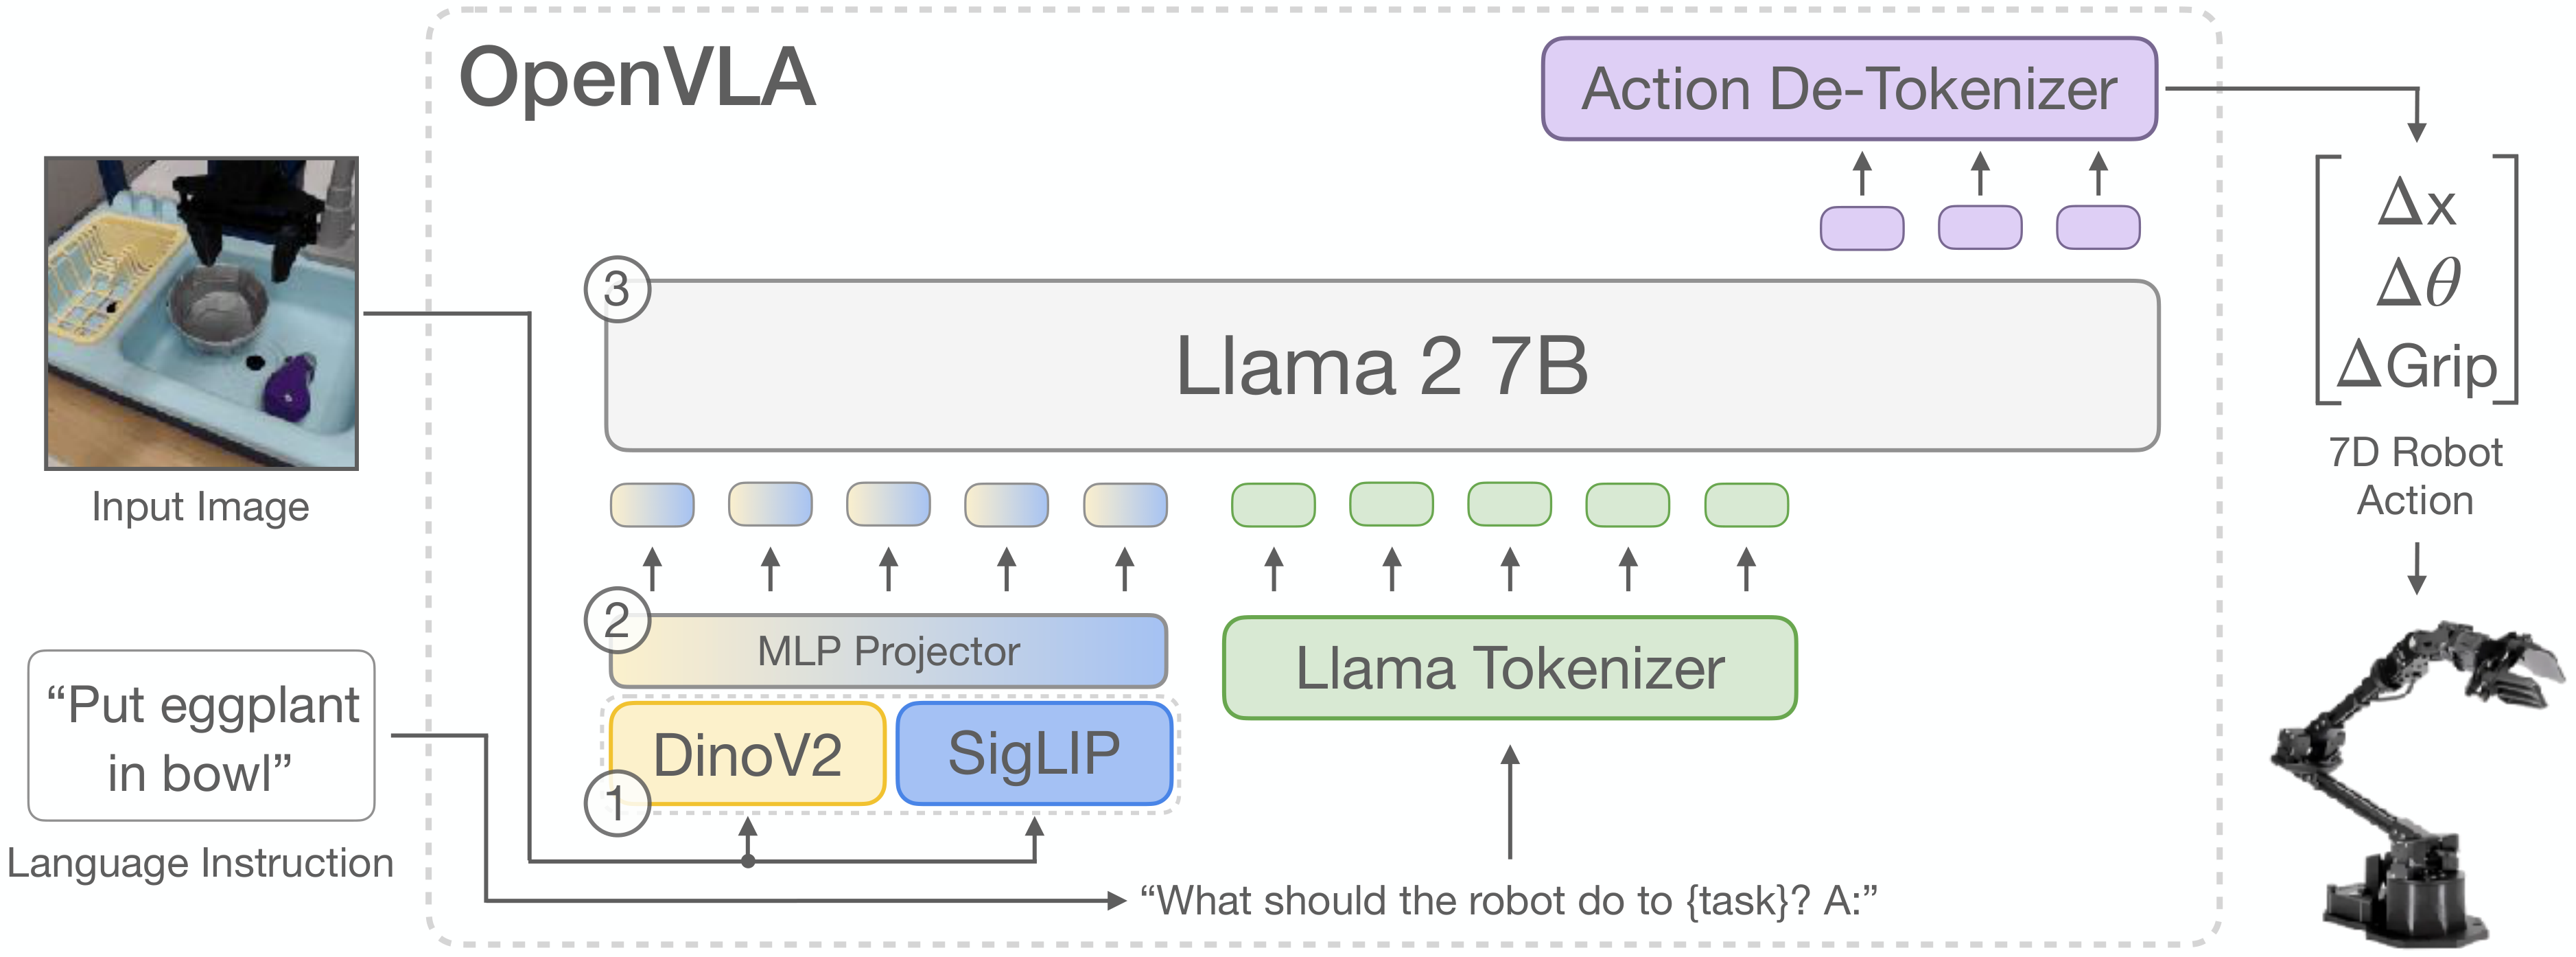
- 双视觉编码器:**SigLIP(偏语义)+ DINOv2(偏空间/几何)**的 patch 特征在通道维拼接,过 MLP 投影后送入 Llama 2 7B;整体基于 Prismatic-7B VLM。
- 动作 token 化(沿用 RT-2):每维 256 bin(取训练动作 1–99 分位内均匀离散),7-DoF → 7 个 token/步,实现上覆写 Llama 词表中最少用的 256 个 token。
- 单帧输入:仅当前一帧图像、无历史(论文明确列为局限)。
Experiments
- 数据/算力:Open X-Embodiment 的 97 万条轨迹(70+ 数据集混合),64 张 A100 训练 14 天。
- 主结果:在跨 29 个任务、多 embodiment 的通才评测上,OpenVLA(7B)以约 16.5 个百分点(绝对值) 超过 RT-2-X(55B),参数量约为其 1/7。
- 推理与量化:论文在 RTX 4090、bf16、约 15GB 显存设置下报告约 6 Hz。其量化实验中 bf16 为 71.3%、INT4 为 71.9%(约 7GB)、INT8 约为 58%;这些结果限于对应实现与评测集合。
- 微调:LoRA(约 97.6M 参数)可与全参数微调持平。
- 消融:论文比较了不同 base VLM、输入分辨率和是否微调视觉编码器;正文不引用论文表格中不存在的单编码器移除数值。
- 真机:WidowX(BridgeData V2,170 rollouts/17 任务)、Google robot(60/12)、Franka(5Hz/15Hz 两套)。
Strengths and Limitations
Strengths:全开源(权重/代码/数据混合),可复现;7B 超过 55B 的 RT-2-X 达 16.5pp;LoRA 微调 + 4-bit 量化让消费级 GPU 可用(约 7GB);跨 embodiment。
局限(分析):仅单帧观测(无历史、无多视角、无本体感觉融合);约 6 Hz 吞吐对高频(如 50Hz)控制偏慢;多数任务成功率仍 <90%,尚不足生产级。
Takeaways
OpenVLA 把 VLA 拉进开源生态,成为社区默认基线之一;其单帧、离散动作、约 6Hz 的三个约束,正是后续工作(连续/扩散动作头、加入历史、轻量化)的改进方向。
RDT
RDT-1B: a Diffusion Foundation Model for Bimanual Manipulation
一句话把扩散策略推到十亿参数级的双臂基础模型:1.2B 的 DiT 类去噪 Transformer + 统一动作空间,衔接异构机器人数据,强调零样本与少样本语言跟随。
会议 / 年份 ICLR 2025 | 机构 清华大学(TSAIL)| 方向 双臂扩散基础模型 | 真机 ✅ ALOHA 双臂
BibTeX
@inproceedings{liu2025rdt,
  title     = {{RDT-1B}: a Diffusion Foundation Model for Bimanual Manipulation},
  author    = {Liu, Songming and Wu, Lingxuan and Li, Bangguo and Tan, Hengkai and Chen, Huayu
               and Wang, Zhengyi and Xu, Ke and Su, Hang and Zhu, Jun},
  booktitle = {International Conference on Learning Representations},
  year      = {2025},
  url       = {https://arxiv.org/abs/2410.07864}
}
Motivation
双臂操作缺大规模数据,且两臂协调难。RDT 想把扩散 Transformer 扩到 1.2B,用统一动作空间在最大规模的多机器人数据上预训练,再用自采双臂数据微调,追求对未见物体/场景的零样本泛化、语言跟随,以及 1–5 条示范的少样本学习。
Method
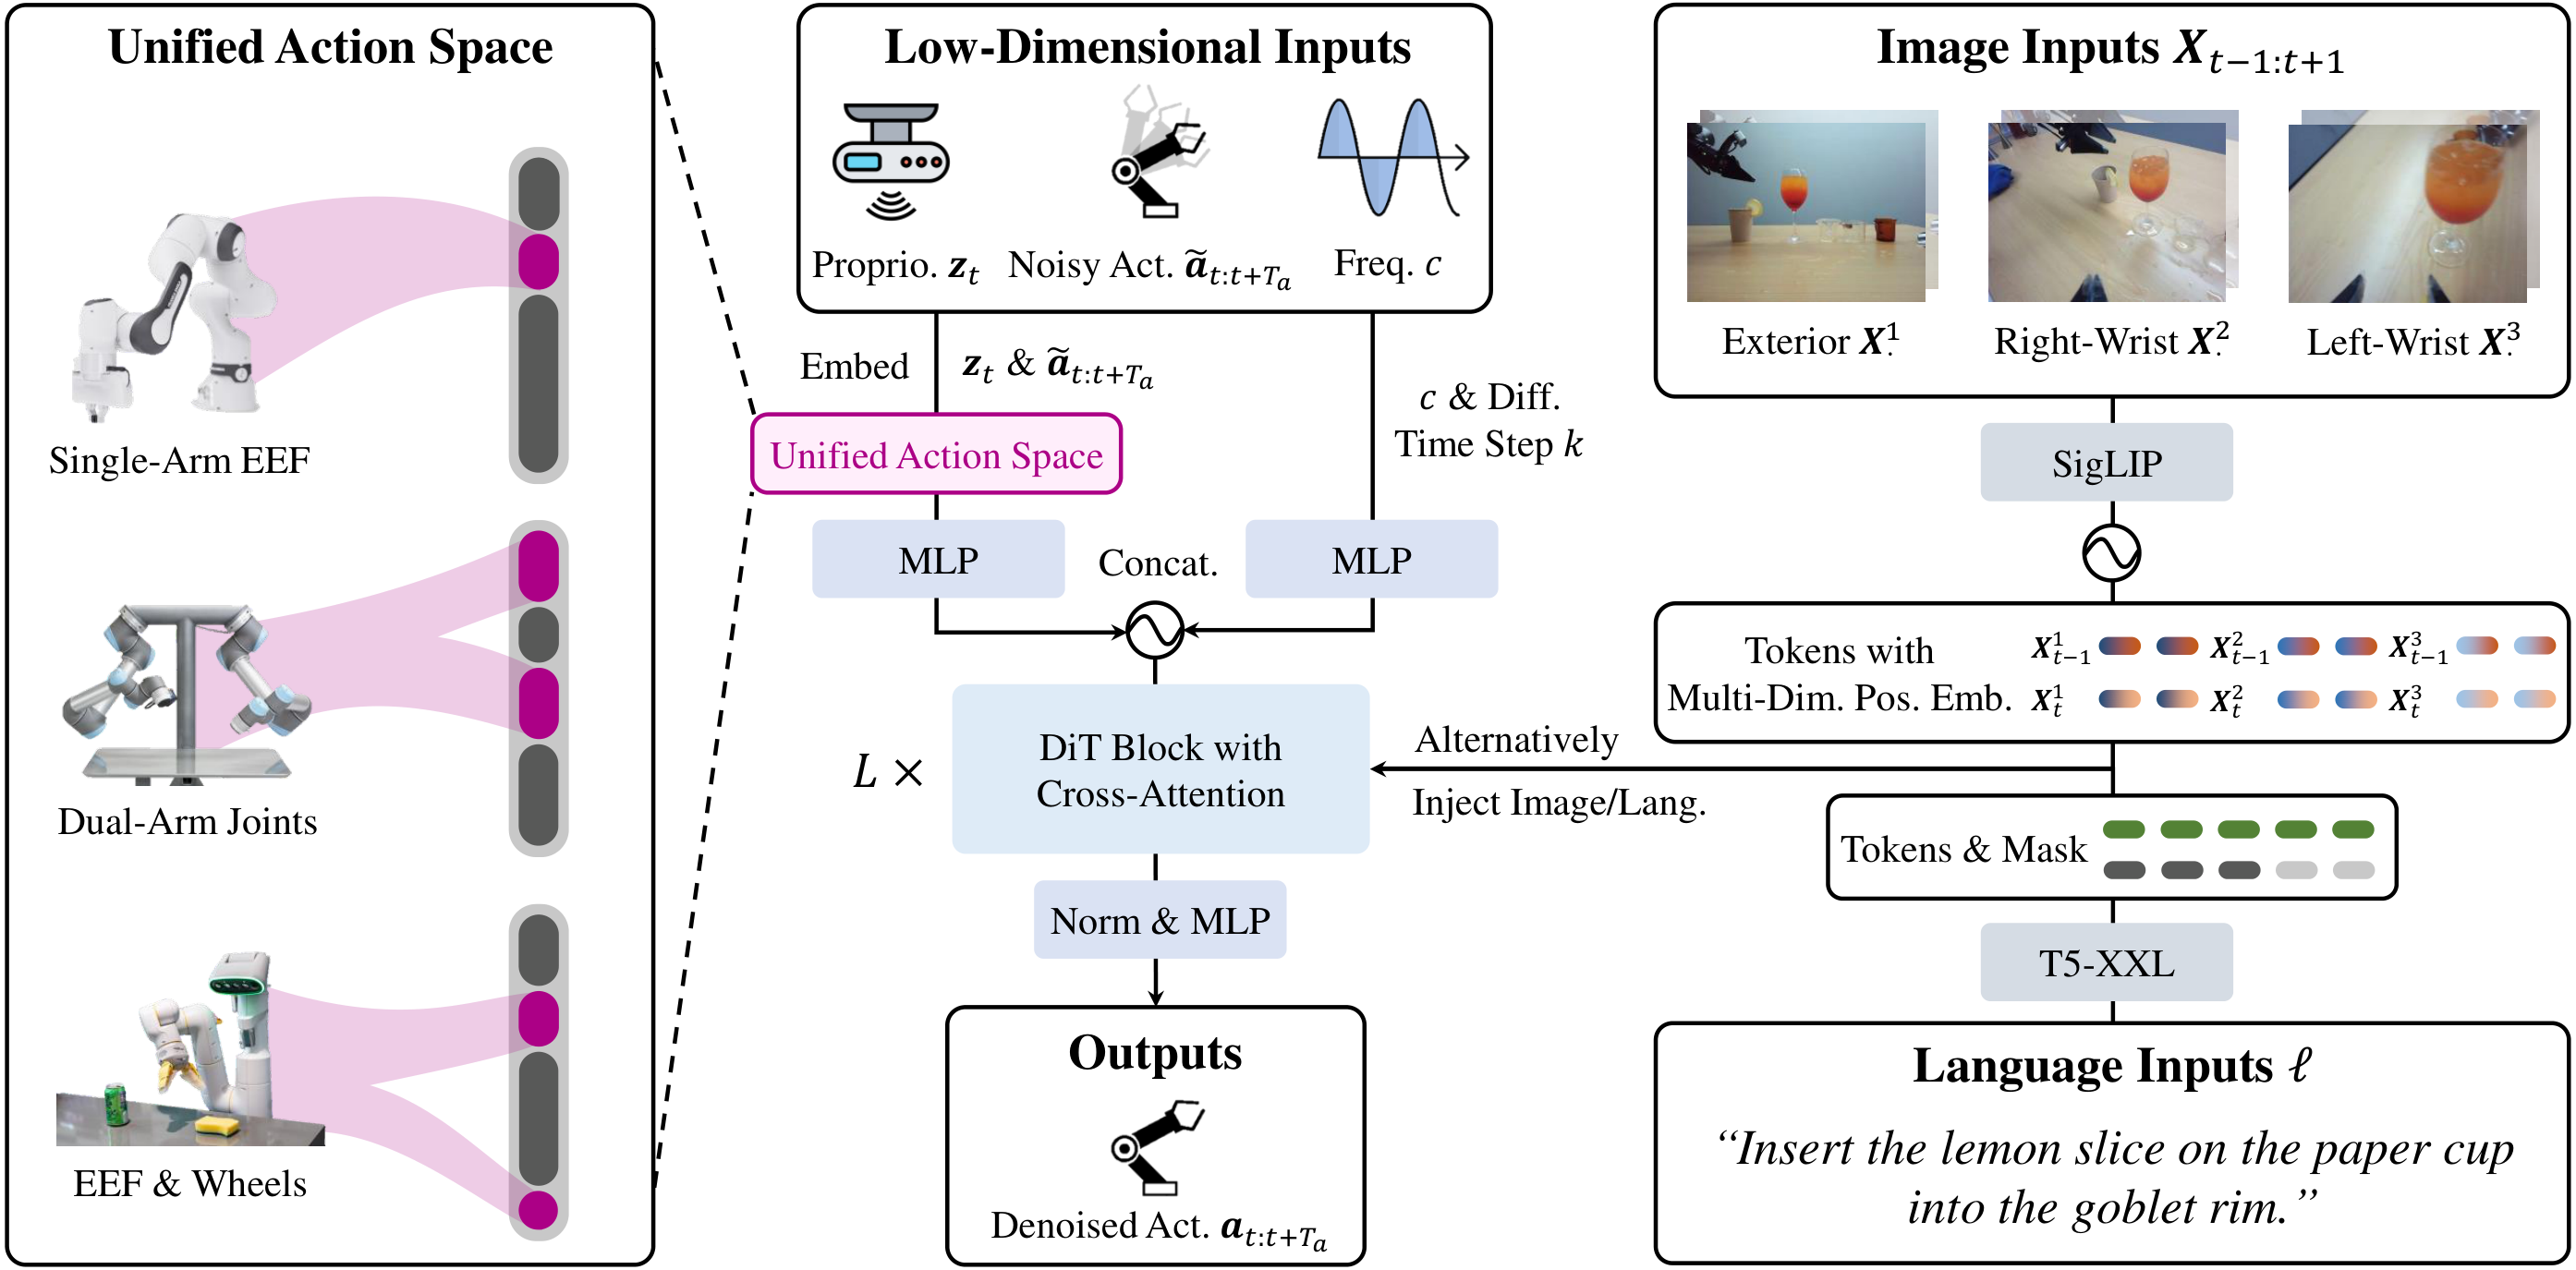
- 1.2B DiT 类去噪网络:以图像、语言、本体状态为多模态条件,对噪声动作 token 去噪。
- 扩散形式:使用 DDPM(离散时间扩散),目标为预测干净动作(sample prediction),采样采用 DPM-Solver++;它不是 flow matching。
- 条件编码器:语言使用 T5-XXL,图像使用 SigLIP,不包含 DINOv2。
- 统一动作空间:用物理含义一致的动作向量表示异构机器人,并通过 zero-padding 与 mask 对齐不同动作维度。
- 条件注入:使用 cross-attention 与 Alternating Condition Injection(ACI),图文 token 在相邻层交替注入,并结合 QKNorm、RMSNorm 和非线性 MLP 解码头;动作块长度为 64。
- 微调:论文采用全模型微调,而不是只训练局部动作头。
Experiments
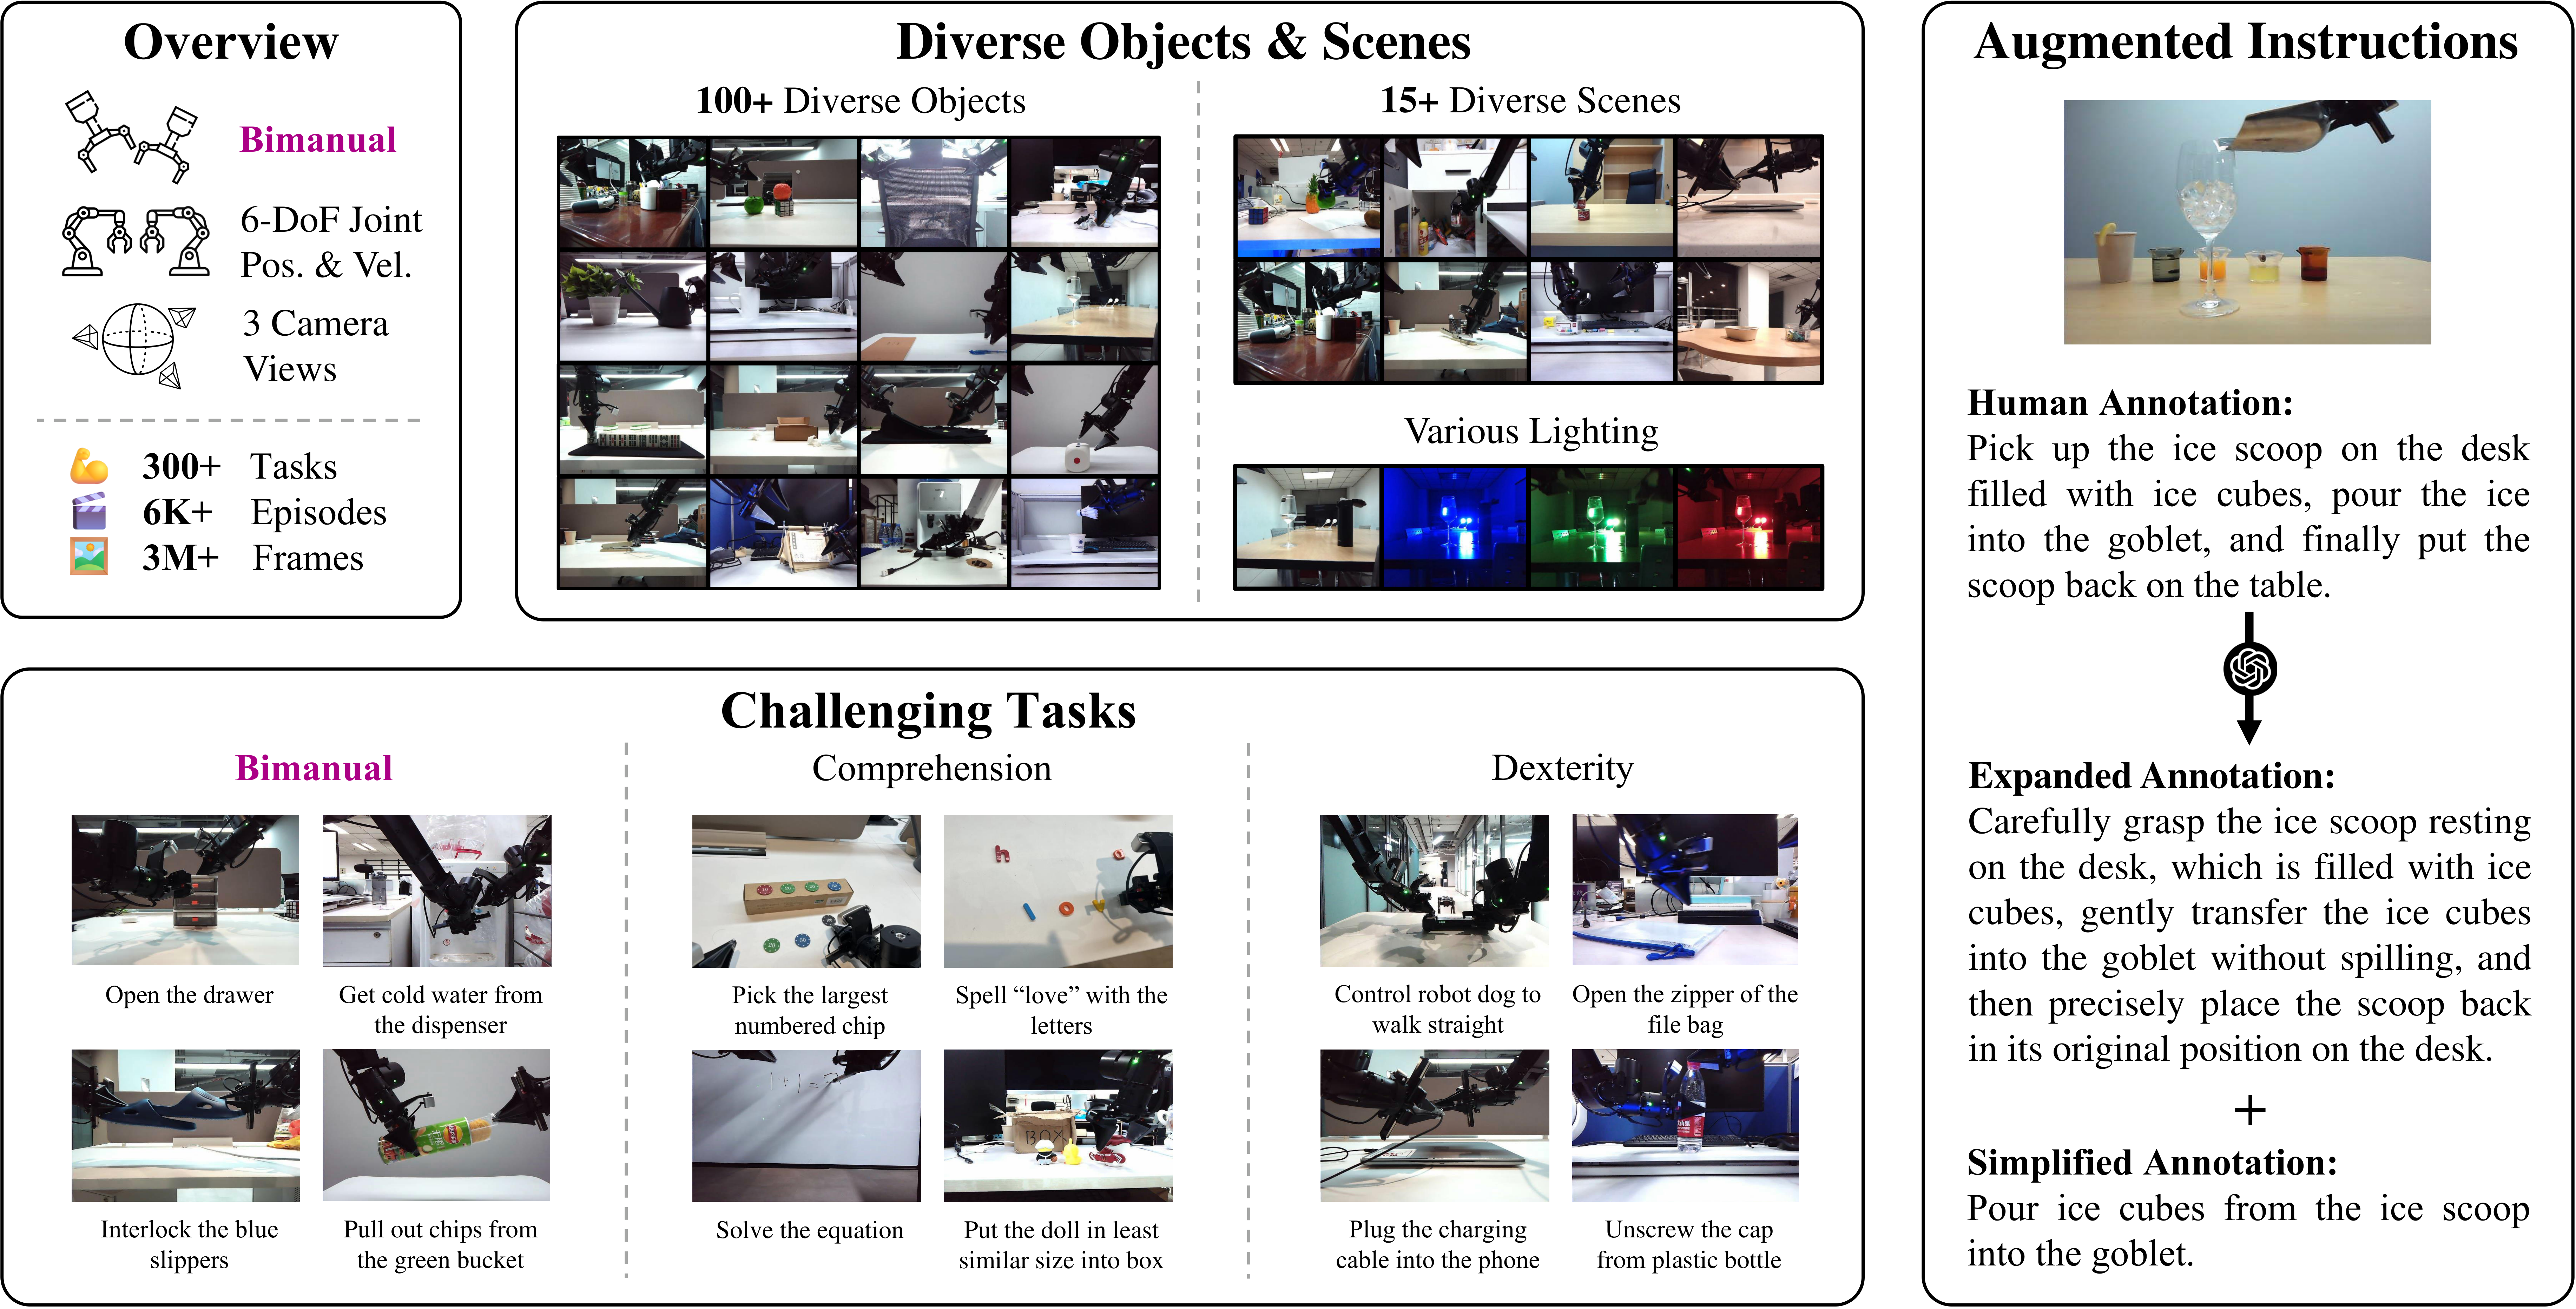
- 数据:预训练 46 个数据集、100 万+ 轨迹;微调 6000+ 条自采 ALOHA 双臂 episode。
- Baseline:论文对比 ACT、OpenVLA 和 Octo。真机结果举例:
| 任务 | RDT | ACT | OpenVLA |
|---|---|---|---|
| Wash Cup | 87.5% | 0% | 0% |
| Pour Water | 62.5% | 37.5% | 0% |
| 机器狗灵巧任务 | 48% | 32% | 0% |
下列数字只对应论文实际列出的任务与基线,不把不同任务或实验设置的结果合并比较。
- 消融:小模型为 166M(非「200M」);小→1.2B 时,Unseen Object 37.5%→50%、Instruction Following 25%→100%(Unseen Scene 持平)。
- 零样本:对未见物体/场景有一定零样本能力。
Strengths and Limitations
Strengths:当时最大的扩散操作基础模型(1.2B);统一物理动作空间支持异构多机预训练(46 数据集、100 万+ 轨迹);少样本(1–5 条)与零样本泛化强,难双臂任务上大幅领先 ACT/OpenVLA/Octo;DPM-Solver++ 支持近实时(约 6 Hz/块)。
局限(分析):真机评测局限于单一 ALOHA 类双臂平台、任务集不大(每任务试验数少,如 n=8 → 12.5% 粒度较粗);全模型微调成本高、无轻量适配;最难任务的绝对成功率仍中等(如灵巧任务 48%)。
Takeaways
RDT 代表「DP 路线的 scaling up」:把轻量扩散头换成十亿级 DiT,并用统一动作空间打通异构数据。它与 π0(Flow Matching + VLM)形成扩散基础模型的两种技术选型对照。
Cross-Paper Comparison
| 论文 | 核心思想 | 学习范式 | 优势 | 局限(分析) |
|---|---|---|---|---|
| ACT | 动作块 + CVAE | Imitation(CVAE) | 样本高效、抑制复合误差 | 短时程、单 embodiment |
| DP | 扩散建模动作分布 | Imitation(Diffusion) | 多模态、训练稳 | 迭代去噪较慢 |
| DP3 | 点云 + 轻量 3D 编码器 | Imitation(Diffusion, 3D) | 几何泛化、极轻编码器 | 依赖深度质量 |
| RT-1 | 大数据 + 动作 token | Imitation(Transformer) | 真机 scaling 验证 | 采集贵、无 web 知识 |
| RT-2 | VLM 输出动作 token | VLA(co-fine-tune) | 语义泛化/推理涌现 | 巨大、慢、闭源 |
| Octo | 模块化 Transformer + 扩散头 | 开源通才(Diffusion head) | 全开源、微调快、轻量 | 语言 grounding 受限 |
| OpenVLA | 双视觉编码器 + Llama 2 | 开源 VLA(离散 token) | 7B 超 55B、可 LoRA/量化 | 单帧、约 6Hz 偏慢 |
| RDT | 十亿级 DiT + 统一动作空间 | 双臂扩散基础模型 | 大规模、少/零样本强 | 单平台评测、微调贵 |
Discussion
把八篇放在一起看,可以梳理出几条趋势:
-
动作表示是主线。从回归 → CVAE(ACT)→ 扩散(DP/DP3/Octo/RDT)→ 离散 token(RT-1/RT-2/OpenVLA),本质都在解决同一件事:如何表达示范里的多模态分布。扩散与离散 token 目前是两大主流,各有取舍——扩散连续、精度高但迭代慢,token 化契合自回归 VLM 但受 bin 精度限制。
-
action chunking + receding horizon 是常见设计。 ACT 与 Diffusion Policy 展示了动作块预测和滚动执行的优势,后续不少策略沿用该结构;单步策略、自回归动作 token 和分层控制仍然并存。
-
Scaling 有两条路。一条是「数据规模化」(RT-1 用真机数据、RDT 用异构数据 + 统一动作空间);另一条是「知识迁移」(RT-2/OpenVLA 复用互联网级 VLM)。两者互补:前者教会「怎么动」,后者带来「懂语义」。
-
开源模型降低了复现与适配门槛。 Octo 和 OpenVLA 提供权重与训练工具,并在各自论文的若干匹配评测中取得有竞争力的结果。OpenVLA 7B 与 RT-2-X 55B 的参数量不能单独说明整体能力高低,比较必须限定在相同任务、数据和指标下。
这些工作提供了几项可继续验证的方向:3D 表征是否能改善接触密集任务的泛化,统一动作空间能否有效复用异构数据,以及连续生成动作头在实时性与多峰表达之间如何取舍。后续文章将分别比较这些设计的证据与限制。