
Overview
本篇聚焦 Physical Intelligence(PI,π) 一家公司围绕机器人基础模型(robot foundation model)的系列工作。与 Robot Learning (1) 横向对比不同方法不同,这里是一条同一团队、同一底座(π0)逐步演进的技术线,适合连着读。
PI 的核心主张是:用一个 VLM 骨干 + flow matching 动作专家 的 VLA,在超大规模跨本体真机数据上预训练,得到一个「告诉它做什么就能做」的通用策略。围绕这个底座,后续工作分别解决了几个具体问题:
- π0 — 奠定 flow matching VLA 底座,做到 50Hz 连续动作、跨本体、长时程灵巧操作。
- FAST — 让自回归 VLA 也能学高频灵巧动作(频域动作 token 化),训练更快。
- Knowledge Insulation (KI) — 解决「加连续动作专家会冲刷 VLM 预训练知识」的训练难题。
- π0.5 — 面向开放世界泛化:进到从没见过的真实家庭里干活。
- Real-Time Chunking (RTC) — 解决大模型 VLA 的实时执行:消除动作块边界的卡顿。
- Hi Robot — 分层 VLA,处理开放式复杂指令与实时人类反馈。
- π*0.6 (RECAP) — 从经验(自主试错 + 专家纠正)中学习,超越纯模仿。
- RLT (RL Token) — 从 VLA 里挤出一个「RL token」瓶颈表示,挂上轻量 actor-critic 做在线 RL,几分钟到几小时真机数据就把最难的高精度环节练到超越遥操作。
- π0.7 — 可操控(steerable)的通才:多模态条件指定「怎么做」;官方报告展示了组合泛化与跨本体迁移的初步结果。
一条主线贯穿始终:如何把「大模型的语义知识」与「机器人的连续实时控制」这两件本质冲突的事,工程化地缝合到一起。
Paper List
| 简称 | 年份 / Venue | 主题 | 关键载体 | 核心思想 |
|---|---|---|---|---|
| π0 | arXiv 2024 / RSS 2025 | Flow VLA 底座 | PaliGemma 3B + 动作专家 | flow matching 生成 50Hz 连续动作块 |
| FAST | arXiv 2025 | 动作 token 化 | π0-FAST | DCT+BPE 频域压缩,自回归也能学高频 |
| KI | arXiv 2025 | 训练配方 | π0 | stop-gradient + 离散共训,护住 VLM 知识 |
| π0.5 | arXiv 2025 | 开放世界泛化 | π0.5 | 异构 co-training + 分层推理,进新家干活 |
| RTC | NeurIPS 2025 | 实时执行 | π0.5 | 把换块建模成 inpainting,异步无卡顿 |
| Hi Robot | ICML 2025 | 分层 / 开放指令 | π0 | System 2 拆解指令,System 1 执行 |
| π*0.6 | 技术报告 2025 | 从经验学习 | π0.6 (5B) | RECAP:advantage 条件化 RL |
| RLT | 技术报告 2026 | 在线 RL 精调高精度 | 冻结 VLA + RL token | 挤出瓶颈表示喂 actor-critic,编辑而非替换动作 |
| π0.7 | 技术报告 2026 | 可操控通才 | 跨本体 | 多模态条件 + 从专家蒸馏,组合泛化 |
Pi0
π₀: A Vision-Language-Action Flow Model for General Robot Control
一句话PI 的 VLA 底座:在 VLM(PaliGemma)之上接一个 flow matching 动作专家,用超过 1 万小时的跨本体真机数据预训练,输出 50Hz 连续动作块,做长时程灵巧操作。
年份 / Venue arXiv 2024(关联 RSS 2025)| 机构 Physical Intelligence | 方向 Flow-matching VLA, cross-embodiment | 真机 ✅ 7 种机器人配置(单臂 / 双臂 / 移动)
BibTeX
@article{black2024pi0,
  title   = {{\(\pi_0\)}: A Vision-Language-Action Flow Model for General Robot Control},
  author  = {Black, Kevin and Brown, Noah and Driess, Danny and others},
  journal = {arXiv preprint arXiv:2410.24164},
  year    = {2024},
  url     = {https://arxiv.org/abs/2410.24164}
}
Motivation
今天的机器人多是「窄专家」,换个任务就要大量人工工程。PI 想要一个机器人基础模型:编程新行为简单到只需用语言告诉它做什么。挡在前面的是三件事——数据、泛化、鲁棒性。相比 RT-2/OpenVLA 把动作离散成 token,PI 主张用连续高频动作来支撑灵巧操作:token 离散化很难在 50Hz、高维动作上保住精度。
Method
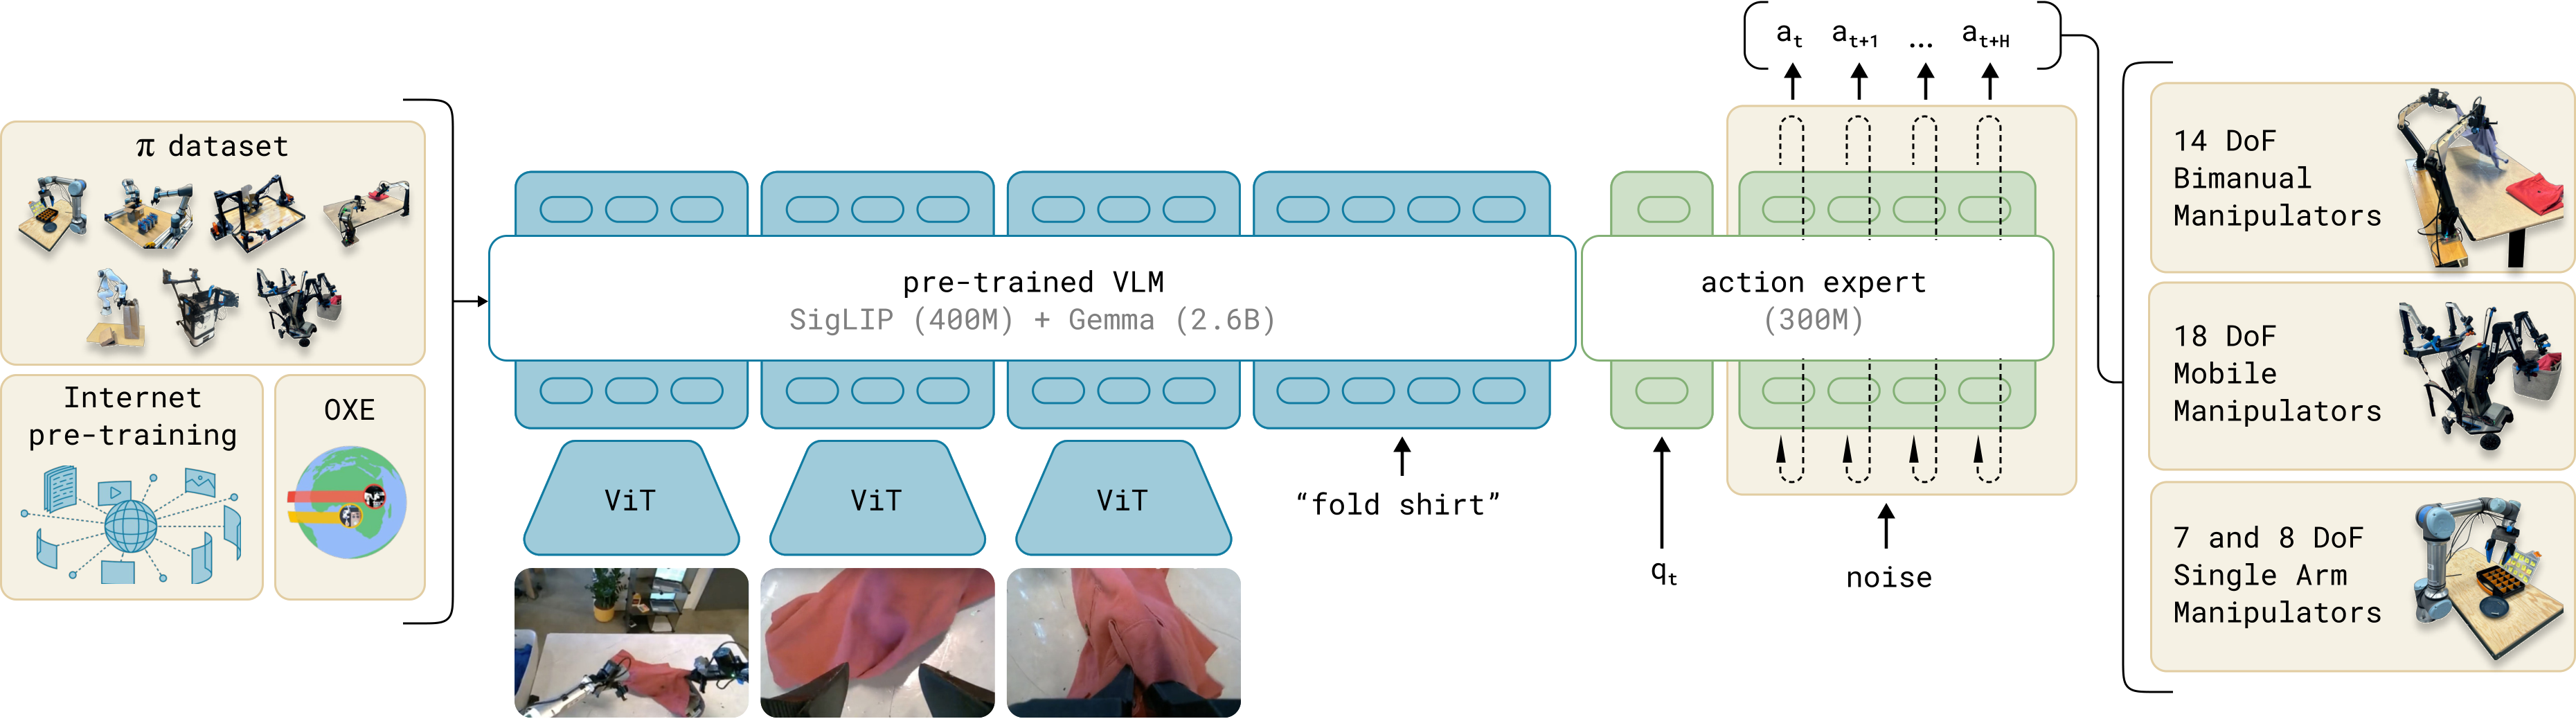
- VLM 骨干:PaliGemma(约 3B),继承互联网级视觉–语言语义知识。
- 动作专家(action expert):一个从零初始化的约 300M 模块(总计 3.3B),读取 VLM 特征、用 flow matching 产生动作。
- flow matching:在噪声与真实动作块之间构造线性高斯路径,网络回归从含噪动作指向干净动作的向量场(速度);推理时从噪声出发做 10 步积分得到动作块。它可看作扩散模型的一个变体,但直接生成连续动作。
- 动作块 / 频率:动作视野 H = 50,输出可达 50Hz 的电机指令。
- 输入:多路 RGB 图像 + 语言 token + 本体状态 ;用 3 段式 blockwise 因果注意力把 VLM 输入与动作专家 token 分块,块内双向注意力。
Experiments
- 数据:超过 1 万小时、约 903M 时间步的自采数据 + 开源数据(开源占约 9.1%,含 OXE、Bridge v2、DROID);7 种机器人配置、自采集含 68 个任务。
- 任务:叠衬衫/叠衣(从篮子里)、清理餐桌(分餐具与垃圾)、折纸箱、装袋、冲咖啡等多分钟灵巧任务。
- Baseline:OpenVLA(7B,离散动作)、Octo(93M,扩散);并有 **π0-small(470M,无 VLM 预训练)**消融。
- 结果(官方自报):跨评测任务大幅领先,例如叠衬衫 π0 = 1.0 而 OpenVLA/Octo ≈ 0,「Bussing Hard」π0 ≈ 0.875 而对手 ≈ 0;完整架构相对无 VLM 变体约 >2×,印证互联网级预训练的价值。
Strengths and Limitations
Strengths:首次展示了此复杂度的叠衣等多分钟灵巧任务;一个模型横跨单臂/双臂/移动本体;flow matching 支撑 50Hz 连续控制;VLM 预训练带来 >2× 增益。
局限(分析):依赖未公开的超大自采数据集(1 万+ 小时),复现主要靠 openpi 权重而非全量数据;flow 推理需 10 步积分,成本高于单步策略;评测主要在 PI 自家硬件/任务上,跨外部本体的泛化尚未充分刻画。
Takeaways
π0 提供了本篇后续工作的共同起点。相关研究分别处理动作表示与训练效率(FAST/KI)、跨环境泛化(π0.5)、推理延迟与动作连续性(RTC)、交互式语言条件(Hi Robot),以及利用经验数据改进策略(π*0.6)。这些工作针对的问题和评测设置不同,不构成单一指标上的线性升级。
Pi0 FAST
FAST: Efficient Action Tokenization for Vision-Language-Action Models
一句话频域动作 token 化:对动作块做 DCT + 量化 + BPE 压缩,让自回归 VLA 也能学高频灵巧动作,训练比 flow 版快约 5×。
年份 / Venue arXiv 2025(会议未在 arXiv 页标注)| 机构 Physical Intelligence | 方向 Action tokenization, autoregressive VLA | 真机 ✅ 多种 UR5e / Franka / Trossen / 移动本体
BibTeX
@article{pertsch2025fast,
  title   = {{FAST}: Efficient Action Tokenization for Vision-Language-Action Models},
  author  = {Pertsch, Karl and Stachowicz, Kyle and Ichter, Brian and Driess, Danny
             and Nair, Suraj and Vuong, Quan and Mees, Oier and Finn, Chelsea and Levine, Sergey},
  journal = {arXiv preprint arXiv:2501.09747},
  year    = {2025},
  url     = {https://arxiv.org/abs/2501.09747}
}
Motivation
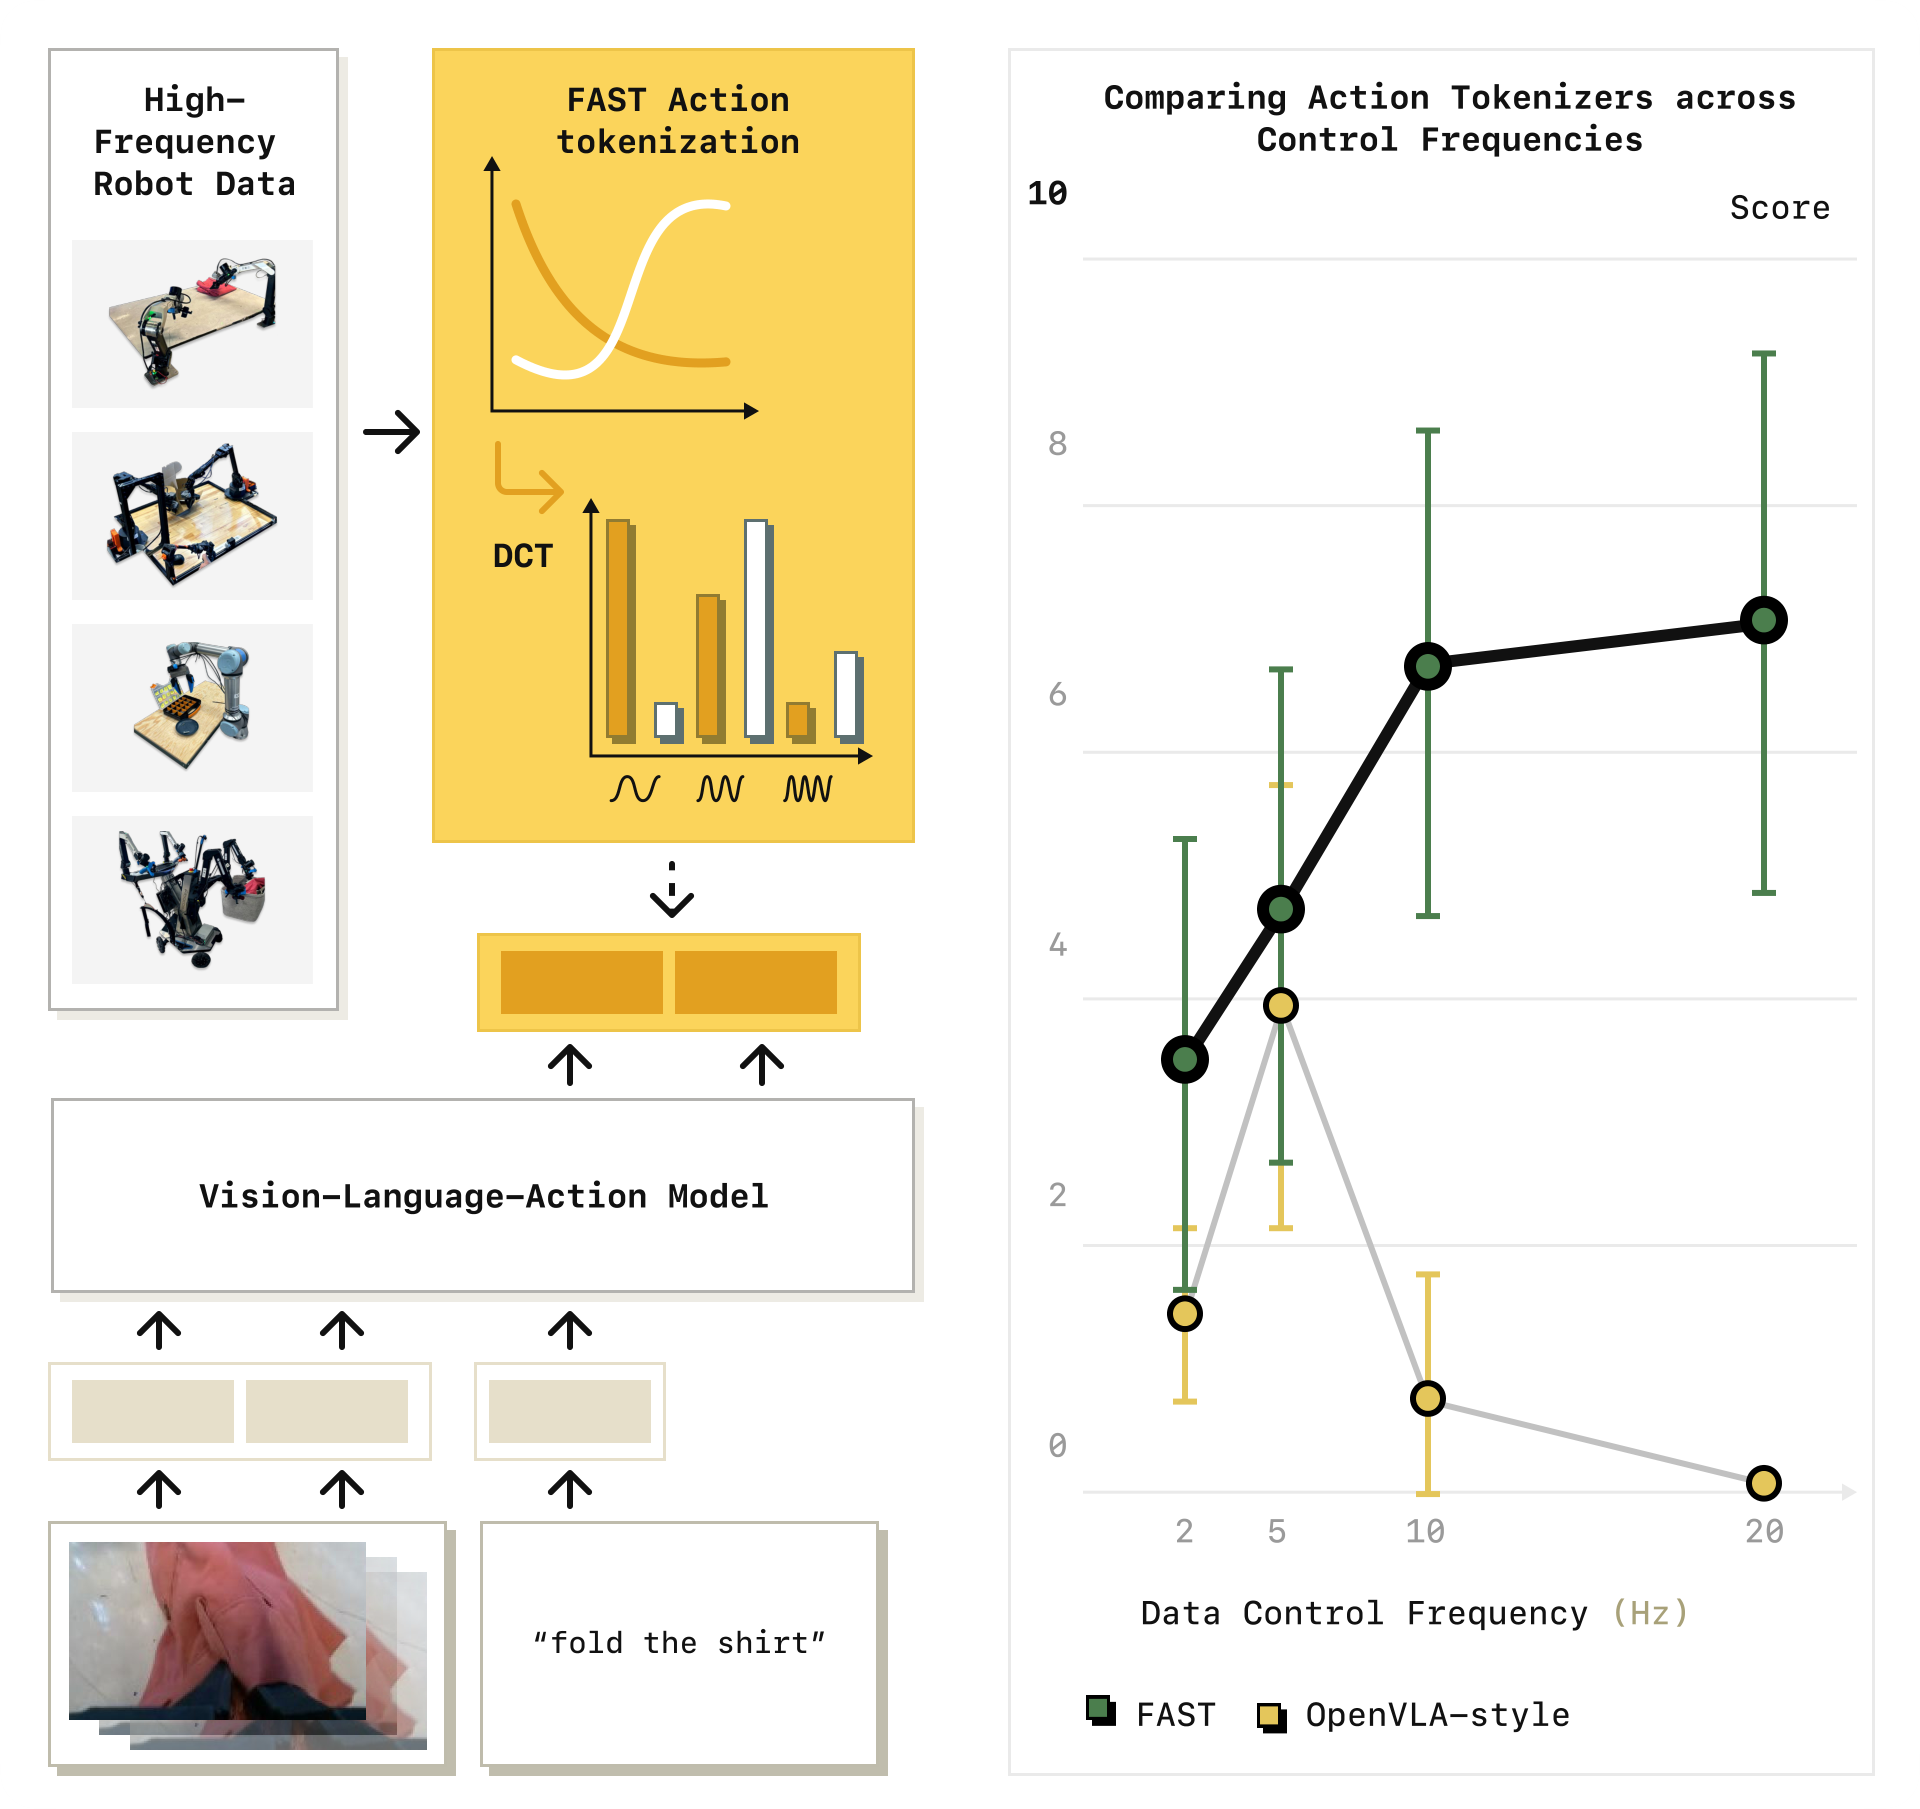
RT-2/OpenVLA 式的逐维逐帧均匀 binning 在高频真机数据上表现很差:50Hz 下相邻动作高度相关、逐帧变化很小,binning 产生冗长、低信息量的 token 序列,模型容易退化成「复制上一帧」。flow/diffusion 版(π0)能处理,但训练明显更慢。FAST 想让自回归 VLA 也能学好高频灵巧任务。
Method
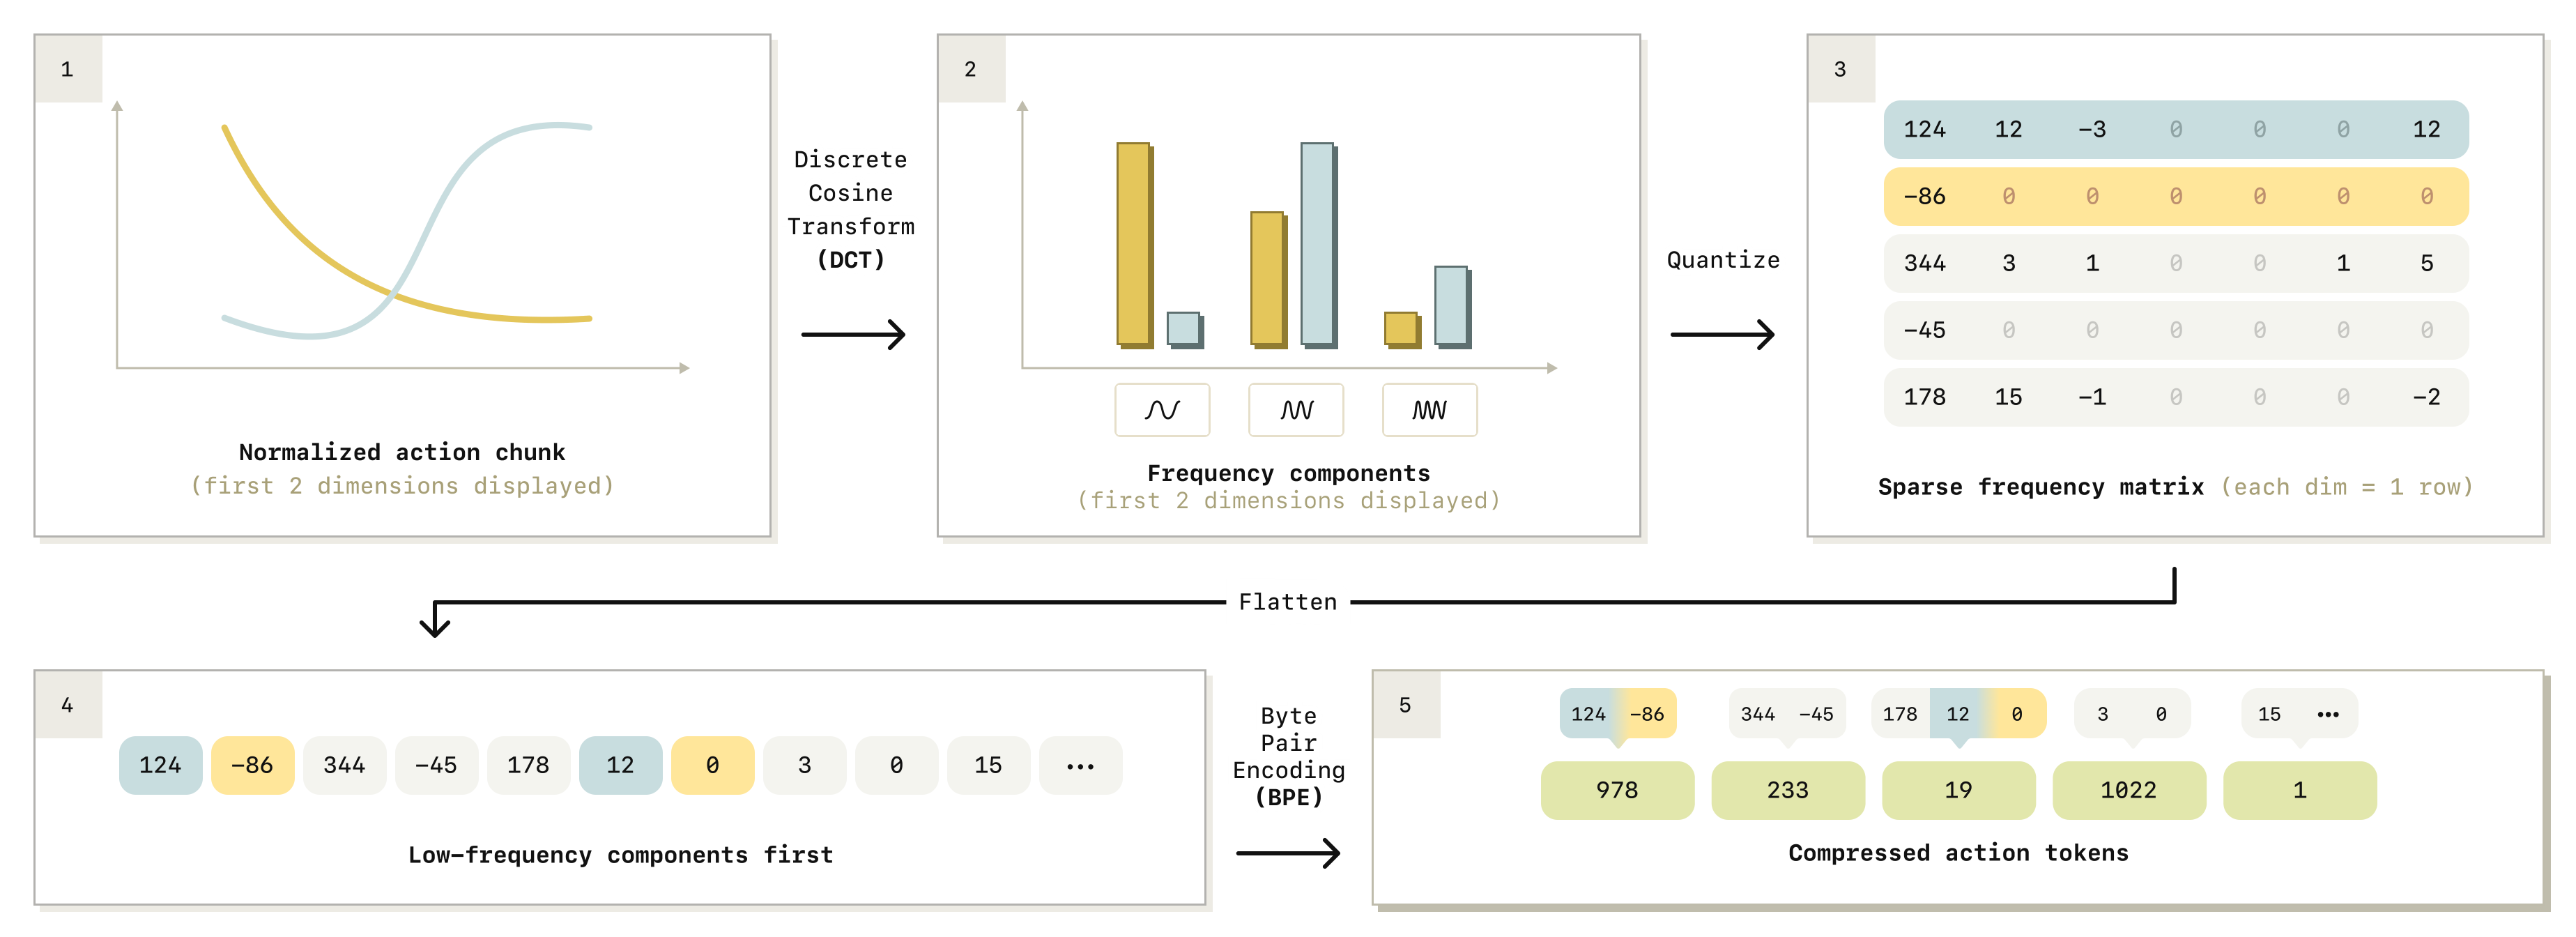
FAST = Frequency-space Action Sequence Tokenization,对动作块做一条压缩流水线:
- DCT(离散余弦变换):把动作块变换到频域(类比 JPEG 图像压缩)。
- 量化:降低 DCT 系数精度,得到以少数低频分量为主的稀疏矩阵。
- BPE(字节对编码):把量化系数流压成紧凑词表,相对 binning 约 10× 压缩,每个动作块约 30–60 个 token(而非数百)。
- FAST+:在 100 万条真机动作轨迹上训练的通用动作 tokenizer,可零样本用于不同动作空间与控制频率。
- π0-FAST:沿用 π0 的骨干与训练数据,把 flow/扩散解码换成对 FAST token 的自回归预测。
Experiments
- 训练效率:π0-FAST 训练快约 5× 且与 flow 版 π0 性能相当;在标准离散化「完全失败」的高频灵巧任务上也能学会。
- 规模:与 π0 结合,扩展到约 1 万小时数据。
- DROID 泛化:训练出首个在 DROID 数据集上、可零样本语言跟随的通才策略(在 Berkeley/Stanford/UW 的新环境评测)。
- 本文只保留论文明确报告的总体结论:FAST 的 token 压缩显著提高了自回归动作训练效率,并在论文任务中取得与 flow-based π0 有竞争力的结果;逐任务数值请以原论文表格为准。
Strengths and Limitations
Strengths:让简单的自回归 VLA 学会 binning 学不了的高频灵巧技能;训练快约 5×;序列压缩约 10×;FAST+ 通用可复用。
局限(分析):核心权衡是推理更慢——π0-FAST 的自回归解码在推理时明显慢于 π0 的 flow 解码;DCT+量化+BPE 是有损流水线,重建保真度与 token 预算存在取舍。
Takeaways
FAST 与 π0 构成「训练快 vs 推理快」的对照:自回归 token 训练友好但推理慢,flow 推理快但训练慢。这个张力直接引出下一篇 KI——能不能两头都要?
KI
Knowledge Insulating Vision-Language-Action Models: Train Fast, Run Fast, Generalize Better
一句话诊断并修复「给 VLM 加一个从零初始化的连续动作专家,会冲刷掉 VLM 预训练知识、拖慢训练」的问题:用 stop-gradient + 离散 token 共训把 VLM 知识「隔离」保护起来。
年份 / Venue arXiv 2025(会议未确认)| 机构 Physical Intelligence(π0 团队)| 方向 VLA 训练配方, knowledge transfer | 真机 ✅ 抽屉/叠衣/清桌/移动操作 + LIBERO/DROID
BibTeX
@article{driess2025ki,
  title   = {Knowledge Insulating Vision-Language-Action Models: Train Fast, Run Fast, Generalize Better},
  author  = {Driess, Danny and Springenberg, Jost Tobias and Ichter, Brian and Yu, Lili
             and Li-Bell, Adrian and Pertsch, Karl and Ren, Allen Z. and Walke, Homer
             and Vuong, Quan and Shi, Lucy Xiaoyang and Levine, Sergey},
  journal = {arXiv preprint arXiv:2505.23705},
  year    = {2025},
  url     = {https://arxiv.org/abs/2505.23705}
}
Motivation
VLA 的威力来自把 VLM 的 web 级语义迁移进控制。但 VLM 是大模型、走离散 token,机器人要连续动作,于是要外挂一个 diffusion/flow 的动作专家——这引入了一批新初始化的参数。论文的关键发现:天真地加连续动作专家会同时损害训练速度与知识迁移——动作专家的噪声梯度回流进 VLM,冲刷(wash out)预训练语义表示、拖慢收敛。
Method
两个配合的机制,把 VLM 骨干「隔离」保护,同时仍支持快速连续控制:
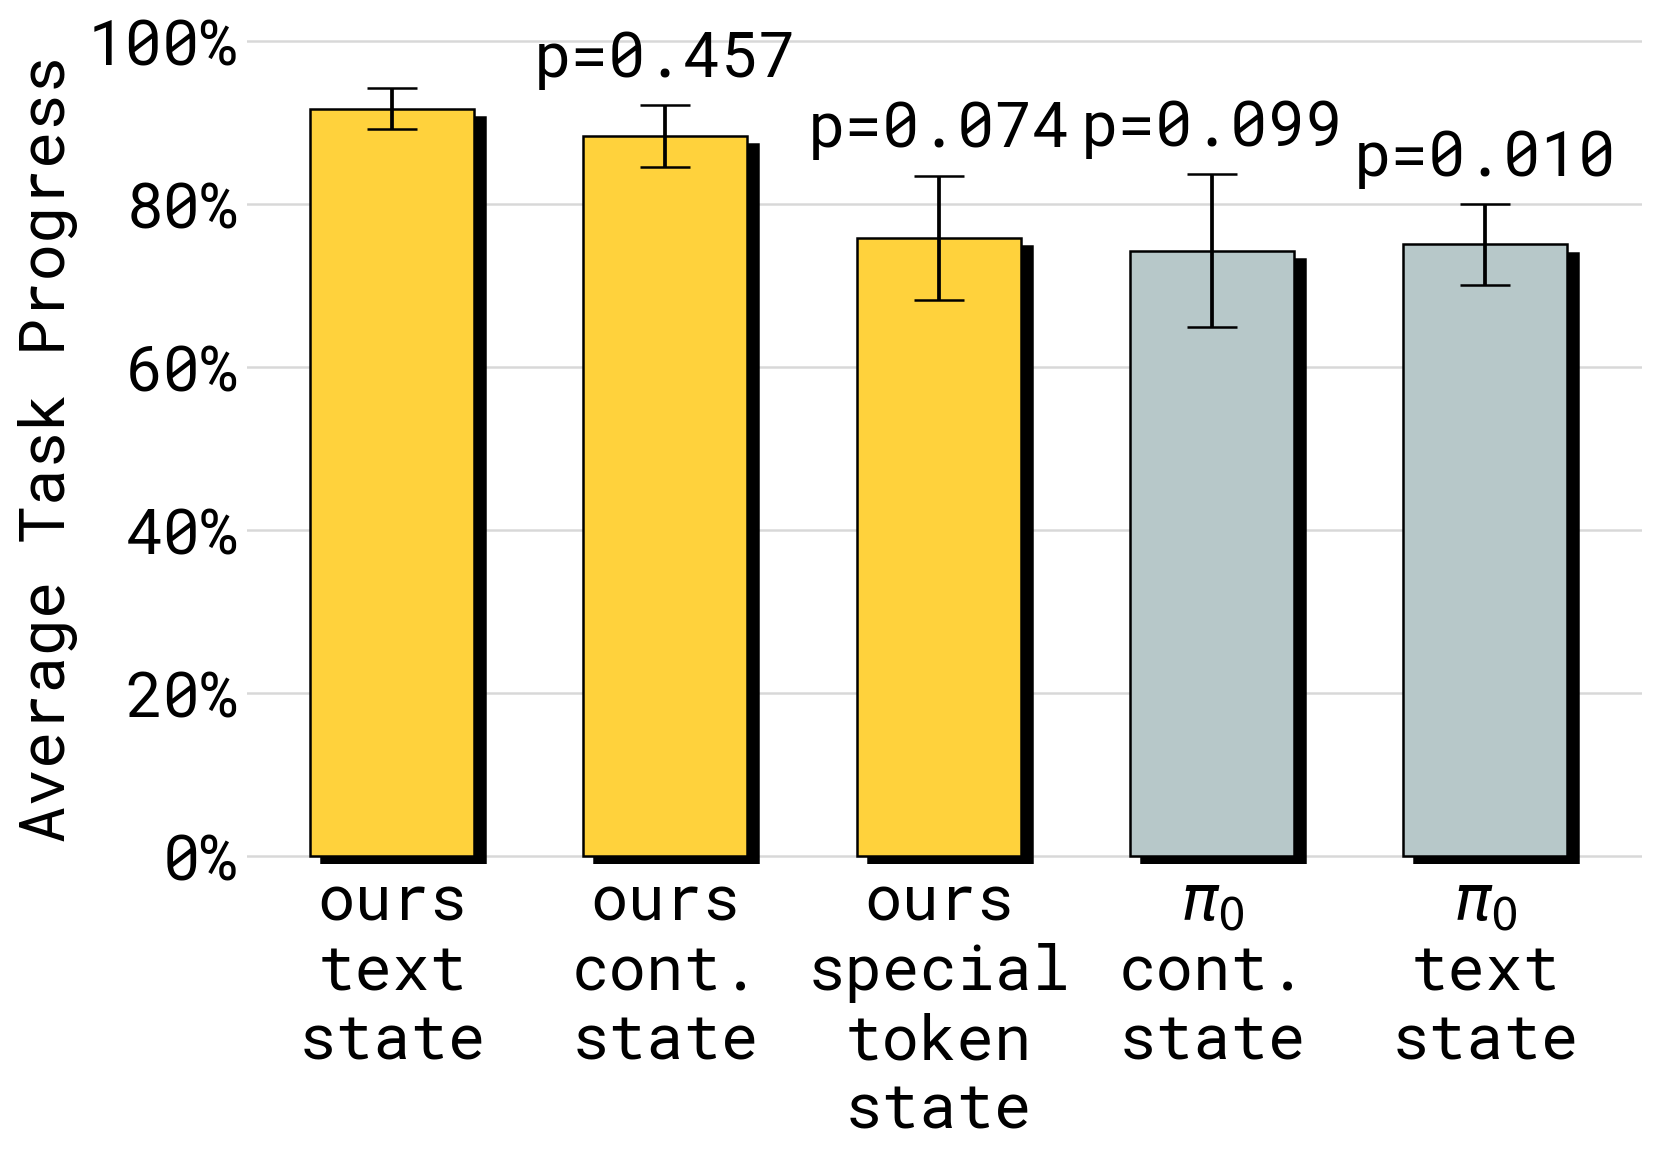
- 对「动作专家 → 骨干」的连接做 stop-gradient:前向时动作专家可以读骨干特征,但 flow 损失的梯度不回流进 VLM(在注意力层用 stop-gradient 实现,注意力不对称——专家看骨干 token,骨干不看专家 token)。
- 用离散(FAST)动作 token 的 next-token 目标同时微调 VLM:让骨干继续使用与语言预训练一致的离散序列目标;另有一个独立的 flow 动作专家输出连续动作。
双损失相加:离散 token 损失驱动骨干快速适配并保住语言 grounding,flow 损失驱动连续专家——且连续专家的梯度不腐蚀骨干。
Experiments
- 收敛速度:在清桌通才设置上,比 π0 快约 7.5×;与 π0-FAST 相当,但输出是连续动作。
- 语言跟随:stop-gradient + VLM 共训在各任务上语言遵循最好。
- 基准(数值以论文表格为准,此处为核到的近似值):LIBERO-90 约 96.0%、LIBERO-Spatial 约 98.0%;DROID 约 0.55 ± 0.09,高于 π0(约 0.49)与 π0-FAST(约 0.45)。
- 消融:冻结骨干 → 约 0%(光靠预训练不够);不加 stop-gradient 的联合训练 → 语言跟随退化;去掉 VLM 共训数据 → 任务完成率与泛化都变差。
Strengths and Limitations
Strengths:干净地诊断出一个被忽视的真实问题(随机初始化的动作专家会破坏预训练骨干);修复方案低成本(stop-gradient + 离散共训)而非换架构;兼得训练快、保语言、连续推理快;实验覆盖真机 + LIBERO + DROID 且消融充分。
局限(分析):专为 flow/diffusion 动作专家 + VLM 这一设计而生,未必迁移到别的 VLA 架构;依赖 FAST token 与持续的 VLM/web 共训数据,管线更复杂;stop-gradient 意味着骨干特征不再直接为连续控制目标而适配,对极精细连续任务是否封顶尚未定论。
Takeaways
KI 把 FAST 从「一种替代动作表示」升格为「训练工程里的关键组件」:离散 token 不只是推理方案,还能当作保护 VLM 知识的正则手段。它是把 π0 变得「又快又不忘知识」的配方,直接进了 openpi。
Pi0.5
π₀.₅: a Vision-Language-Action Model with Open-World Generalization
一句话在 π0 之上主攻开放世界泛化:进到训练里从没见过的真实家庭里做多分钟长任务,靠异构数据 co-training + 「先出语义子任务、再出动作」的分层推理。
年份 / Venue arXiv 2025 | 机构 Physical Intelligence | 方向 开放世界泛化, hierarchical VLA | 真机 ✅ 移动操作机在真实家庭
BibTeX
@article{pi2025pi05,
  title   = {{\(\pi_{0.5}\)}: a Vision-Language-Action Model with Open-World Generalization},
  author  = {{Physical Intelligence} and Black, Kevin and Brown, Noah and Driess, Danny and others},
  journal = {arXiv preprint arXiv:2504.16054},
  year    = {2025},
  url     = {https://arxiv.org/abs/2504.16054}
}
Motivation
π0 虽灵巧,但泛化弱,主要在与训练分布相近的受控环境里管用。π0.5 的目标是进到训练里从没见过的新家庭——那里物体类别、外观、空间布局都不同。泛化要在三个层面同时发生:物理(新摆放/动力学)、视觉(新外观/光照)、语义(新任务/新类别/新指令)。
Method
- 底座:直接建在 π0 VLA 架构上。
- 异构数据 co-training:把图像观测、语言指令、物体检测、高层语义子任务预测、低层动作,以及多机器人示范 + web 数据一起联合训练,让知识跨抽象层级迁移。
- 分层推理(机器人版 CoT):推理时先用自然语言预测一个高层语义子任务(如「pick up the pillow」),再据此产出低层电机动作。
- 混合动作解码:高层语义动作用离散自回归 token,低层连续动作用 flow matching(承自 π0)。
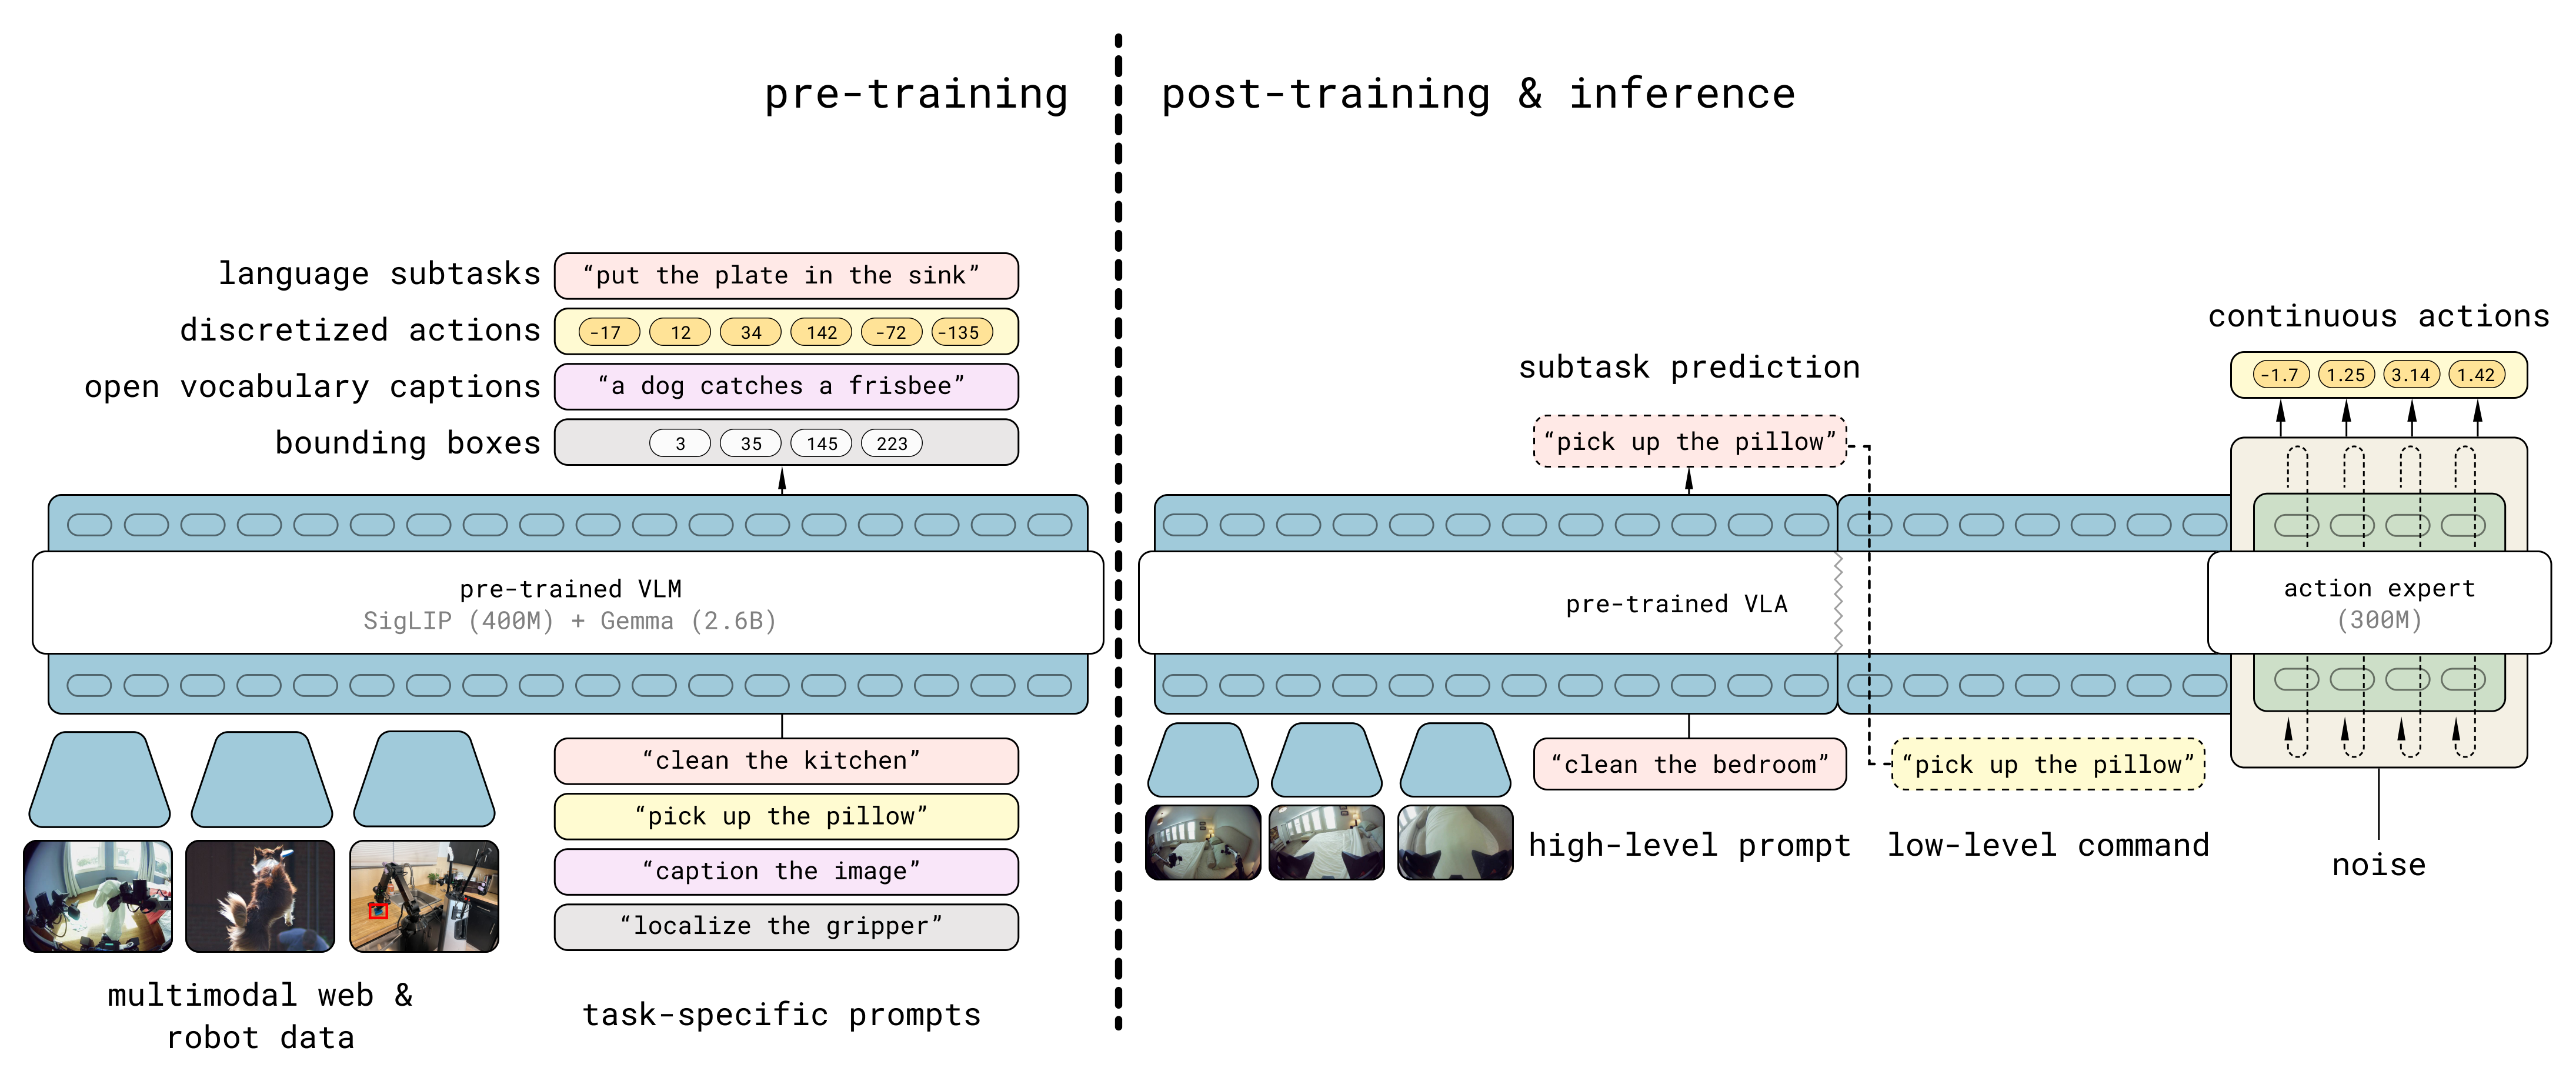
Experiments
- 设置:在训练里未见的新家庭中做多分钟长任务——清理厨房/卧室、铺床、收拾餐具。
- 作者主张:论文将其结果概括为端到端学习系统在未参与训练的家庭环境中执行长时程灵巧操作;这一结论应按论文给定的家庭、任务和评测协议理解。
- 数据规模与消融:官方报告显示,测试环境表现随训练环境数量增加而改善;在其规模曲线中,约 100 个训练环境时接近“在测试环境上训练”的参考线。移除 web 数据会降低新物体相关的 OOD 表现。这里只描述图表趋势,不引用无法与原图逐项对应的转述数字。
Strengths and Limitations
Strengths:真正泛化到新环境(新家庭)而非分布内小扰动;能做需要语义分解的多分钟长任务;对扰动/打断鲁棒,接受不同粒度的语言指令;验证了「异构 co-training + web 知识迁移」这条泛化配方。
局限(分析,多为作者自述):作者明说「远非完美」,语义推理与动作执行都仍常失败;不引入新技能,贡献是把已有技能泛化开;系统是反应式的、不会从自身经验自我改进——这正是 π*0.6 要补的。
Takeaways
π0.5 把 π0 从「实验室灵巧」推向「真实家庭可用」,并把分层(先语义后动作)正式写进底座。它与 Hi Robot 是分层思路的两种形态:π0.5 是模型内隐式分层,Hi Robot 是显式的双系统。
RTC
Real-Time Execution of Action Chunking Flow Policies(博客题名 Real-Time Action Chunking with Large Models)
一句话让大模型 VLA 能实时执行:把「换动作块」建模成 inpainting——冻结已承诺的动作、在后台异步生成下一块,消除块边界的卡顿与跳变。
年份 / Venue NeurIPS 2025 | 机构 Physical Intelligence · UC Berkeley | 方向 实时执行, action chunking | 真机 ✅ π0.5 双臂 + 移动操作
BibTeX
@inproceedings{black2025rtc,
  title     = {Real-Time Execution of Action Chunking Flow Policies},
  author    = {Black, Kevin and Galliker, Manuel Y. and Levine, Sergey},
  booktitle = {Advances in Neural Information Processing Systems (NeurIPS)},
  year      = {2025},
  url       = {https://arxiv.org/abs/2506.07339}
}
Motivation
机器人是实时系统,推理延迟直接伤控制,而大模型 VLA 又慢。**动作块(action chunking)**给了时间一致性,却没解决延迟,还带来两个问题:
- 块边界的不连续 / 模式跳变:相邻块可能跳到不同策略,产生抖动、分布外的运动。
- 块长权衡:执行视野长 → 对新观测不敏感;短 → 跳变/抖动更多。
此前默认的同步推理在执行视野结束时才开始生成下一块,并暂停机器人去算——生成时间超过控制周期时就出现可见卡顿,进一步偏离训练分布。(论文给的延迟量级:RTX 4090 上 3B π0 光 KV-cache prefill 就约 46ms,而 50Hz 控制周期只有 20ms。)
Method
- 核心洞见:把实时换块建模成 inpainting 问题。新块生成时,旧块已部分执行,新块必须与已承诺的动作兼容,同时纳入新观测。
- 冻结(freezing):新块开头对应「生成期间必将执行完」的那 步,冻结为已知值、给满引导权重。
- 软掩码(soft masking,关键扩展):只冻头 步在 小时引导太弱、易切换策略。RTC 用实数掩码关注全部重叠动作——前 步权重 1、无重叠的后 步权重 0、中间按指数衰减(越远的未来越不确定)。
- 实现:基于免训练的 flow inpainting(pseudoinverse guidance / ΠIGDM),在每个去噪步加一个基于 VJP 的引导项,并加引导权重裁剪 β(少步去噪下的稳定性来自这里)。无需重训,可直接套在任何 diffusion/flow VLA 上。
- 系统:推理跑在后台线程,让每个 都有动作可用——推理与执行重叠而非停机。

Experiments
- 仿真:Kinetix 上 12 个高动态任务(力控、无法暂停)。Baseline:Naive async、Bidirectional Decoding (BID)、Temporal Ensembling (TE)。结论:RTC 对推理延迟最鲁棒,延迟越大领先越明显;软掩码 > 硬掩码,尤其 小时;TE 即使零延迟也差(对多模态动作做平均会产生无效动作)。
- 真机:底座 π0.5、双 6-DoF 臂 + 平行夹爪,H=50、50Hz、5 步去噪。6 个任务(点蜡烛、插网线、铺床[移动]、叠衬衫、批量叠衣、放碗入槽[移动]),每法每任务 10 次、共 480 个 episode / 约 28 小时机器人执行。
- 头条结果:同样的动作 RTC 比同步执行快约 20% 且更平滑;对 >300ms(超过预测视野 30%) 的延迟仍鲁棒,在 +100ms / +200ms 注入延迟下吞吐显著最优且不退化,而 TE 在此延迟下会触发机器人保护性停机。
Strengths and Limitations
Strengths:免训练、即插即用,套在现成 diffusion/flow VLA 上;后台线程推理消除块边界停顿,容忍大延迟(>300ms),把模型大小/部署位置与控制平滑度解耦;用 inpainting + 软掩码从原理上治「模式跳变」,而非事后平滑(论文证明事后平滑可能产生无效动作);评测充分(480 真机 episode / 28h)。
局限(分析):需要迭代去噪的策略(diffusion/flow),单步回归策略用不了这套 inpainting 引导;稳定性依赖调好的裁剪 β;每去噪步多一次 VJP 引导计算(真机延迟 97ms 略高于 baseline 的 76ms);受 约束,极高延迟下可用执行窗口收窄。
Takeaways
RTC 把「大模型太慢没法实时控制」这个部署痛点,转成了一个纯推理期的信号处理问题。它让 π 系列可以放心把模型做大、甚至放到远端推理,而不牺牲控制平滑度——是把 VLA 推向产品的关键一环。
Hi Robot
Hi Robot: Open-Ended Instruction Following with Hierarchical Vision-Language-Action Models
一句话分层 VLA:高层 VLM(System 2)把复杂开放式指令和实时人类反馈拆成一句句原子命令,低层 VLA(System 1,π0)负责执行。
年份 / Venue ICML 2025 | 机构 Physical Intelligence(+ Stanford 等)| 方向 分层 VLA, 开放式指令 | 真机 ✅ 单臂/双臂/移动操作
BibTeX
@inproceedings{shi2025hirobot,
  title     = {{Hi Robot}: Open-Ended Instruction Following with Hierarchical Vision-Language-Action Models},
  author    = {Shi, Lucy Xiaoyang and Ichter, Brian and Equi, Michael and Ke, Liyiming
             and Pertsch, Karl and Vuong, Quan and Tanner, James and Levine, Sergey and Finn, Chelsea},
  booktitle = {International Conference on Machine Learning (ICML)},
  year      = {2025},
  url       = {https://arxiv.org/abs/2502.19417}
}
Motivation
开放世界里的通用机器人不仅要会执行一串可行的步骤,还要能理解复杂开放式指令(「给我做个素食三明治」)和执行中的实时人类反馈(「我不喜欢那个」「那不是垃圾」)。单个扁平 VLA 能做动作,却难把复杂命令和反馈落到物理世界里。这需要高层推理 + 低层反应式控制的结合。
Method
- System 1 / System 2 分层:
- System 2(高层 VLM):对复杂指令 + 用户反馈 + 图像做推理,把任务拆成中间原子步骤——像模型「自言自语」,把复杂任务切成小块,向低层「低声下达」一句句语言命令;语义/视觉推理来自 web 级 VLM 预训练。
- System 1(低层 VLA):一个基于 π0 的策略,接收自然语言子任务 + 视觉 + 本体,产出机器人动作。
- 实时插话处理:当用户插话(「那不是垃圾」),高层把所指物体 grounding 到图像中正操作的物体,据此调整下一条命令。
- 训练数据:用合成标注——把真实机器人观测 + 人标技能,与假设的指令和人类插话配对,模拟真实的多步对话式交互,省去穷举人类对话示范。
Experiments
- 任务:清理餐桌、做三明治、买菜/装袋;跨单臂、双臂、移动操作机评测。
- Baseline:扁平 VLA;以及用 GPT-4o 当高层控制器。
- 结果(官方自报,头条):平均指令准确率 Hi Robot ~76%,扁平 VLA ~36%,GPT-4o ~30%(即比 GPT-4o 高约 40 个百分点)。逐任务细分未从原文表格核到。
Strengths and Limitations
Strengths:能处理多阶段/开放式指令并拆成可执行步骤;能在执行中响应实时纠正/约束(如饮食偏好、「不要那个」)并 grounding 到画面物体;借 web 级 VLM 推理,无需任务专属提示工程;指令准确率优于扁平 VLA 和现成强 LLM(GPT-4o)。
局限(分析):合成的指令/插话数据未必覆盖所有真实人类表述;低层受 π0 技能库限制(只会执行训练过的技能);评测限于三个任务域;原文的详细 limitations/消融未从摘要核到。
Takeaways
Hi Robot 把「慢思考的语义规划」和「快反应的动作执行」显式解耦,是 π 系列处理长程/开放指令的方案。它与 π0.5 的隐式分层互补:一个把分层做进单模型,一个把分层做成双系统。
Pi0.6
π0.6 / π*0.6: a VLA That Learns From Experience(方法:RECAP)
一句话让 VLA 从经验中学习:RECAP 用一个价值函数做 advantage 条件化,把示范、专家纠正、自主试错三类数据统一起来做 RL,超越纯模仿。
π0.6 与 π*0.6 的区别π0.6 是一个 5B VLM + 动作专家的通用 VLA 基座;π*0.6(pi-star-0.6)在其上应用 RECAP。RECAP 先做 advantage-conditioned offline RL 预训练,再用任务示范微调,并继续利用真机自主数据、专家纠正和奖励反馈进行专门化。π0.6 没有独立发布页,本节以 π*0.6 官方报告 为准。
年份 / 形式 官方博客 + 技术报告 PDF,2025-11-17(非 arXiv)| 机构 Physical Intelligence | 方向 RL post-training, learning from experience | 真机 ✅ 真实家庭/工厂/咖啡机
材料 Blog · Tech Report (PDF) · openpi
BibTeX
@techreport{pi2025pistar06,
  title       = {{\(\pi^{*}_{0.6}\)}: a VLA That Learns From Experience},
  author      = {{Physical Intelligence}},
  institution = {Physical Intelligence},
  note        = {Technical report; https://www.pi.website/download/pistar06.pdf},
  year        = {2025}
}
Motivation
纯模仿(只用示范)会复合误差:连续物理控制里一个小错把机器人推进陌生状态、错误越滚越大——这是静态输出的 AI 系统没有的问题。报告主张「熟能生巧」:要达到可靠性、速度/吞吐、对新条件的适应,VLA 必须不只学示范,还要从自主采集的经验和部署中的专家纠正里学,并用 RL 形式化。挑战在于:为大模型设计可扩展稳定的 RL、处理来自不同策略的异构数据、以及真实世界稀疏/含糊的奖励信号。
Method
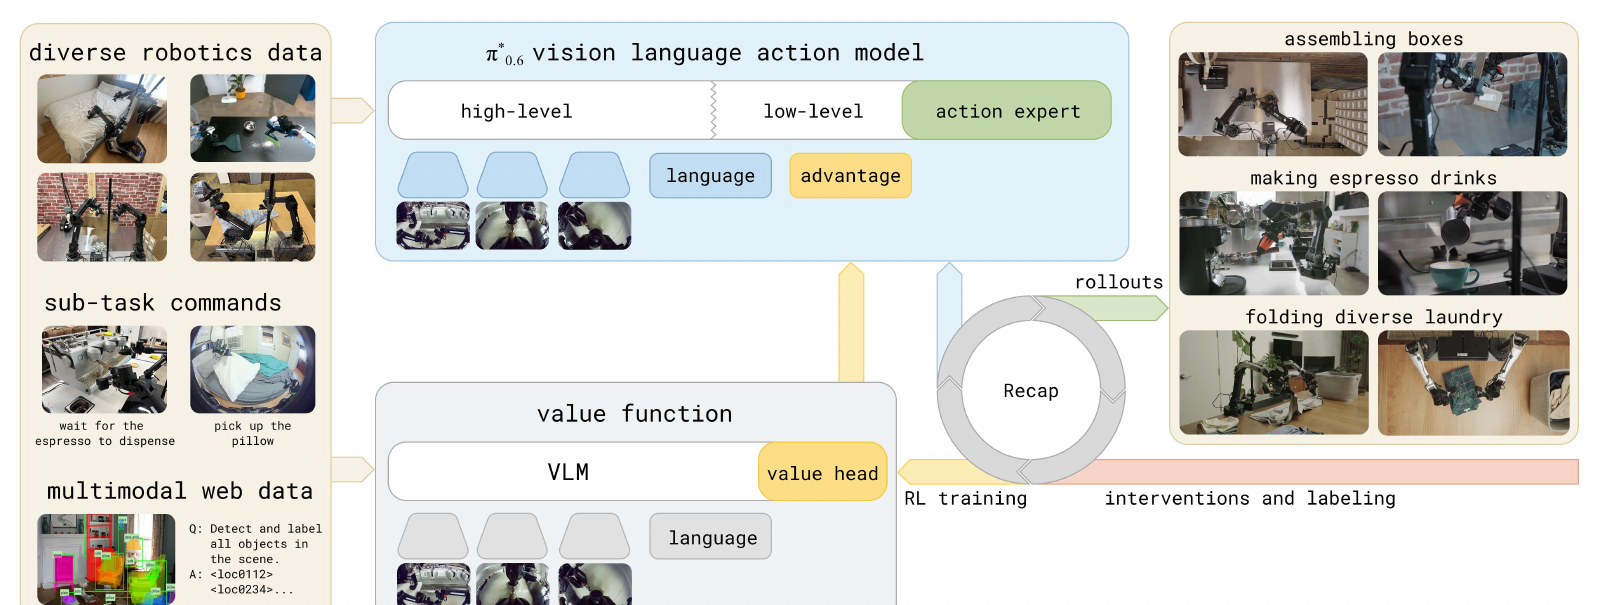
- RECAP = RL with Experience and Corrections via Advantage-conditioned Policies。
- 核心机制——advantage 条件化:先学习价值函数并据此估计动作相对基线的 advantage,再把 advantage 作为 VLA 的条件信号,使策略偏向高价值行为。价值的具体含义由任务奖励与报告定义,不能简单等同于“成功概率”。该表示可以统一示范、自主 rollout 和遥操作介入数据。
- 三阶段配方:① 示范(人类遥操作)→ ② 教练/纠正(专家在自主执行中介入示范如何从错误里恢复)→ ③ 自主练习(机器人自采 rollout、用稀疏结果奖励,价值函数在线微调后再重新条件化策略)。
- π*0.6 vs π0.6 vs π0.5:π0.6 是一个 5B VLM + 动作专家;π0.5/π0.6 主要依赖监督模仿;π*0.6 先做 advantage-conditioned offline RL 预训练,再用任务示范和真机经验继续训练。这里的真机经验包括自主 episode、专家纠正与奖励反馈,不能概括为纯离线方法。
Experiments
- 任务:在专业咖啡机上做浓缩咖啡、在真实家庭里叠各式衣物、装配纸箱(巧克力包装厂场景)。
- 技术报告结果:作者报告,在其选定的一组高难任务和系统配置中,RECAP 将任务吞吐提高到基线的两倍以上,并将失败率降低约一半;这些数字不应外推到其他任务或机器人平台。
- 结果口径:官方报告分别用每小时成功完成次数和成功率评估装箱、叠衣与浓缩咖啡任务。本文保留报告可直接支持的结论:RECAP 在所有任务中提高吞吐,在部分困难任务上使吞吐和成功率超过两倍;不采用从图像近似读取的柱高作为精确数字。
Strengths and Limitations
Strengths:直面模仿学习的复合误差顽疾,给出贯穿「预训练 → 部署」的统一 RL 配方;advantage 条件化是把异构数据(示范 + 自主 + 介入)纳入单一训练信号的务实做法,避免在 5B 模型上跑不稳的策略梯度;在真实家庭、真实工厂、真实咖啡机等经济上有意义的长时程任务上验证;有配套完整技术报告。
局限(分析):非同行评审、(截至检索)不在 arXiv,数值为厂商自报、无外部复现;报告未系统列出失败模式;方法依赖专家人工介入与任务专属奖励/价值信号,「自主」程度与向新任务扩展的成本有限;算力、数据量、自主练习安全性等细节未披露。
Takeaways
π*0.6 把 π 系列从「模仿学习」推进到「从经验中学习」,补上了 π0.5 明说的短板(反应式、不自我改进)。RECAP 的 advantage 条件化,是在大 VLA 上做 RL 而不炸训练的一种工程折中。
RLT
RL Token: Bootstrapping Online RL with Vision-Language-Action Models(官方研究页题名 Precise Manipulation with Efficient Online RL)
一句话从冻结的 VLA 里训练一个 encoder-decoder,把内部特征压成一个紧凑的 RL token 瓶颈表示,作为轻量 actor-critic 的高效接口做在线 off-policy RL;策略学习编辑(而非替换)VLA 动作,用几分钟到几小时真机数据把最难的高精度环节练到超越人类遥操作。
年份 / 形式 官方研究页 + 技术报告 PDF,2026-03-19(非 arXiv)| 机构 Physical Intelligence | 方向 Online RL fine-tuning, precise manipulation | 真机 ✅ 螺丝刀插入 / 扎带紧固 / 网线 / 充电器插接
材料 Blog · Tech Report (PDF) · openpi
BibTeX
@techreport{pi2026rlt,
  title       = {{RL Token}: Bootstrapping Online RL with Vision-Language-Action Models},
  author      = {Xu, Charles and Springenberg, Jost Tobias and Equi, Michael and Amin, Ali
                 and Esmail, Adnan and Levine, Sergey and Ke, Liyiming},
  institution = {Physical Intelligence},
  note        = {Technical report; https://www.pi.website/download/rlt.pdf},
  year        = {2026}
}
Motivation
通才 VLA 能「开箱即用」学会大量技能,却常栽在最后一毫米——对准螺丝刀与螺丝、插网线/充电器这类高精度环节:动作慢、要反复重试,某个关键阶段的小误差累积成整任务失败,而这些恰恰是纯示范最难覆盖的部分。用 RL 精调这些环节是自然选择,但有两难:直接对大 VLA 跑 RL 数据效率低、算力大;换个小模型能几小时内在线学,却丢掉 VLA 的泛化。RLT 要两头兼得——借 VLA 的泛化,又要小模型在线 RL 的速度与样本效率。
Method
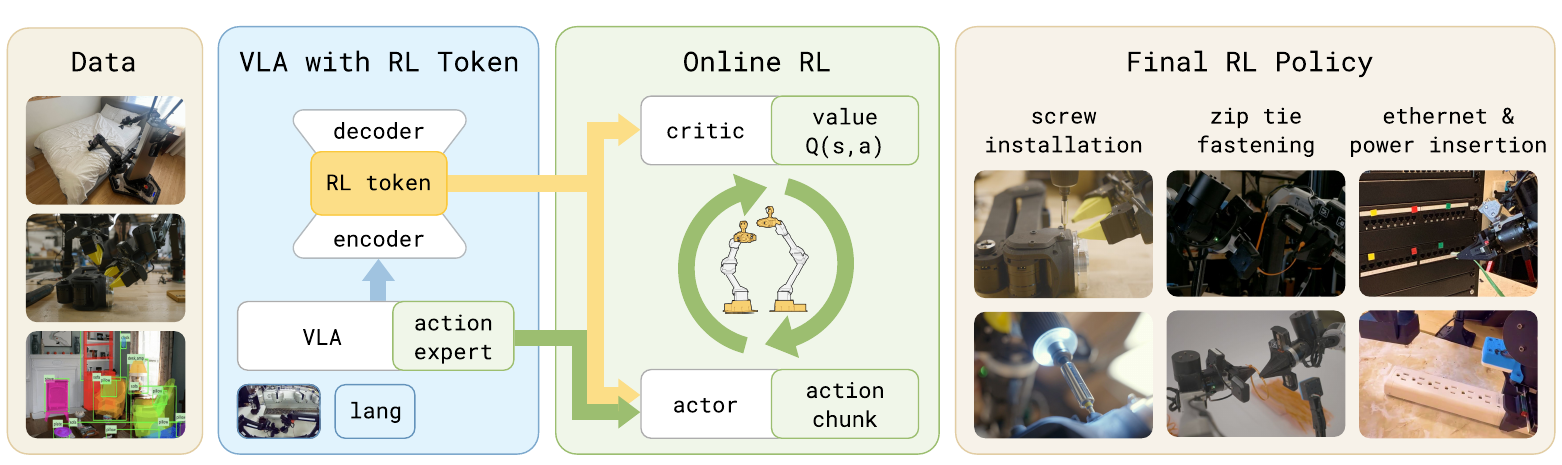
- RL token 瓶颈:不直接对 VLA 做 RL,而是训练一个 encoder-decoder transformer,通过重建 VLA 的内部 embedding 学出一个紧凑、保留任务相关知识的「RL token」表示,作为下游 RL 的高效接口。
- 轻量 actor-critic:小 actor / critic 网络读这个 RL token,在机器人上在线 off-policy RL 更新(可达每秒数百次);actor 预测与 VLA 时间结构对齐的 action chunk。
- 编辑而非替换(grounding):策略学习编辑 VLA 输出的动作而非从头替换,并用 reference-action dropout 防止退化成照抄 base 动作。
- 可选人工介入:训练可纳入部署中的专家介入示范。
Experiments
- 任务:四个高精度真机任务——螺丝刀插入(M3 螺丝、亚毫米对准)、扎带紧固、网线插入、充电器/电源插入。
- 头条结论(技术报告摘要):在任务最难的环节把速度提升最多约 3×,几分钟到几小时练习内显著提高成功率,部分任务上超越人类遥操作速度。
- 逐任务数值(官方研究页自报,10 分钟内成功次数 RLT vs base):螺丝刀 ~15 vs ~8;扎带 ~12 vs ~5;网线 ~350 vs ~100;充电器 ~600 vs ~150;网线任务约 50% 的最终尝试比任何遥操作演示都快;训练仅需约 15 分钟机器人数据(含开销共约 2 小时)。
- 以上均为公司自报、非同行评审、无外部复现。
Strengths and Limitations
Strengths:把「大 VLA 的泛化」与「小模型在线 RL 的速度/样本效率」解耦——用 RL token 当接口,几分钟真机数据即可精调;「编辑而非替换 + reference-action dropout」既保住 base 能力又能超越它;直击「最后一毫米」高精度这一真实痛点;off-policy 每秒数百次更新,真机上可行。
局限(分析):非同行评审、无 arXiv/开源细节,数值为公司自报无外部复现;针对单个 task phase / 高精度环节做精调,而非整任务或整策略的提升;效果依赖冻结 VLA 的表示质量与 RL token 的重建保真;仍需真机在线交互(安全/损耗成本)与可测奖励 / 人工介入。
Takeaways
RLT 与 π*0.6 是「从经验学习」的两种粒度:RECAP 用 advantage 条件化把示范 + 自主 + 介入统一进整机策略训练;RLT 则把 RL 收缩到一个瓶颈 token 上,专攻高精度环节的在线快精调。它也延续了 KI 的思路——用一个中间表示(离散 token / RL token)把大模型知识与下游目标解耦——把「在大 VLA 上做 RL 太贵」化解为「只在一个小接口上做 RL」。
Pi0.7
π₀.₇: a Steerable Model with Emergent Capabilities
一句话可「操控」(steerable)的通才:用语言 + 元数据 + 控制模态 + 视觉子目标等多模态提示,指定不仅「做什么」还有「怎么做」,从而统一吸收异构数据,并显现技能组合式泛化(compositional generalization)与跨本体迁移。
年份 / 形式 官方博客 + 技术报告 PDF,2026-04-16(非 arXiv)| 机构 Physical Intelligence | 方向 Steerable generalist, compositional generalization | 真机 ✅ 跨本体(含双臂 UR5e)
材料 Blog · Tech Report (PDF) · openpi
BibTeX
@techreport{pi2026pi07,
  title       = {{\(\pi_{0.7}\)}: a Steerable Model with Emergent Capabilities},
  author      = {{Physical Intelligence}},
  institution = {Physical Intelligence},
  note        = {Technical report; https://www.pi.website/download/pi07.pdf},
  year        = {2026}
}
Motivation
异构数据(不同机器人、人类视频、自主 episode)质量与策略各异,直接混训会互相干扰。π0.7 想用「可操控」的多模态条件把这些数据消歧——用元数据标注速度/质量/熟练度、用控制模态标注关节 vs 末端、用视觉子目标标注中间状态——让一个通才模型既能吸收异构数据,又能在部署时被精确引导「怎么做」,并把此前 π*0.6 那种「每任务一个专家」收敛成单个免微调的通才。
Method
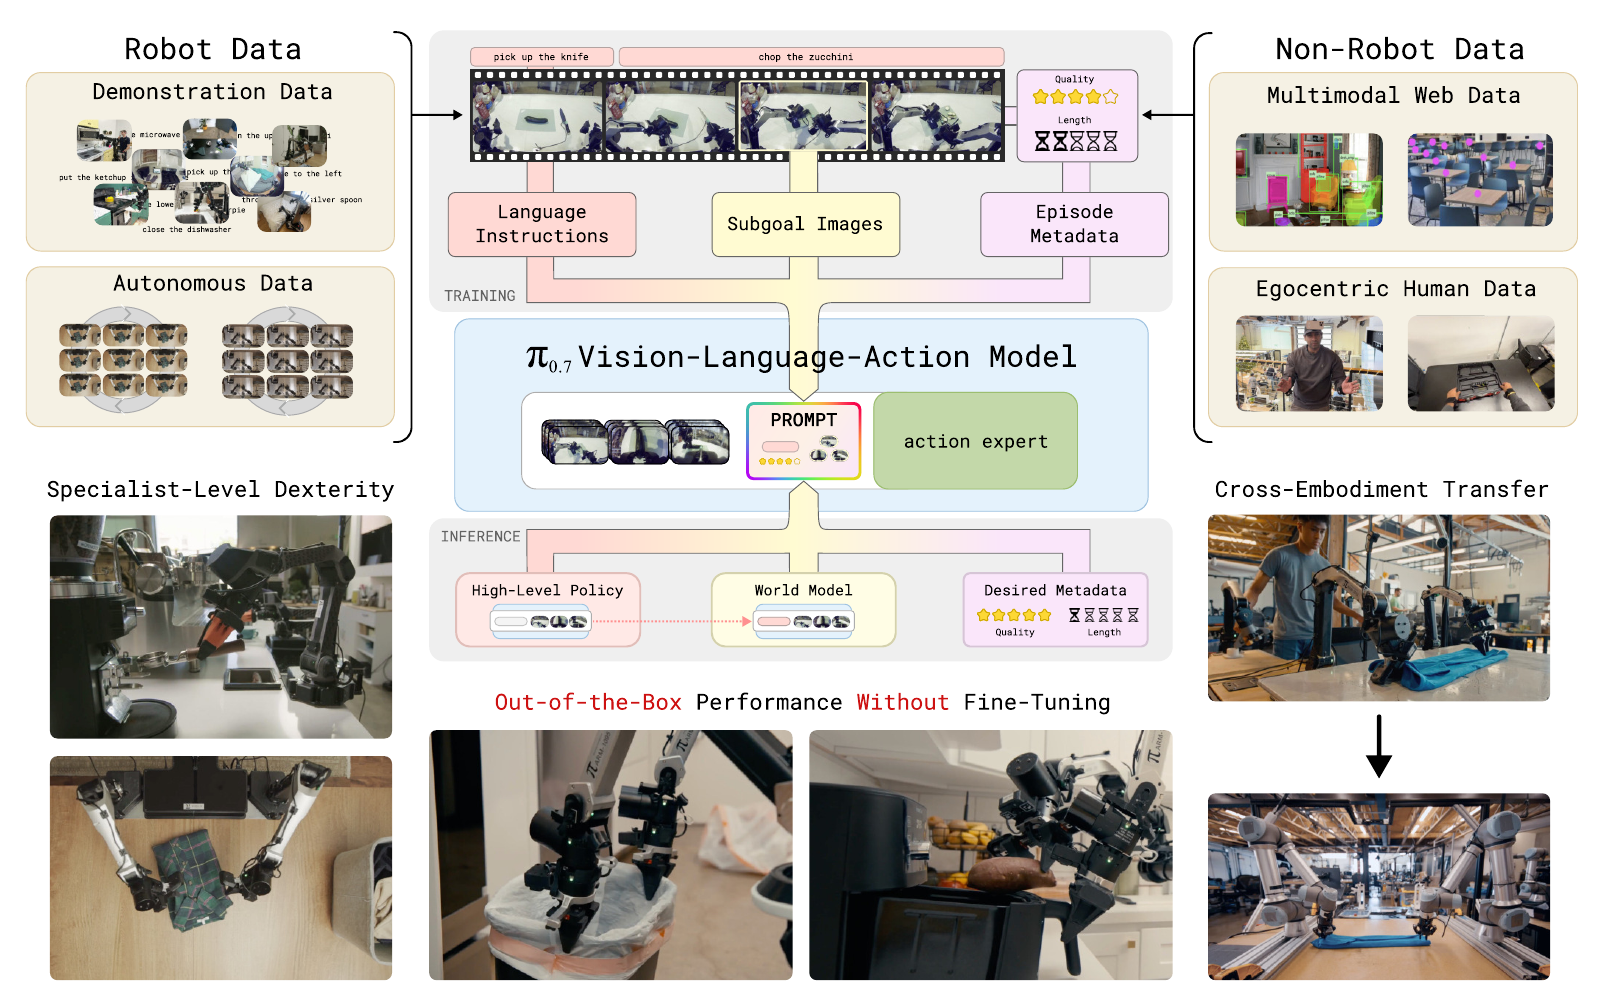
- 多模态条件(steerability):语言指令 + 元数据(速度/质量/熟练度)+ 控制模态标签(关节/末端)+ 测试时由世界模型生成的视觉子目标图(指定期望的中间状态)。这让「怎么做」可被显式指定,而不只是「做什么」。
- 从专家蒸馏:把 π*0.6(RECAP 训练的任务专家)的自主 episode,用策略元数据蒸馏进单个 π0.7 通才,达到甚至超过专家水平而无需逐任务微调。
- 组合式泛化:像 LLM 组合文本概念一样组合已学技能——例如面对没直接训练过的空气炸锅,用两段「关炸锅」归档 episode + DROID 的 Franka 数据组合出操作。
Experiments
- 跨本体迁移:在双臂 UR5e 上叠衣——训练数据来自另一台更小的静态双臂机器人、UR5e 上无叠衣数据——成功率追平在源机器人上有约 375+ 小时经验的人类遥操作者的「零样本」表现(UR5e 手臂重、惯性大、夹爪不精,本就难遥操作)。
- 开箱即用:在叠衣、做浓缩咖啡、折箱等任务上,无需逐任务微调即达到 RECAP 微调专家(π*0.6)的水平。
- 头条为「首次出现技能组合式泛化的迹象」。以上均为公司自报、无同行评审与外部复现。
Strengths and Limitations
Strengths:把「怎么做」纳入条件,统一吸收异构数据(不同机器人、人类视频、自主经验);从专家蒸馏出免逐任务微调的通才;给出技能组合与跨本体迁移的早期证据。
局限(分析):非同行评审、无 arXiv/开源(仅技术报告 PDF),数值为公司自报无外部复现;「组合式泛化」仅「首次迹象」、范围有限;视觉子目标依赖世界模型质量;与 π0.5/π*0.6 的技术对比在公开材料里不够细。
Takeaways
π0.7 试图把 π 系列从任务专用策略推进到可由多模态条件控制的通才。官方报告称其观察到组合泛化的“初步迹象”,包括重组训练中已有技能以处理新任务;这些结果来自作者自报,尚不足以视为已经确立的类 LLM 泛化能力。官方页面,2026-04-16
Cross-Paper Comparison
| 论文 | 解决的问题 | 关键机制 | 载体/规模 | 局限(分析) |
|---|---|---|---|---|
| π0 | 通用灵巧控制的底座 | flow matching 动作专家 | PaliGemma 3B+300M,1万+小时 | 数据闭源、flow 需 10 步 |
| FAST | 自回归学不了高频动作 | DCT+量化+BPE 频域 token | π0-FAST | 推理更慢 |
| KI | 动作专家冲刷 VLM 知识 | stop-gradient + 离散共训 | π0,快 7.5× | 绑定 flow+VLM 设计 |
| π0.5 | 开放世界泛化 | 异构 co-training + 分层推理 | 移动操作机进新家 | 反应式、不自改进 |
| RTC | 大模型实时执行卡顿 | inpainting + 软掩码异步 | π0.5,快 ~20% | 需迭代去噪策略 |
| Hi Robot | 开放指令与实时反馈 | System 2 拆解 + System 1 执行 | π0 为低层 | 受低层技能库限 |
| π*0.6 | 纯模仿的复合误差 | RECAP:advantage 条件化 RL | π0.6 5B | 非评审、依赖人工介入 |
| RLT | 高精度环节不够、直接 RL 大 VLA 太贵 | RL token 瓶颈 + 轻量 actor-critic 在线 RL | 冻结 VLA + 小 actor-critic | 非评审、只精调单环节 |
| π0.7 | 每任务一个专家、异构数据难融 | 多模态条件 + 从专家蒸馏 | 跨本体通才 | 非评审、组合泛化尚初步 |
Discussion
把这些工作放在一起,可以比较 PI 围绕动作表示、泛化、实时执行和经验学习所做的不同设计选择:
-
连续动作与离散动作各有取舍。 π0 用 flow matching 生成连续动作块,FAST 研究自回归动作 token 的训练效率,Knowledge Insulation 则把离散 token 的表征训练与连续动作专家结合起来。现有结果说明混合方案值得关注,但还不能据此认定它已经成为 VLA 的稳定终局。
-
泛化靠数据异构性,而非单纯堆量。π0.5 的关键不是更多同类数据,而是把 web 数据、多本体数据、多环境数据混起来 co-train,并让模型先出语义子任务再出动作。这与 RL1 里 RT-1「多样性 > 数据量」的结论一脉相承。
-
部署是一等公民。RTC 专门解决「模型一大就没法实时控制」,把它变成纯推理期的 inpainting 问题;这让 PI 能放心把模型做大、放远端推理。学界常忽略的执行延迟,在 PI 这里是被认真对待的工程问题。
-
经验学习存在不同粒度。 π*0.6 用 RECAP 在整机策略层面结合 offline RL、示范和真机经验;RLT 从冻结 VLA 中抽取紧凑表征,再训练轻量 actor-critic,用于高精度任务的在线适配。π0.7 则通过语言、元数据、控制模态和视觉子目标组织异构数据,并把任务专家产生的数据纳入单个通才模型。三者的训练成本、交互需求和泛化口径不同,不宜写成必然的线性升级关系。
这些工作展示了几项可复用的设计选择:长程任务可使用分层语义子任务,动作表示会影响训练效率与语义知识保留,RL post-training 可利用自主经验改善专用任务,RTC 则针对动作块边界与推理延迟。它们是否能成为产品级通用方案,还需要跨平台、长期运行和安全性评测。