
Overview
本篇聚焦一条与 Robot Learning (1)、(2) 的端到端 VLA(π0 系列那种「图像+语言→动作」直连)正相反的路线:
不训练策略网络,而是把预训练基础模型(LLM / VLM / 大视觉模型)当成「会写代码、会推理几何」的接地器(grounder),让它从自由语言里推断出显式的空间表示(3D value map / 部件约束 / 关键点约束),再交给经典的规划器或优化器解出 6-DoF 末端位姿。
这条线的三篇代表作,恰好是一条表示越来越结构化的演进:
- VoxPoser — LLM 写代码调用 VLM,在体素化观测空间上组合 3D value map(affordance 吸引 + constraint 排斥),再用基于模型的规划合成密集 6-DoF 路点。
- CoPa — 把接地下沉到物体部件:粗到细定位任务相关部件,VLM 生成部件的空间几何约束,解出抓取后的一串位姿。
- ReKep — 把任务写成关系关键点上的时空约束(Python 代价函数),大模型自动生成,再用分层优化实时解 SE(3) 位姿,支持多阶段/双臂/反应式。
一条主线贯穿:基础模型负责「语义→几何」的接地,经典优化负责「几何→动作」的求解——用零样本、可解释、免数据的方式,绕开 VLA 对海量真机数据的依赖。代价是依赖深度感知/关键点跟踪的精度,且动作质量受限于所选优化器而非学习到的技巧。
Paper List
| 简称 | 年份 / Venue | 表示 | 接地器 | 求解器 | 核心思想 |
|---|---|---|---|---|---|
| VoxPoser | CoRL 2023 | 3D value map(体素) | LLM 写码 + VLM 检测 | 基于模型的运动规划 | 组合 affordance/constraint 体素图,规划密集 6-DoF 路点 |
| CoPa | arXiv 2024 | 部件空间约束 | GPT-4V + 抓取/分割模型 | 约束求解 | 粗到细定位部件,VLM 出几何约束,解抓取后位姿 |
| ReKep | arXiv 2024 | 关系关键点约束 | DINOv2 + GPT-4o | 分层优化(实时闭环) | 关键点代价函数 + 跟踪,实时解 SE(3),多阶段/双臂 |
VoxPoser
VoxPoser: Composable 3D Value Maps for Robotic Manipulation with Language Models
一句话LLM 用写代码的能力调用 VLM,在体素化的观测空间上组合 3D value map(affordance 吸引 + constraint 排斥),把自由语言接地成几何目标,再用基于模型的规划零样本合成密集 6-DoF 路点,不依赖预定义原语。
年份 / Venue CoRL 2023| 机构 Stanford(Fei-Fei Li 组)| 方向 Training-free LLM grounding, model-based planning | 真机 ✅ Franka Emika + 仿真大规模研究
BibTeX
@inproceedings{huang2023voxposer,
  title     = {{VoxPoser}: Composable {3D} Value Maps for Robotic Manipulation with Language Models},
  author    = {Huang, Wenlong and Wang, Chen and Zhang, Ruohan and Li, Yunzhu
               and Wu, Jiajun and Fei-Fei, Li},
  booktitle = {Conference on Robot Learning (CoRL)},
  year      = {2023},
  url       = {https://arxiv.org/abs/2307.05973}
}
Motivation
LLM 里装着大量可用于操作的「可执行知识」(推理 + 规划),但多数工作把这些知识落地时仍靠预定义的运动原语(pick/place/push…),这成了主要瓶颈——原语库有多大,机器人的行为空间就有多窄。VoxPoser 想直接合成机器人轨迹本身(密集的 6-DoF 末端路点),面向开放指令 + 开放物体,而不局限于某套原语。关键观察是:LLM 擅长从自由语言里推断 affordance 与 constraint,且能靠写代码去调用感知,把这些知识接地到智能体的观测空间。
Method
- LLM 写码接地:LLM(GPT-4)接到指令后生成 Python 代码,代码里调用 VLM / 开放词表检测器定位相关物体,并在体素网格上填出数值——这一步把「语言里的语义」变成「观测空间里的数」。
- 3D value map(可组合):两类核心图——affordance map(该靠近/去往的区域,正值吸引)与 constraint map(该避开的区域,负值排斥);此外还可组合旋转、速度、夹爪等图。多张图可组合成一个总的 value landscape。
- 基于模型的规划:把组合后的 value map 当作代价/奖励地形,用基于模型的运动规划在其上搜索,合成密集 6-DoF 路点序列。闭环执行、每步重规划 → 对动态扰动鲁棒(人手推、移动目标都能纠)。
- 在线学习动力学(可选):对接触密集(contact-rich)的场景,可在线高效学一个动力学模型做 MPC,提升如开抽屉这类需要接触推理的任务。
- 全程零样本:无策略训练、无预定义原语、无任务专属数据。
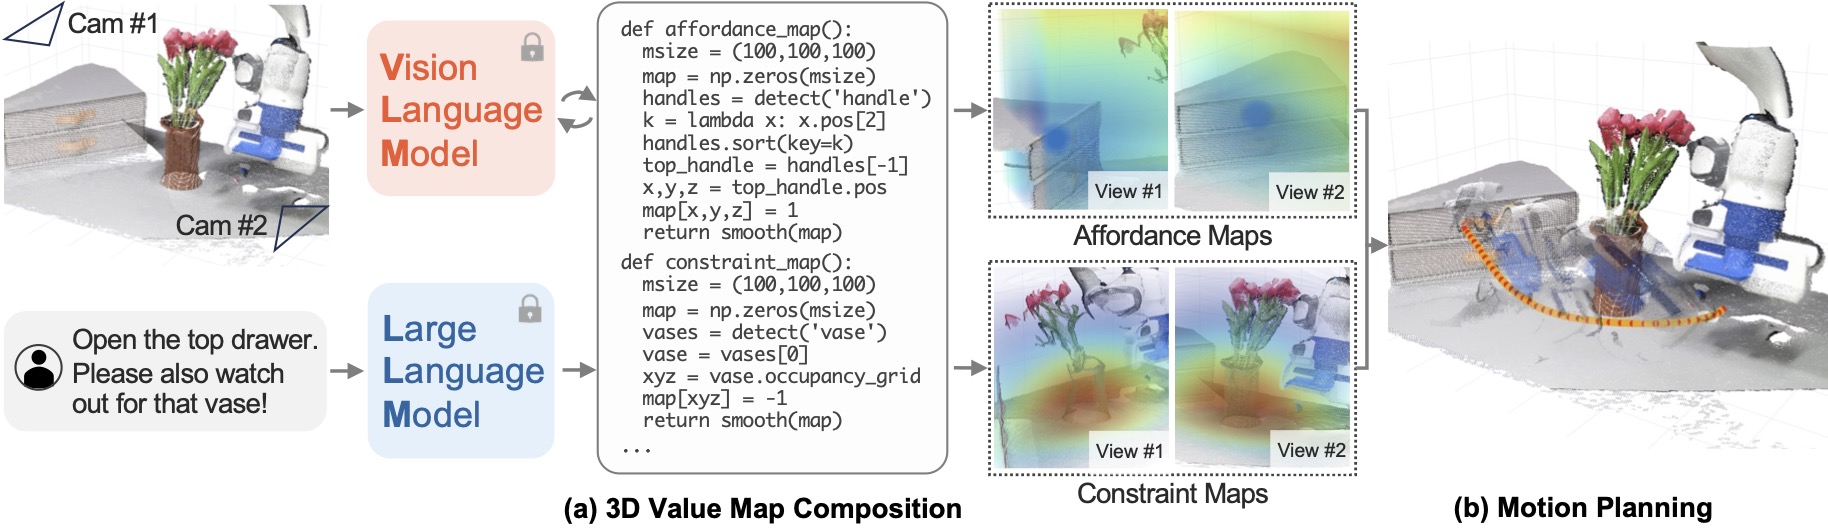
Experiments
- 规模:在**仿真 + 真机(Franka)**上做了大规模研究,覆盖大量以自由语言指定的日常操作任务(如开抽屉、把物体挪开、避障移动等)。
- 对照:与「LLM + 预定义原语」及去掉 value map 组合的变体对比,验证「组合式 value map + 规划」的价值;具体任务成功率百分比未逐一核到,此处只引用「零样本合成 6-DoF 轨迹、对扰动鲁棒」这一头条结论。
- 涌现能力(官方展示):常识推理(「我渴了」→取饮料)、细粒度语言纠正(「往左挪一点」)、多步视觉编程、行为常识(摆餐具)、估计物体物理属性等。
Strengths and Limitations
Strengths:真正零样本、免训练、免原语,靠 LLM 写码 + VLM 接地就能合成密集 6-DoF 轨迹;value map 可组合、可解释;闭环重规划对扰动鲁棒;可选在线动力学学习覆盖接触任务。
局限(分析):依赖 VLM/检测的接地精度与深度观测质量,感知错则满盘皆错;value map 表达的是「往哪去/避什么」,对精细朝向/接触力这类语义刻画有限(CoPa 正是补这块);规划质量受体素分辨率与代价地形设计影响;对高度灵巧、多指接触的任务,纯规划难敌学习到的策略。
Takeaways
VoxPoser 展示了一条 training-free 管线:让 LLM 生成代码,把语言条件转成 3D value map,再交给运动规划器。在论文规定的仿真与 Franka 任务中,这一方法无需额外训练任务策略;它不能被外推为对所有开放世界操作都有效。CoPa 和 ReKep 分别把接地表示扩展到部件级几何约束与关系关键点约束。
CoPa
CoPa: General Robotic Manipulation through Spatial Constraints of Parts with Foundation Models
一句话把接地下沉到物体部件:用粗到细的 grounding 定位「任务相关部件」,让 VLM(GPT-4V)生成这些部件的空间几何约束(如锤头要在钉子正上方、轴线竖直),再解出抓取之后的一串 6-DoF 位姿;开放世界、免训练。
年份 / Venue arXiv preprint, 2024 | 机构 Tsinghua IIIS · Shanghai Qi Zhi · SJTU · Shanghai AI Lab(Yang Gao 组)| 方向 Part-level VLM grounding, task-aware planning | 真机 ✅ Franka,开放世界桌面操作
BibTeX
@article{huang2024copa,
  title   = {{CoPa}: General Robotic Manipulation through Spatial Constraints of Parts with Foundation Models},
  author  = {Huang, Haoxu and Lin, Fanqi and Hu, Yingdong and Wang, Shengjie and Gao, Yang},
  journal = {arXiv preprint arXiv:2403.08248},
  year    = {2024},
  url     = {https://arxiv.org/abs/2403.08248}
}
Motivation
基础模型的 web 级常识对任务规划很有用,但把计划物理落地往往还得靠任务专属学习——要采数据、难泛化。VoxPoser 那种 value map 擅长「去哪/避什么」,却难精确表达朝向与部件级几何(比如「用锤头砸钉子」要求锤头朝下、对准钉子)。CoPa 想只用基础模型的常识,零训练地生成一串 6-DoF 末端位姿,尤其把「任务相关部件之间的空间几何关系」显式刻画出来。
Method
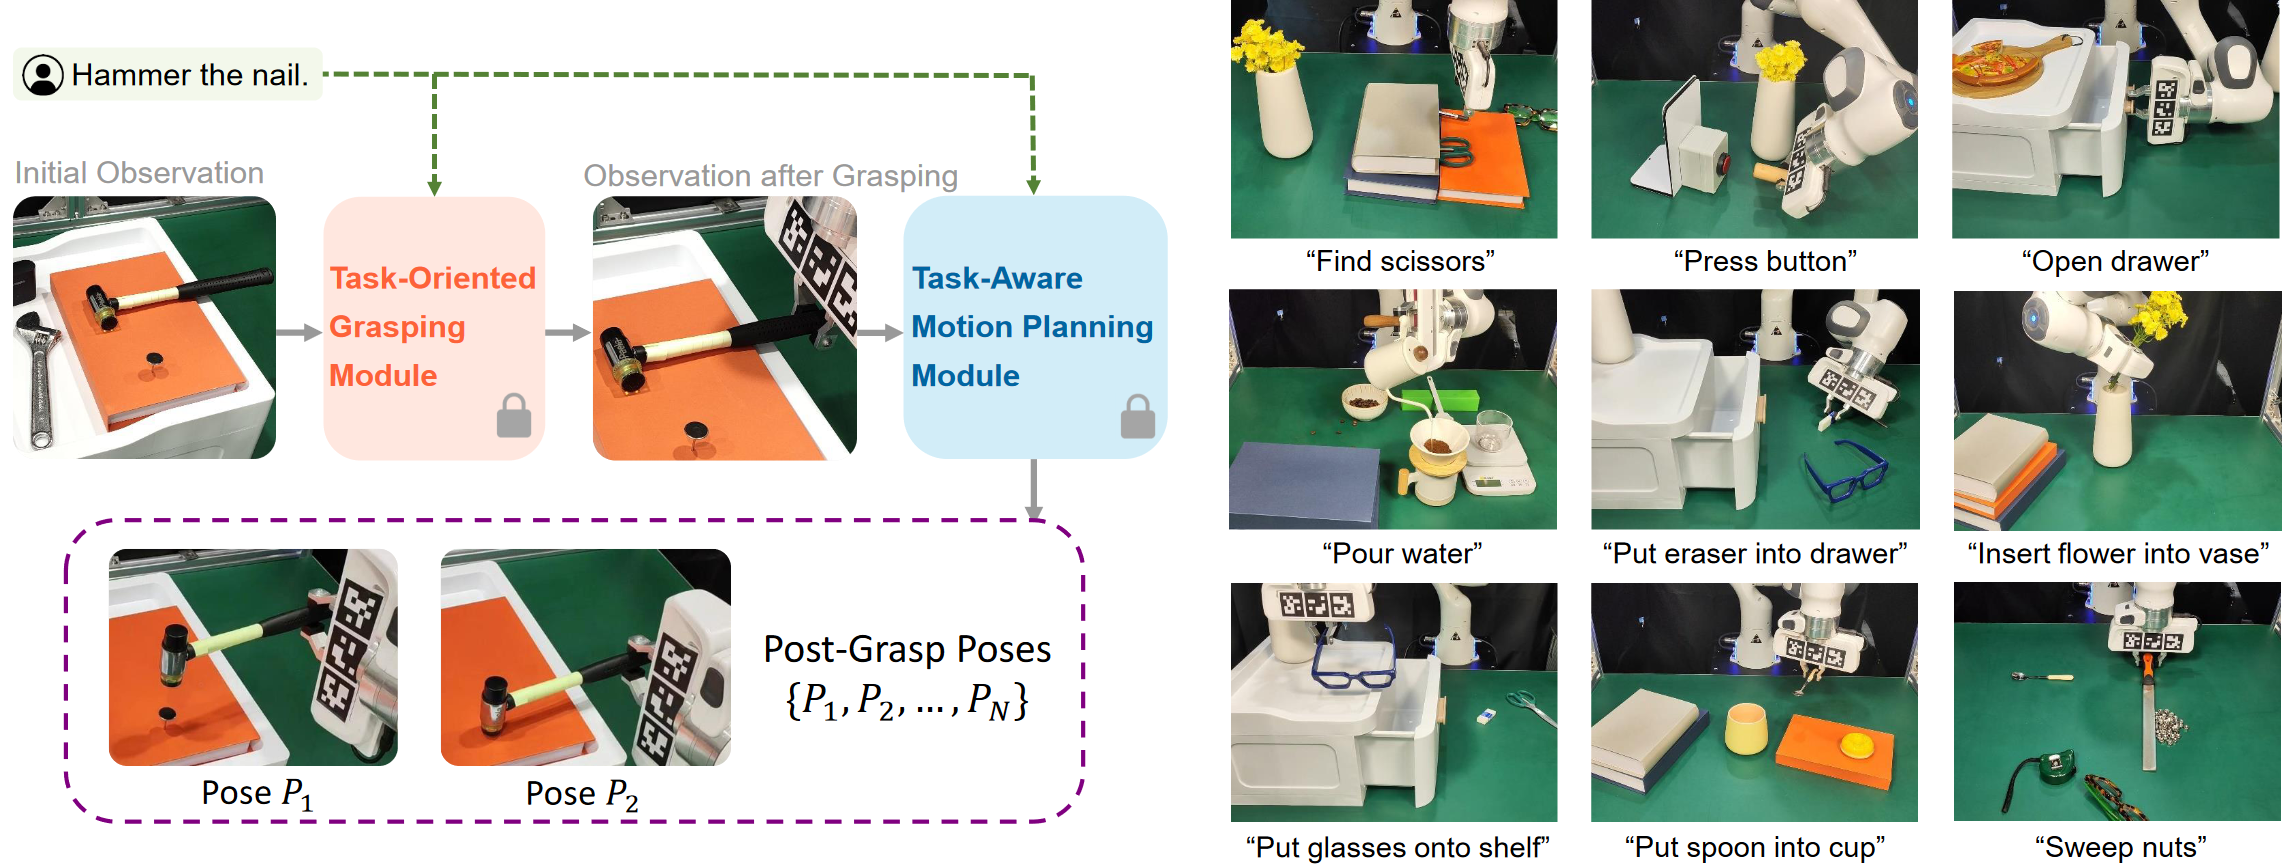
CoPa 把一次操作拆成两个模块(都由基础模型驱动、无需训练):
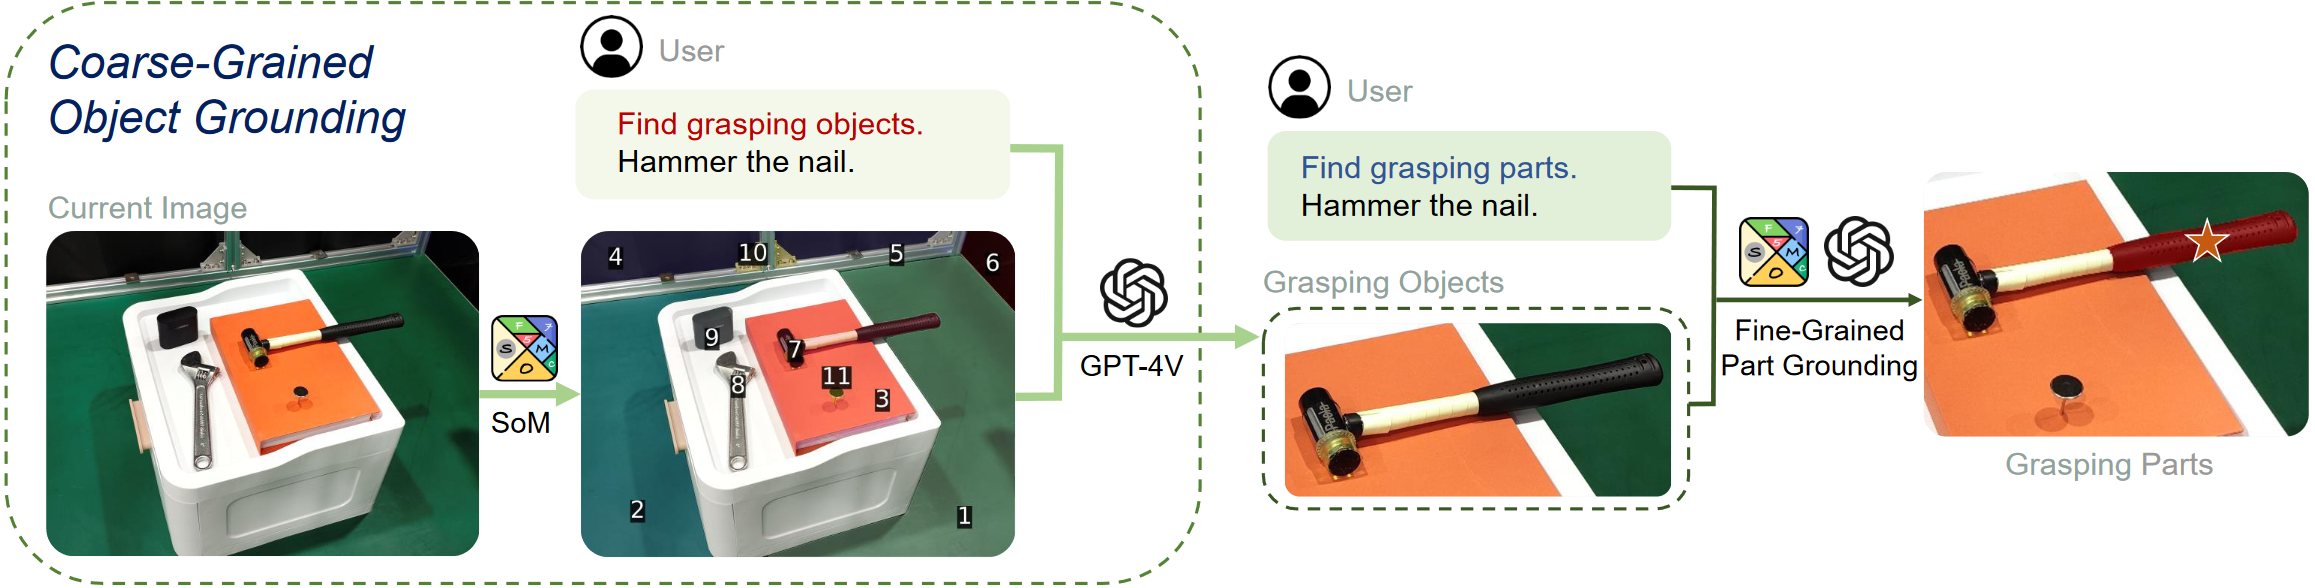
- Task-Oriented Grasping Module(任务导向抓取):粗到细 grounding——先用分割 + Set-of-Mark 标注让 GPT-4V 在粗粒度选出要抓的物体,再在细粒度选出具体抓取部件的 mask;抓取候选由抓取基础模型(GraspNet/AnyGrasp 类)在点云上生成,用 grounded 的部件筛出合适抓取位姿。
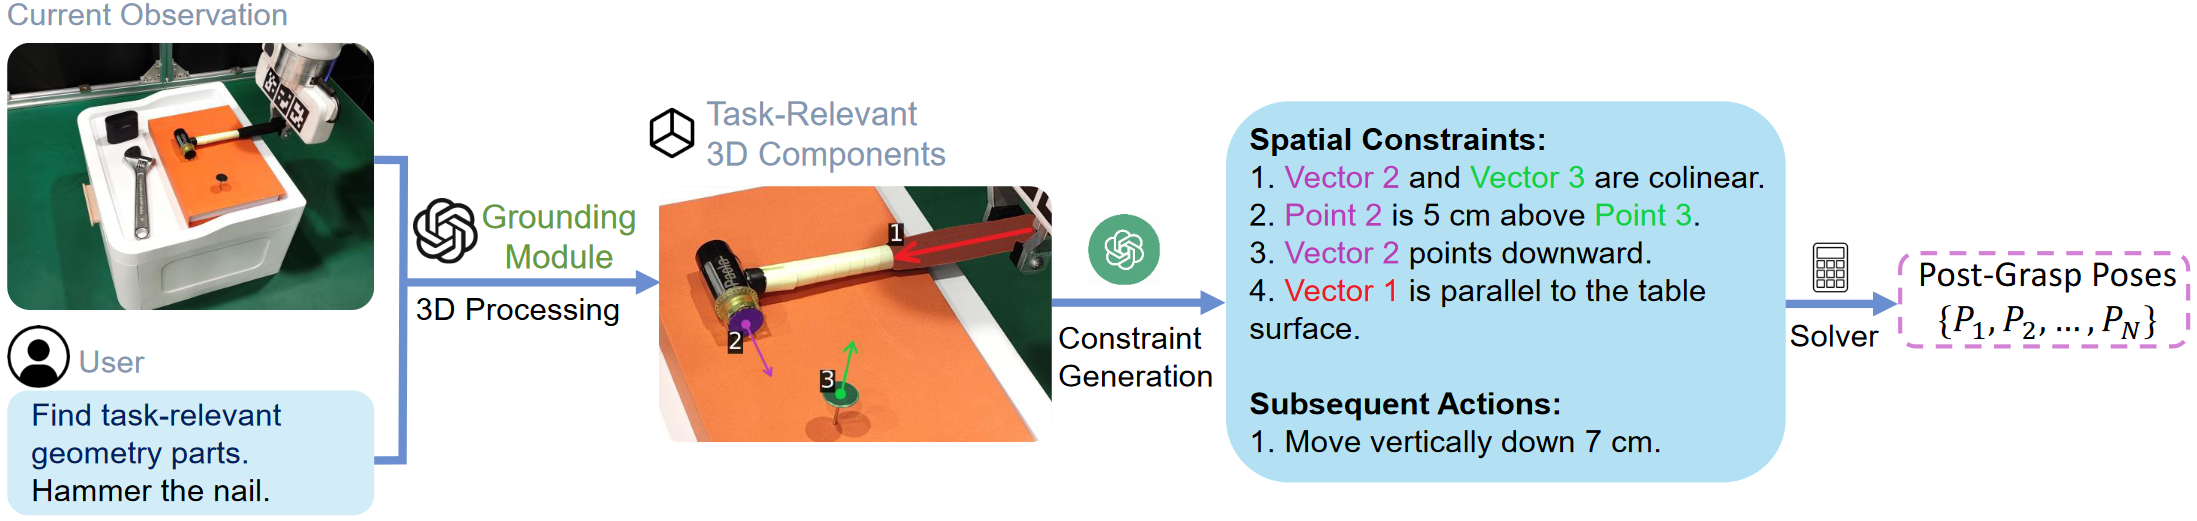
- Task-Aware Motion Planning Module(任务感知运动规划):抓取后,模型识别任务相关部件并在 3D 中建模,把部件几何投影/标注回图像,让 VLM 生成这些部件的空间约束(如「瓶口朝下」「锤头在钉子正上方」),再由求解器据约束算出抓取后的位姿序列 。
- 基础模型班底:GPT-4V(选择与约束生成)、GroundingDINO / SAM(检测与分割)、GraspNet/AnyGrasp 类(抓取候选)、SoM(Set-of-Mark 提示)。
- 可接高层规划:对长时程任务,可在上层接一个 LLM 任务规划器,把复杂指令拆成子任务再逐个交给 CoPa。
Experiments
- 设置:真机(Franka)开放世界桌面操作,任务如「锤钉子、把花插进花瓶、按按钮、把橡皮放进抽屉、倒水、把勺子放进杯子、扫坚果」等——多数强依赖朝向/部件几何,正是 value-map 式方法的短板。
- 对照:与直接让 VLM 出位姿、以及缺乏部件约束的基线相比,CoPa 在需要精确朝向的任务上更稳;逐任务成功率数值未从原文表格逐一核到,此处只引用「部件空间约束显著改善朝向敏感任务」这一定性结论。
- 长时程:接高层 LLM 规划器后可完成多步任务(如做简单料理/整理),验证模块化可组合。
Strengths and Limitations
Strengths:把接地精度提到部件级,能刻画 value map 难表达的朝向/几何约束;两模块解耦(抓取 / 抓取后规划)清晰可组合;纯基础模型、零训练、开放指令与开放物体;可与高层规划器堆叠做长时程。
局限(分析):管线较长(分割 + 抓取模型 + 多次 VLM 调用),环节多则误差累积、时延高;依赖 GPT-4V 对部件与几何约束的判断,复杂/遮挡场景易错;约束是几何规则而非学习到的接触技巧,对柔性物、力控精细任务能力有限;正式 benchmark 数值需回原文核对。
Takeaways
CoPa 将 VoxPoser 的场景级 value map 思路推进到部件级几何约束,重点处理对物体朝向敏感的操作。它与 ReKep 都使用 VLM 生成几何约束再优化位姿;区别在于 ReKep 将约束统一为关系关键点上的可微代价并进行闭环重规划,而 CoPa 更偏向“抓取位姿 + 抓取后位姿”的分段规划。
ReKep
ReKep: Spatio-Temporal Reasoning of Relational Keypoint Constraints for Robotic Manipulation
一句话把操作任务写成关系关键点上的时空约束——一组 Python 代价函数,把若干 3D 关键点映射到标量代价;大视觉模型 + VLM 从语言与 RGB-D 自动生成这些约束,再用分层优化实时解出 SE(3) 位姿序列,支持多阶段、双臂、反应式。
年份 / Venue arXiv preprint, 2024 | 机构 Stanford · Columbia(Fei-Fei Li / Yunzhu Li)| 方向 Keypoint constraints, hierarchical optimization | 真机 ✅ 移动单臂 + 固定双臂,in-the-wild
BibTeX
@article{huang2024rekep,
  title   = {{ReKep}: Spatio-Temporal Reasoning of Relational Keypoint Constraints for Robotic Manipulation},
  author  = {Huang, Wenlong and Wang, Chen and Li, Yunzhu and Zhang, Ruohan and Fei-Fei, Li},
  journal = {arXiv preprint arXiv:2409.01652},
  year    = {2024},
  url     = {https://arxiv.org/abs/2409.01652}
}
Motivation
把操作任务表达成「关联机器人与环境的约束」是一条有前途的路,但约束怎么写才能同时满足三点:① 通用于各种任务、② 免人工标注、③ 能被现成求解器实时优化出动作。此前的约束表示往往顾此失彼。ReKep 想给出一种视觉接地的约束表示,让大模型自动生成、求解器实时求解,从而在真实世界里做多阶段、双臂、反应式操作。
Method
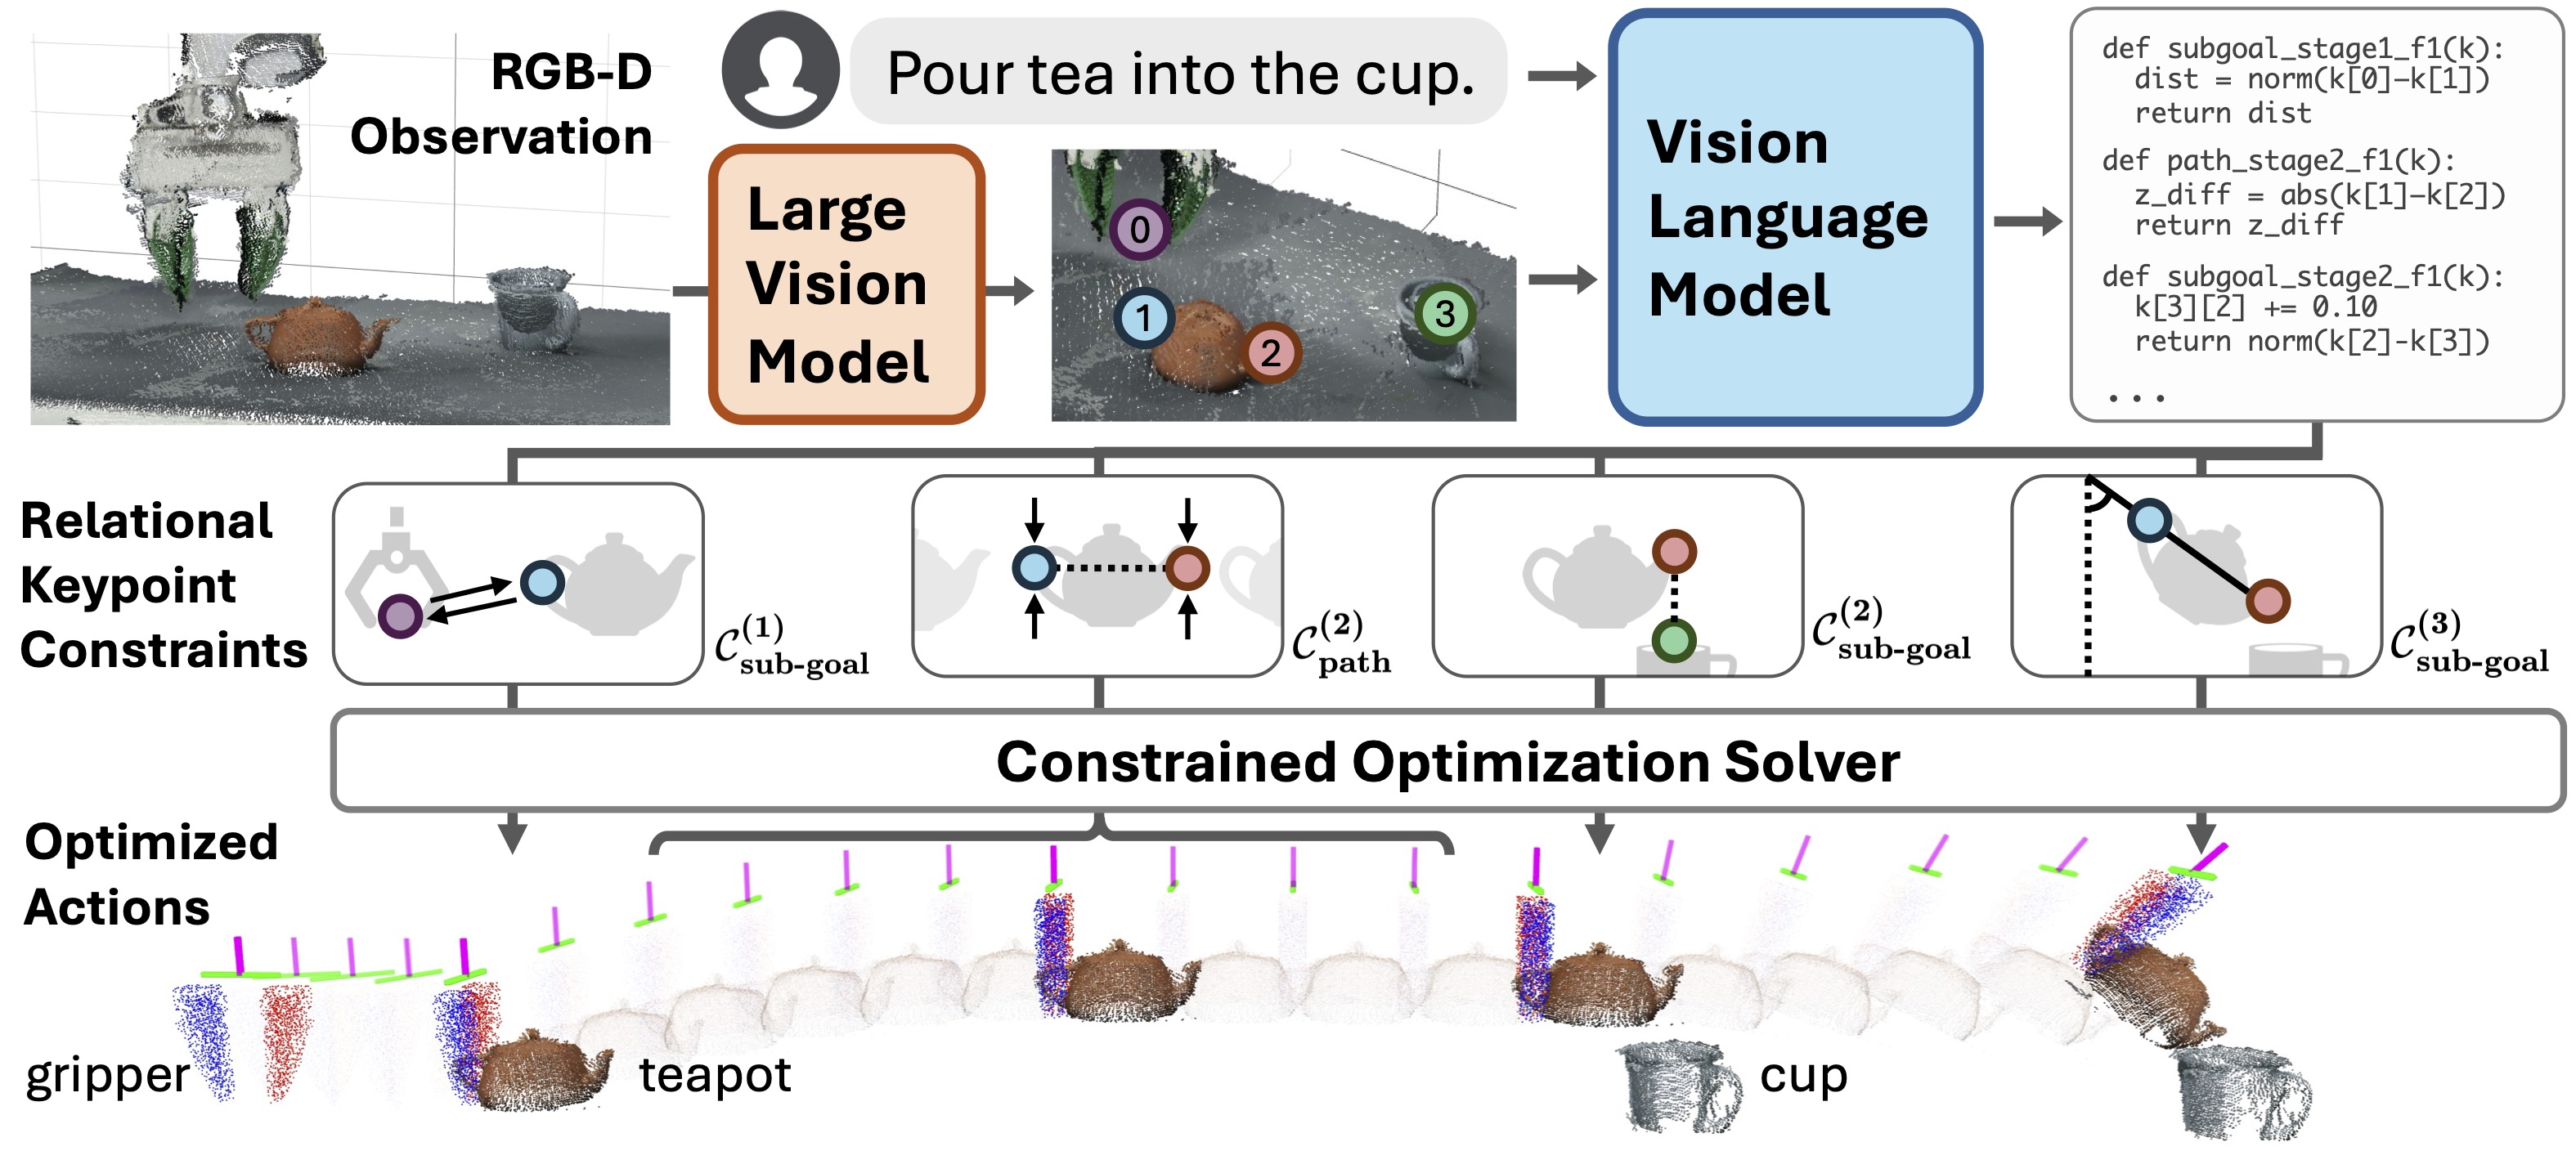
- Relational Keypoint Constraints(ReKep):把任务写成一组 Python 函数,输入是环境里一组 3D 关键点,输出是一个标量代价(满足→0,违反→正)。用「关系关键点」既能表达机器人与物体、也能表达物体与物体之间的几何关系。
- 两类约束:
- sub-goal 约束:刻画某个阶段末要达成的关键点关系(如「壶嘴对准杯口」)。
- path 约束:刻画阶段全程要保持的关系(如「端平不洒」)。
- 一个任务 = 一串(分阶段的)sub-goal + path 约束。
- 自动生成:DINOv2(+ SAM)在细粒度有意义区域上提议关键点候选并做 Set-of-Mark;GPT-4o 读语言指令 + 标注图像,写出上述 Python 约束程序——无需为每个新任务手工指定。
- 分层优化:高层在离散的阶段/子目标间决策,低层用现成求解器把约束优化成 SE(3) 末端位姿序列;因关键点被实时跟踪,系统能在感知-动作闭环里以实时频率重规划 → 反应式(物体被挪动也能跟上)。
- 全程免任务专属训练、免环境模型。
Experiments
- 平台:移动单臂(wheeled single-arm)与固定双臂(stationary dual-arm)两套真机。
- 任务:in-the-wild(收书、倒茶、封箱、回收易拉罐)、双臂协作(装鞋、协同叠衣、叠毛衣)、以及用新策略叠各类衣物(毛衣/衬衫/连帽衫/背心/裙/裤/短裤/围巾);展示多阶段与反应式(关键点被扰动后闭环纠正)。
- 结果口径:公开材料主要通过多阶段、移动单臂和固定双臂案例展示系统能力;由于不同任务没有统一成功率口径,本文不汇总成单一百分比。
Strengths and Limitations
Strengths:约束表示统一而通用(一个 Python 代价框架涵盖 sub-goal/path、机器人-物体/物体-物体、单/双臂);大模型自动生成、免人工标注;用现成求解器实时闭环、天然反应式;覆盖 in-the-wild 与双臂等硬场景。
局限(分析):强依赖关键点检测与实时跟踪的稳定性——关键点漂移/遮挡会直接坏掉约束;GPT-4o 写错约束程序则行为错,且难自查;关键点是稀疏几何,对纹理/形变复杂(如布料精细褶皱)的刻画有上限;求解质量与实时性受求解器与关键点数量制约。
Takeaways
ReKep 将语言模型生成的任务约束表示为关系关键点上的可微代价,并结合关键点跟踪与分层优化,在论文中展示了实时重规划、多阶段任务和双臂案例。与 VoxPoser、CoPa 相比,它更强调时序约束与反馈重规划;本文不对“首次”或产品成熟度作超出公开实验的判断。
Cross-Paper Comparison
| 论文 | 空间表示 | 谁来接地 | 谁来求解 | 闭环/反应式 | 强项 | 局限(分析) |
|---|---|---|---|---|---|---|
| VoxPoser | 3D value map(体素) | LLM 写码 + VLM 检测 | 基于模型的运动规划 | 每步重规划 | 零样本合成 6-DoF、可组合、可解释 | 难刻画精细朝向/接触 |
| CoPa | 部件空间约束 | GPT-4V + 分割/抓取模型 | 约束求解(抓取后位姿) | 分段规划 | 部件级几何、朝向敏感任务强 | 管线长、误差累积、时延 |
| ReKep | 关系关键点约束 | DINOv2 + GPT-4o | 分层优化(现成求解器) | 实时闭环、反应式 | 统一约束、双臂、实时 | 依赖关键点跟踪、稀疏几何 |
Discussion
把三篇连起来看,它们共享同一套范式,却在「表示的结构化程度」和「求解的实时性」上逐步进化:
-
共同信念:接地 ≠ 训练策略。三篇都拒绝「端到端学一个 policy」,而是让基础模型只做它最擅长的语义→几何接地,把「几何→动作」交给几十年积累的规划/优化。好处是零样本、可解释、免真机数据;这与 Robot Learning (2) 的 π0 系列(堆万小时真机数据学连续策略)形成鲜明对照——一条省数据、一条省先验。
-
表示越来越结构化。VoxPoser 的 value map 是「稠密标量场」,擅长「去哪/避什么」;CoPa 把它下沉到部件几何约束,补上朝向;ReKep 再抽象成关系关键点上的可微代价,用少数关键点统一表达机器人-物体、物体-物体、单臂-双臂的关系。表示越结构化,越能表达精细任务,但也越依赖对应的感知(检测 / 部件分割 / 关键点跟踪)。
-
从「规划一次」到「实时反应」。VoxPoser/CoPa 更偏「解出一条轨迹/一串位姿再执行」,ReKep 靠关键点实时跟踪 + 分层优化做到感知-动作闭环,物体被挪也能跟——这是把 training-free 路线推向真实动态环境的关键一步。
-
与端到端 VLA 的互补。这条线的天花板是感知精度(深度/关键点错则全错)与优化器的动作质量(不会「学」出灵巧接触技巧);VLA 的天花板是数据(要海量真机示范)与可解释性。可预见的融合是:用这类几何约束/关键点作为 VLA 的中间监督或推理脚手架(如 π0.5 的「先语义子任务再动作」、ReKep 的关键点可作 affordance 提示),让「大模型的语义」「显式的几何」「学习到的连续控制」三者各取所长。
对后续 embodied foundation model 的启发是:value map、部件约束和关键点会改变系统可表达的任务、所需感知输入与优化复杂度。Training-free 方法在若干开放词汇任务中减少了任务级策略训练,但在高频接触、感知失败和长时误差恢复方面仍有限;它们可以与学习策略结合,也可以继续沿显式规划路线改进,现有证据尚不能断言唯一方向。