
本系列从三个相互依赖的层面讨论具身 AI 技术栈:预训练模型、后训练算法、数据与规模化。本篇聚焦预训练模型的结构与训练目标。
本文把具身智能中的预训练模型分成三类相互交叉的路线。它们并不是严格按时间替代的“三代”:VLM 提供视觉—语言表征,VLA 学习动作条件分布,WAM 额外建模未来观测或视频;当前系统经常组合其中两类或三类能力。
VLM(看懂)→ VLA(会动)→ World Action Model(能想象)
- VLM(Vision-Language Model):联合建模图像、视频与文本,为语义理解和视觉定位提供表征。
- VLA(Vision-Language-Action):将视觉、语言和动作统一建模;动作可由离散 tokenizer、连续生成模型或独立 action expert 表示,并非都只是“接一个动作头”。
- World Action Model(WAM,世界动作模型):联合预测动作与未来观测,或在训练时用未来视频作为辅助监督;是否在推理时显式生成视频取决于具体架构。
下面按这个顺序展开。每个家族挑几个代表模型,必要处配上算法框架图。
一、VLM:多模态感知的通用底座
VLM 的典型骨架是:视觉编码器把图像编码成视觉 token,适配器或跨模态模块将其接入语言模型。VLA 和 WAM 常复用这类感知与语义表征,但闭环策略还受到动作数据、控制频率、时序建模和后训练方法等因素影响,不能只由视觉塔性能推断上限。
Qwen2.5-VL
Qwen2.5-VL 是阿里通义发布的开放权重多模态模型。相比早期 Qwen-VL,它改进了动态分辨率、视频时间建模、视觉定位和文档解析;这些能力使其适合作为具身系统的候选视觉—语言底座,但实际效果仍需在目标机器人数据上验证。技术报告
- 原生动态分辨率(native dynamic resolution):按图像尺寸与长宽比生成可变数量的视觉 token,减少固定尺寸缩放造成的信息损失;效果仍受最大 token 预算和预处理限制。
- 绝对时间编码的视频理解:把时间信息显式编码进位置,能处理长视频并定位到具体时刻(事件发生在第几秒),这对机器人”看视频学动作”很关键。
- 强 grounding 与文档解析:精确的框/点定位、表格与文档结构解析,天然适合把”语言指令”接地到”画面里的物体”。
- Agent 能力:能作为视觉 agent 操作界面、调用工具。
一句话:Qwen2.5-VL 把”看懂图 + 定位物体 + 读懂文档 + 理解长视频”打包成一个可直接微调的底座。
Qwen3-VL
Qwen3-VL 在 Qwen2.5-VL 之后增加 interleaved-MRoPE、DeepStack 多层视觉特征注入和文本时间戳对齐,并提供 dense 与 MoE 两类模型。官方报告覆盖长上下文、长视频、视觉推理与 GUI agent 等评测;这些结果说明它具备更强的多模态骨干能力,但不能直接等同于机器人闭环控制能力。技术报告
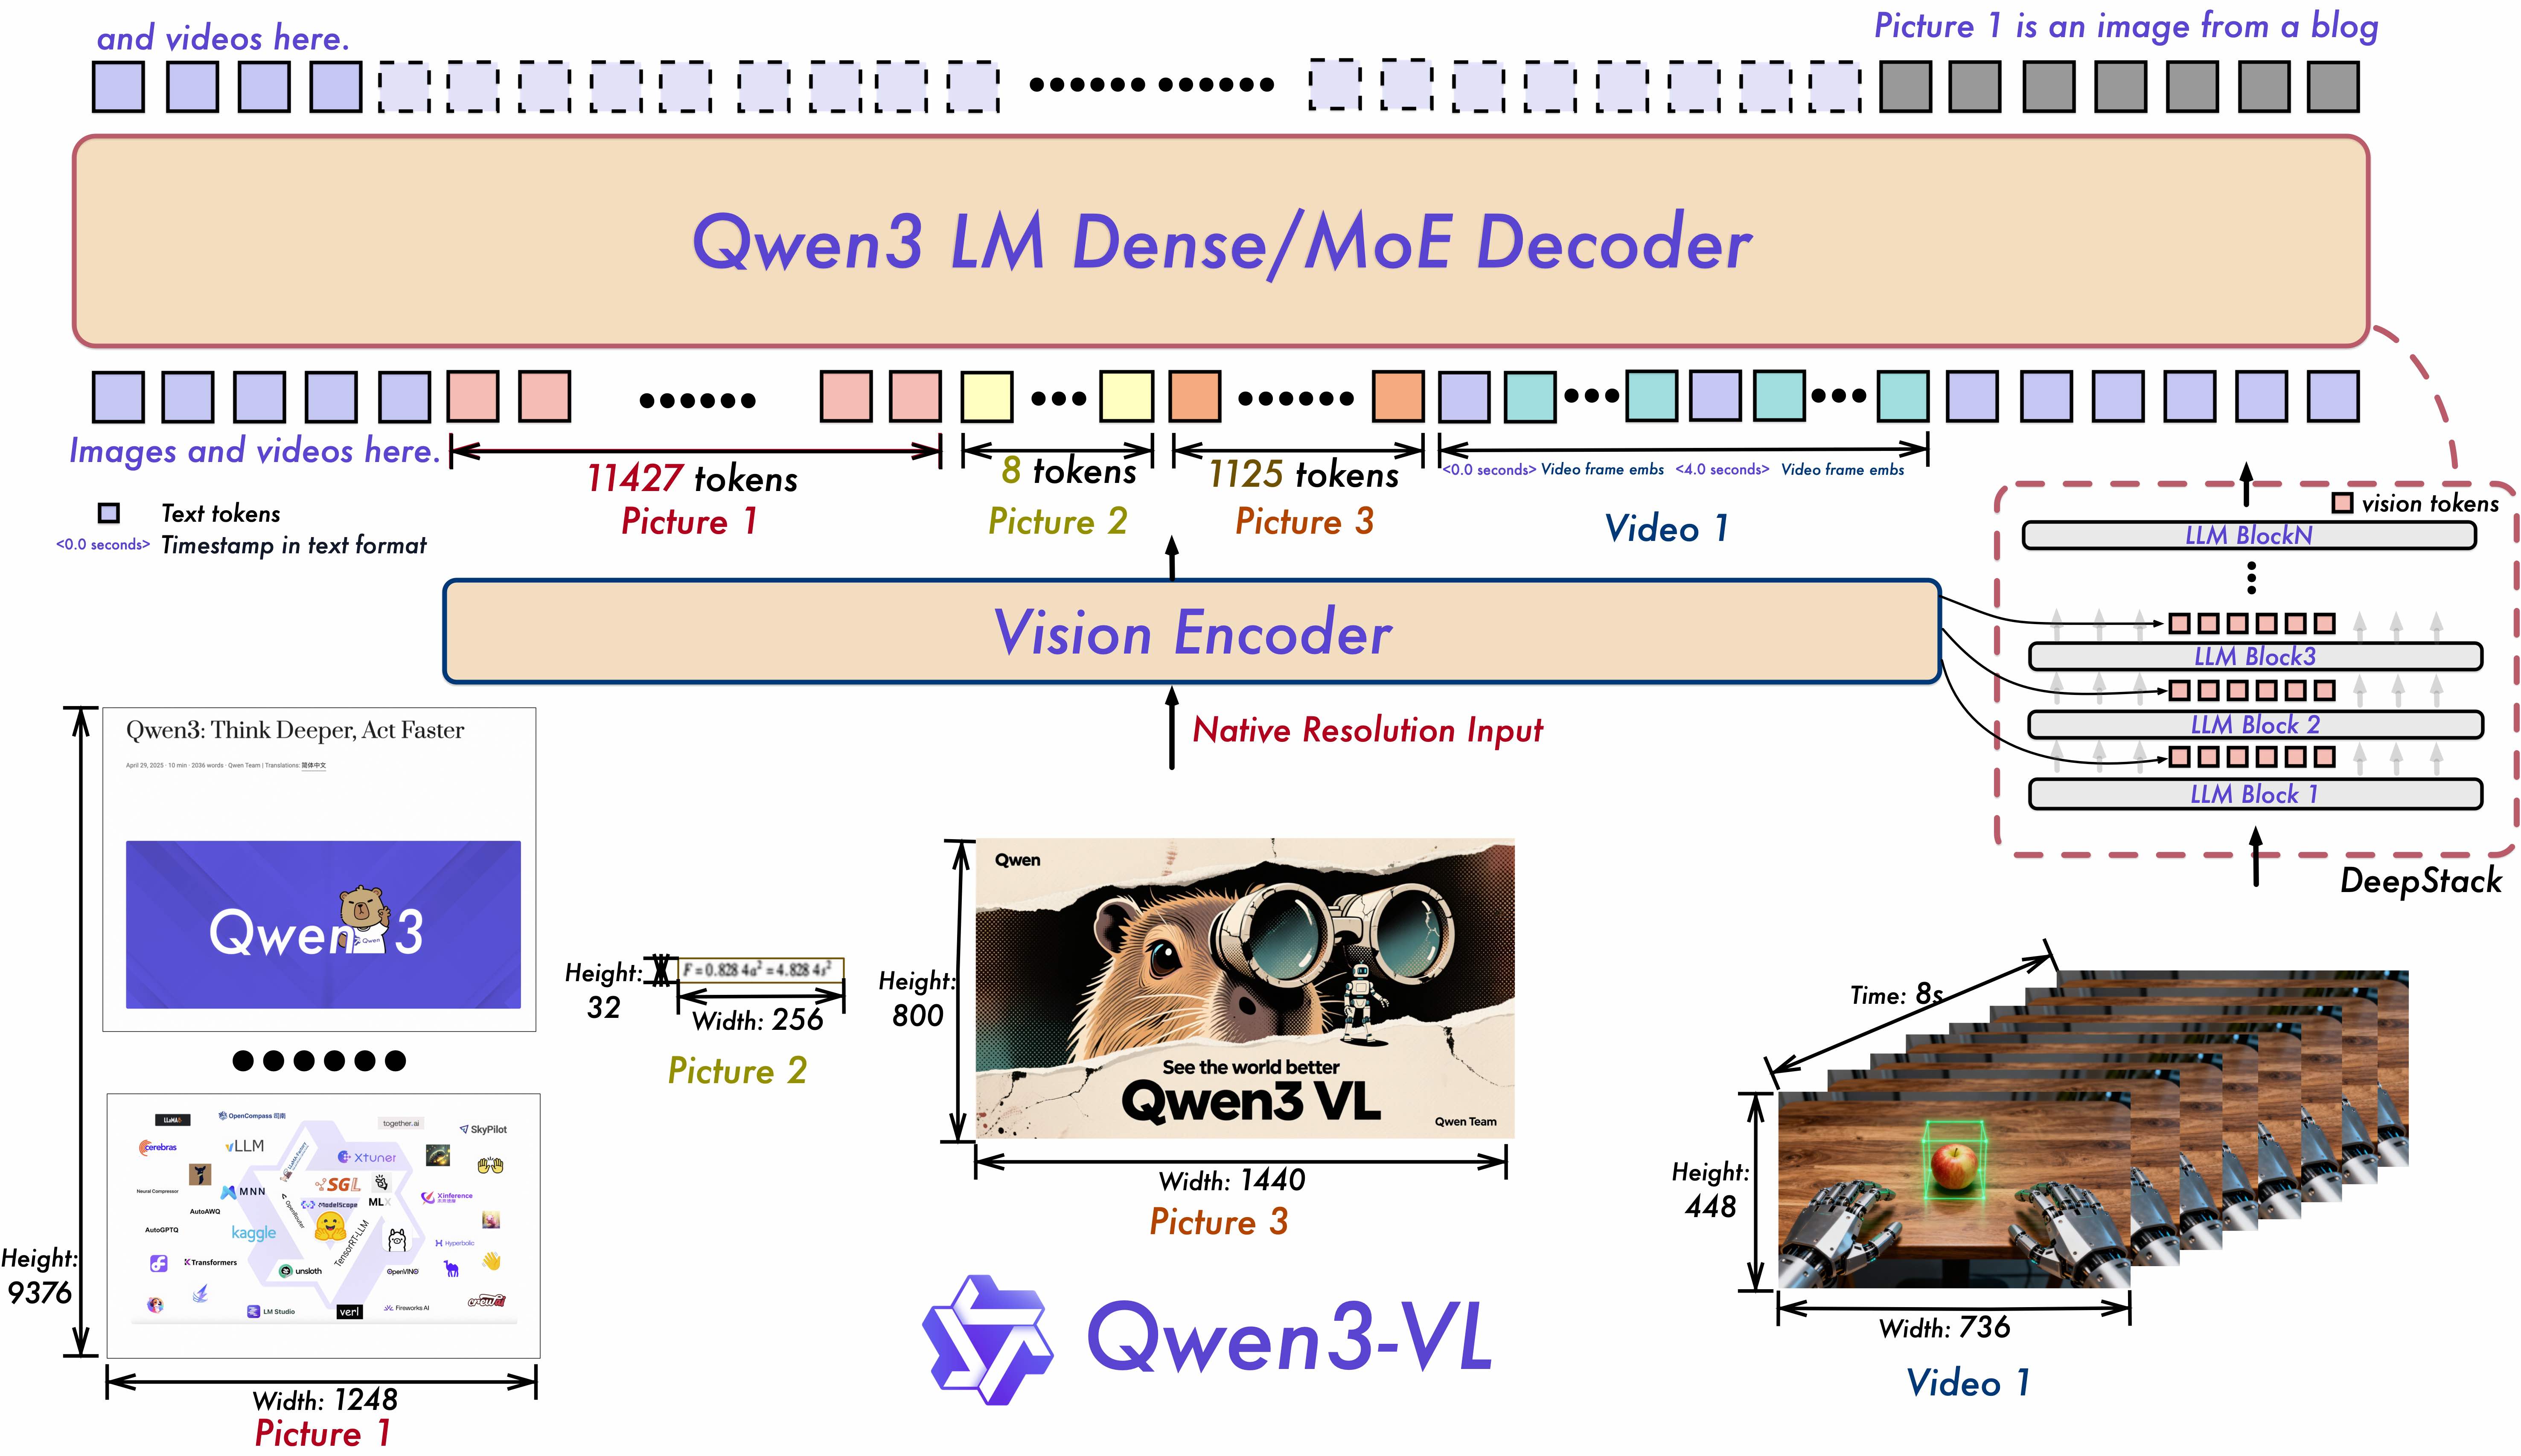
从 Qwen2.5-VL 到 Qwen3-VL,趋势很清楚:VLM 不再只是”图像问答器”,而是越来越像一个能感知、能定位、能操作的通用多模态智能体骨干。
Qwen3-VL-MoE
Qwen3-VL 同时提供 dense 与 MoE 变体。MoE 将部分 FFN 层拆成多个专家,并让每个 token 只激活其中少数专家,因此总参数量可以大于单次前向的激活参数量;实际延迟和显存还受到路由、通信、batch size 与部署框架影响。
不同专家可能形成一定的路由专门化,但是否按模态或任务分工需要专门的路由分析才能判断。MoE 的主要工程动机是提高参数容量与单次激活计算量之间的比值,而不是保证推理成本不增加。
二、VLA:给底座接上”动作头”
VLA 在视觉和语言条件之外进一步建模机器人动作。动作可能具有连续、高频和跨本体等特征,因此需要明确动作表示、时间离散化、控制接口以及它们与语言 token 的联合训练方式。
π₀(pi-zero)
Physical Intelligence 的 VLA 模型之一。它在一个 VLM(PaliGemma,约 3B)之上接入从零训练的“动作专家”模块,用 flow matching(流匹配,一类学习连续概率路径向量场的生成方法)来生成连续动作块。扩散路径可以写成 flow matching 的一种概率路径,但两者不宜直接当作同义词:
- 动作专家 + flow matching:在噪声与真实动作块之间构造条件概率路径,网络回归对应向量场;推理时通过数值积分生成动作块。论文中的机器人控制数据以最高 50 Hz 记录/执行,但控制频率、动作块长度与积分步数是不同概念,不能互相推导。π0 论文
- 跨本体:用超过 1 万小时、7 种机器人配置(单臂/双臂/移动)的真机数据预训练,一个模型横跨多种本体。
- VLM 预训练的价值:完整架构相对”无 VLM”变体约有 >2× 的增益,印证了互联网级语义先验对动作学习的帮助。
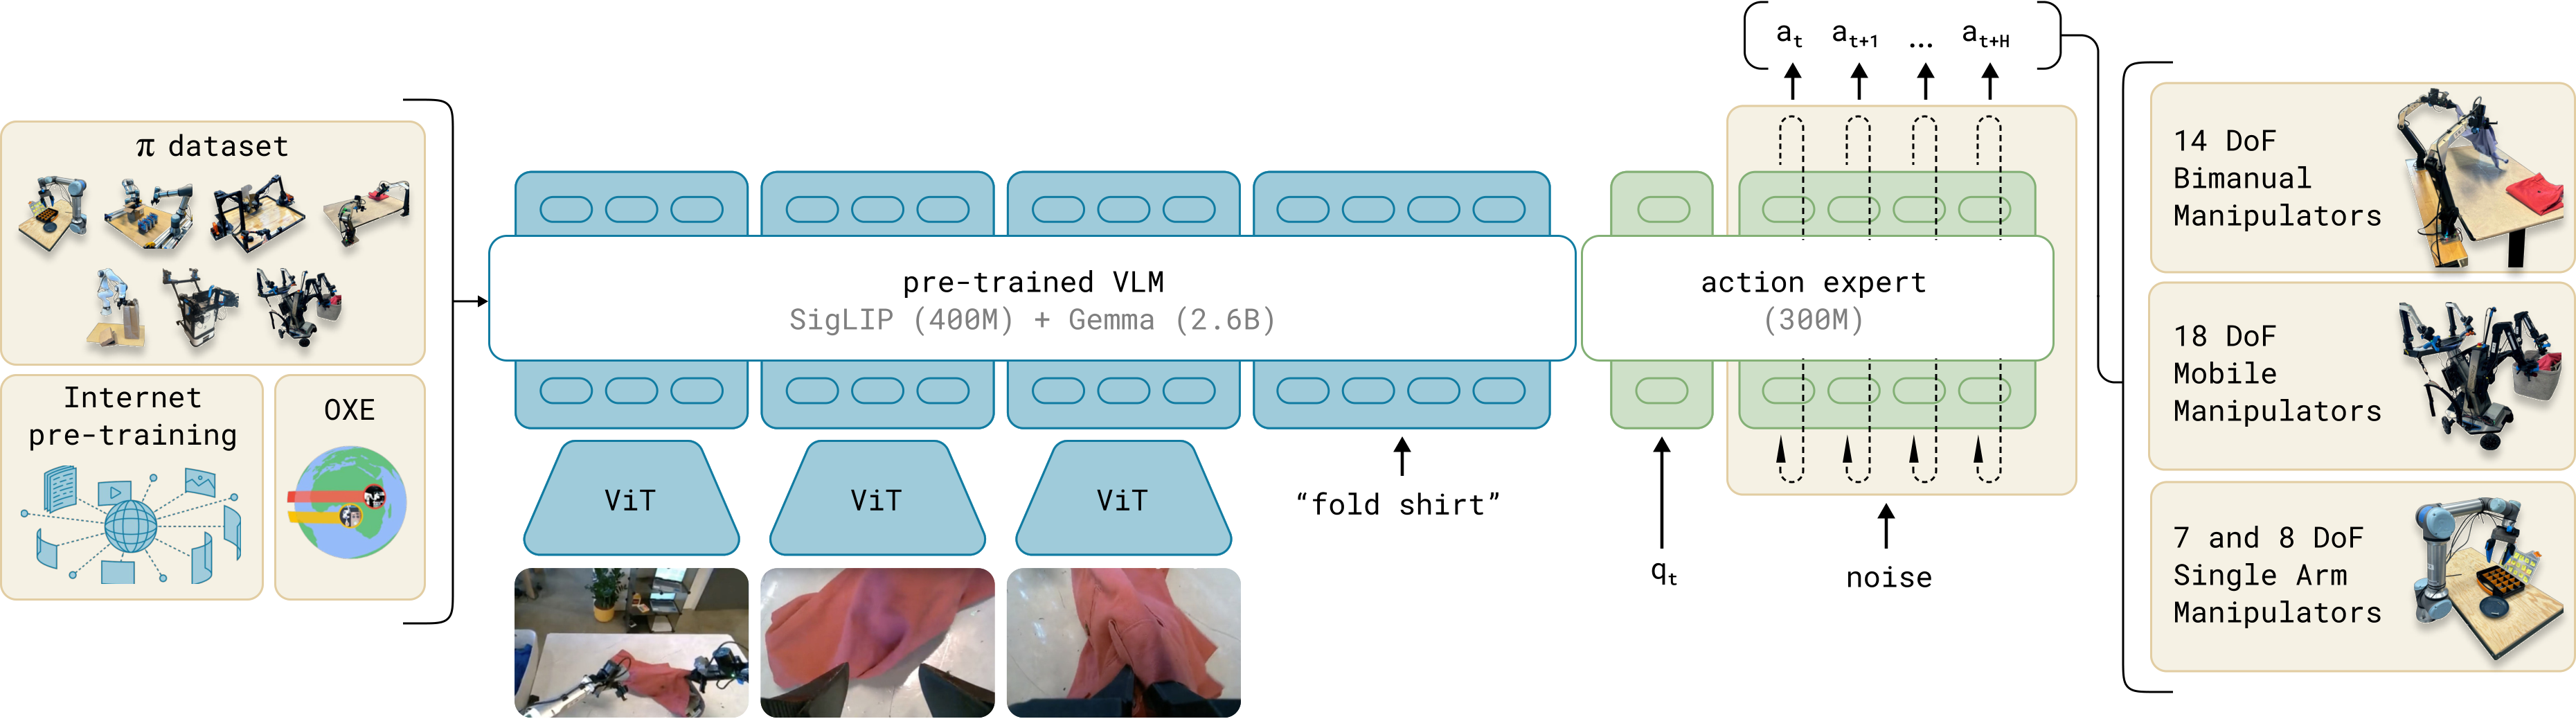
π₀ 之后的相关工作分别改进训练效率、跨环境泛化、推理延迟和经验学习。π₀.₅ 主要关注未见环境中的任务泛化。
π₀.₅(pi-0.5)
π₀ 虽灵巧,但主要在与训练分布相近的受控环境里管用。π₀.₅ 主攻开放世界泛化——目标是走进训练里从没见过的真实家庭里干多分钟长活。它的关键配方有两点:
- 异构数据 co-training:把图像、语言指令、物体检测、高层语义子任务、低层动作,连同多机器人示范 + web 数据一起联合训练,让知识跨抽象层级迁移(消融显示 web 数据对处理新物体很关键)。
- 分层推理(机器人版 CoT):推理时先用自然语言预测一个高层语义子任务(如”拿起枕头”),再据此产出低层电机动作;高层用离散自回归 token、低层用 flow matching。
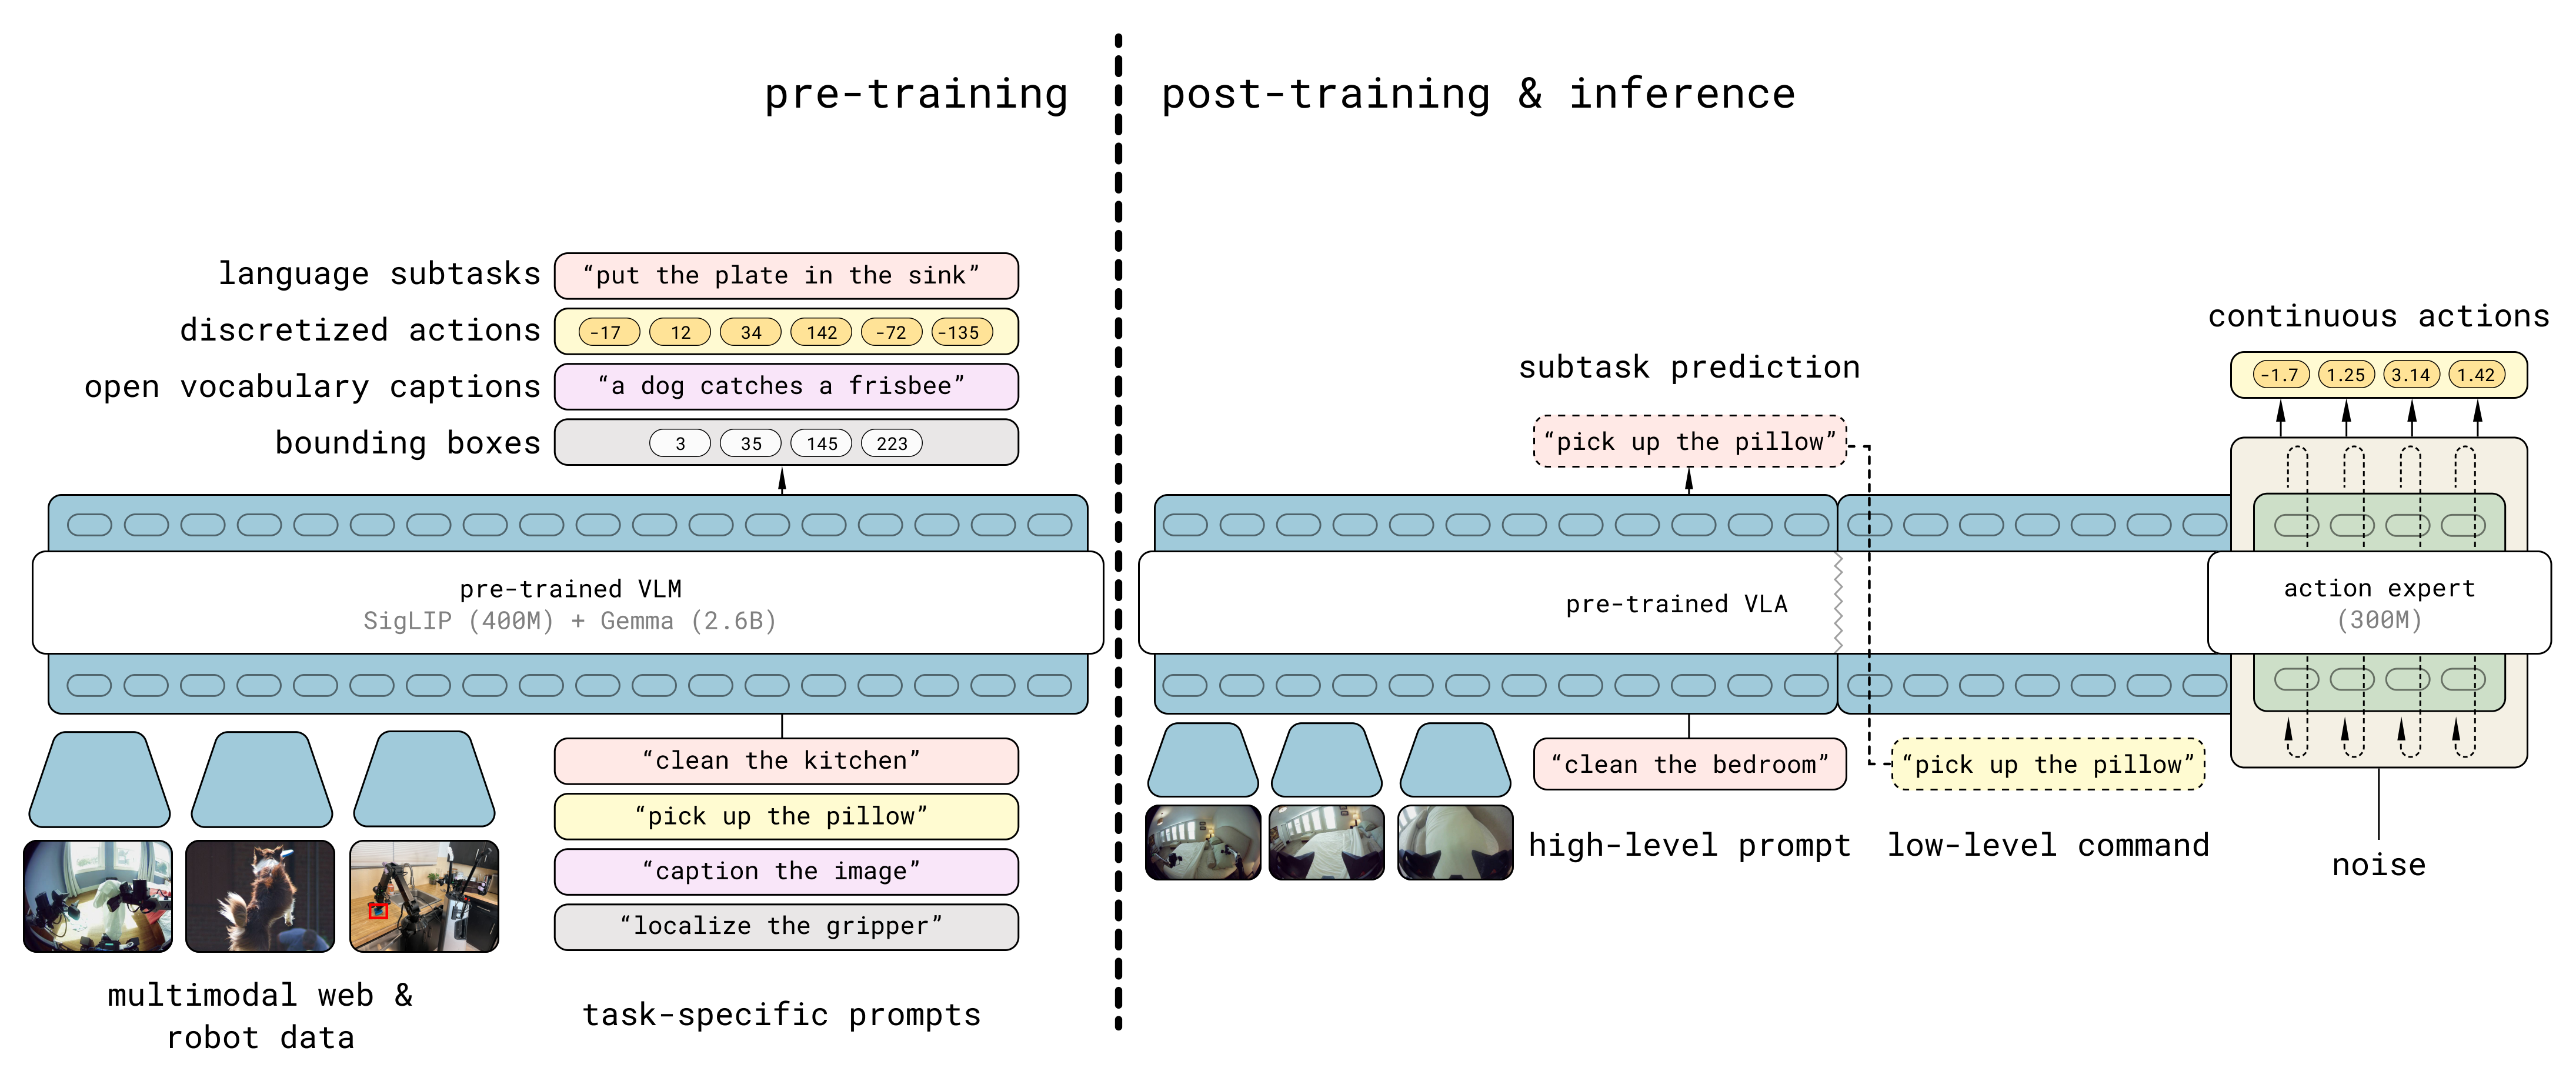
π₀.₅ 在论文评测中把 π₀ 扩展到未见过的家庭环境和较长任务,并显式采用“先预测高层子任务、再生成低层动作”的分层推理。它仍是研究系统;这些实验不等同于面向普通家庭的产品可用性。π0.5 论文
LingBot-VLA
LingBot-VLA 是蚂蚁 Robbyant(灵波科技)具身基础大模型矩阵里的 VLA(视觉-语言-动作) 成员。和 π 系一样,它属于”VLM 感知底座 + 动作生成”的范式:用强多模态编码器理解场景与语言指令,再产出可执行的机器人动作,目标是跨任务、跨场景的通用操作。作为 Robbyant “感知(LingBot-Vision/Depth)→ 行动(LingBot-VLA)→ 世界(LingBot-World/VA)“整套矩阵的一环,它承担的是”把理解直接变成动作”的角色。
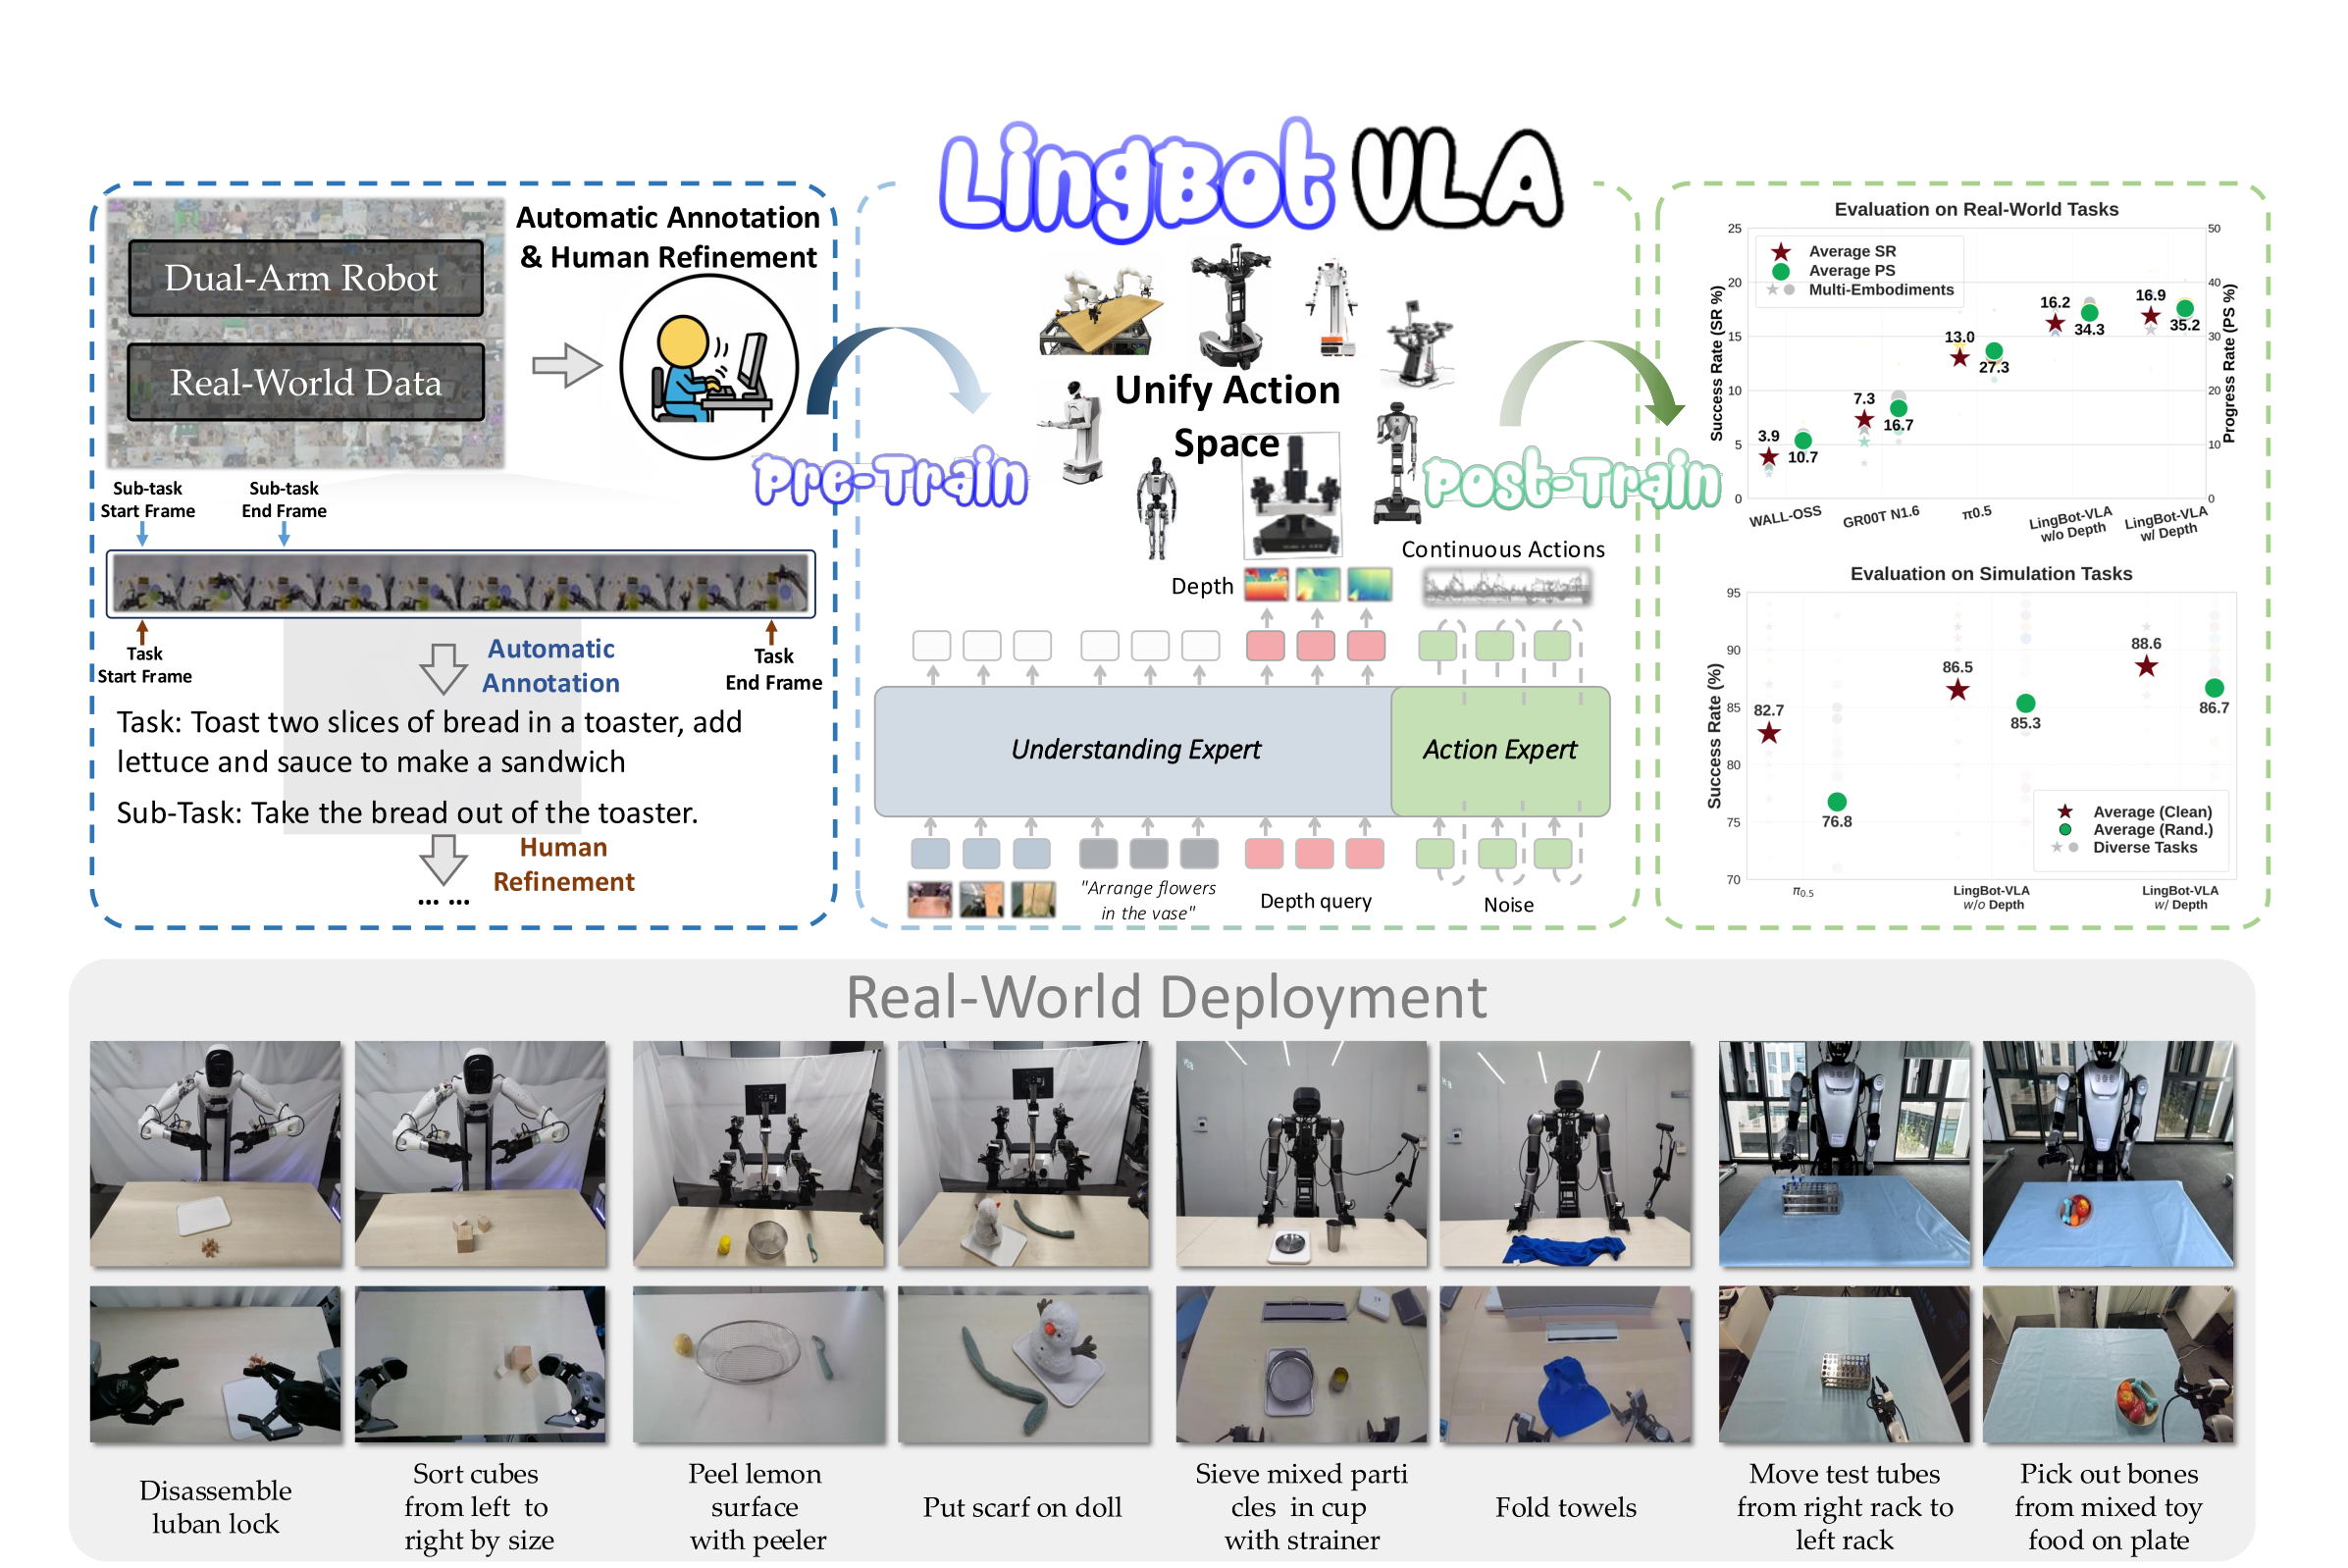
说明:LingBot-VLA 的具体指标以 Robbyant 官方页面 为准;本文只做范式定位,不逐字引用未核实的数值。
LingBot-VLA 2.0
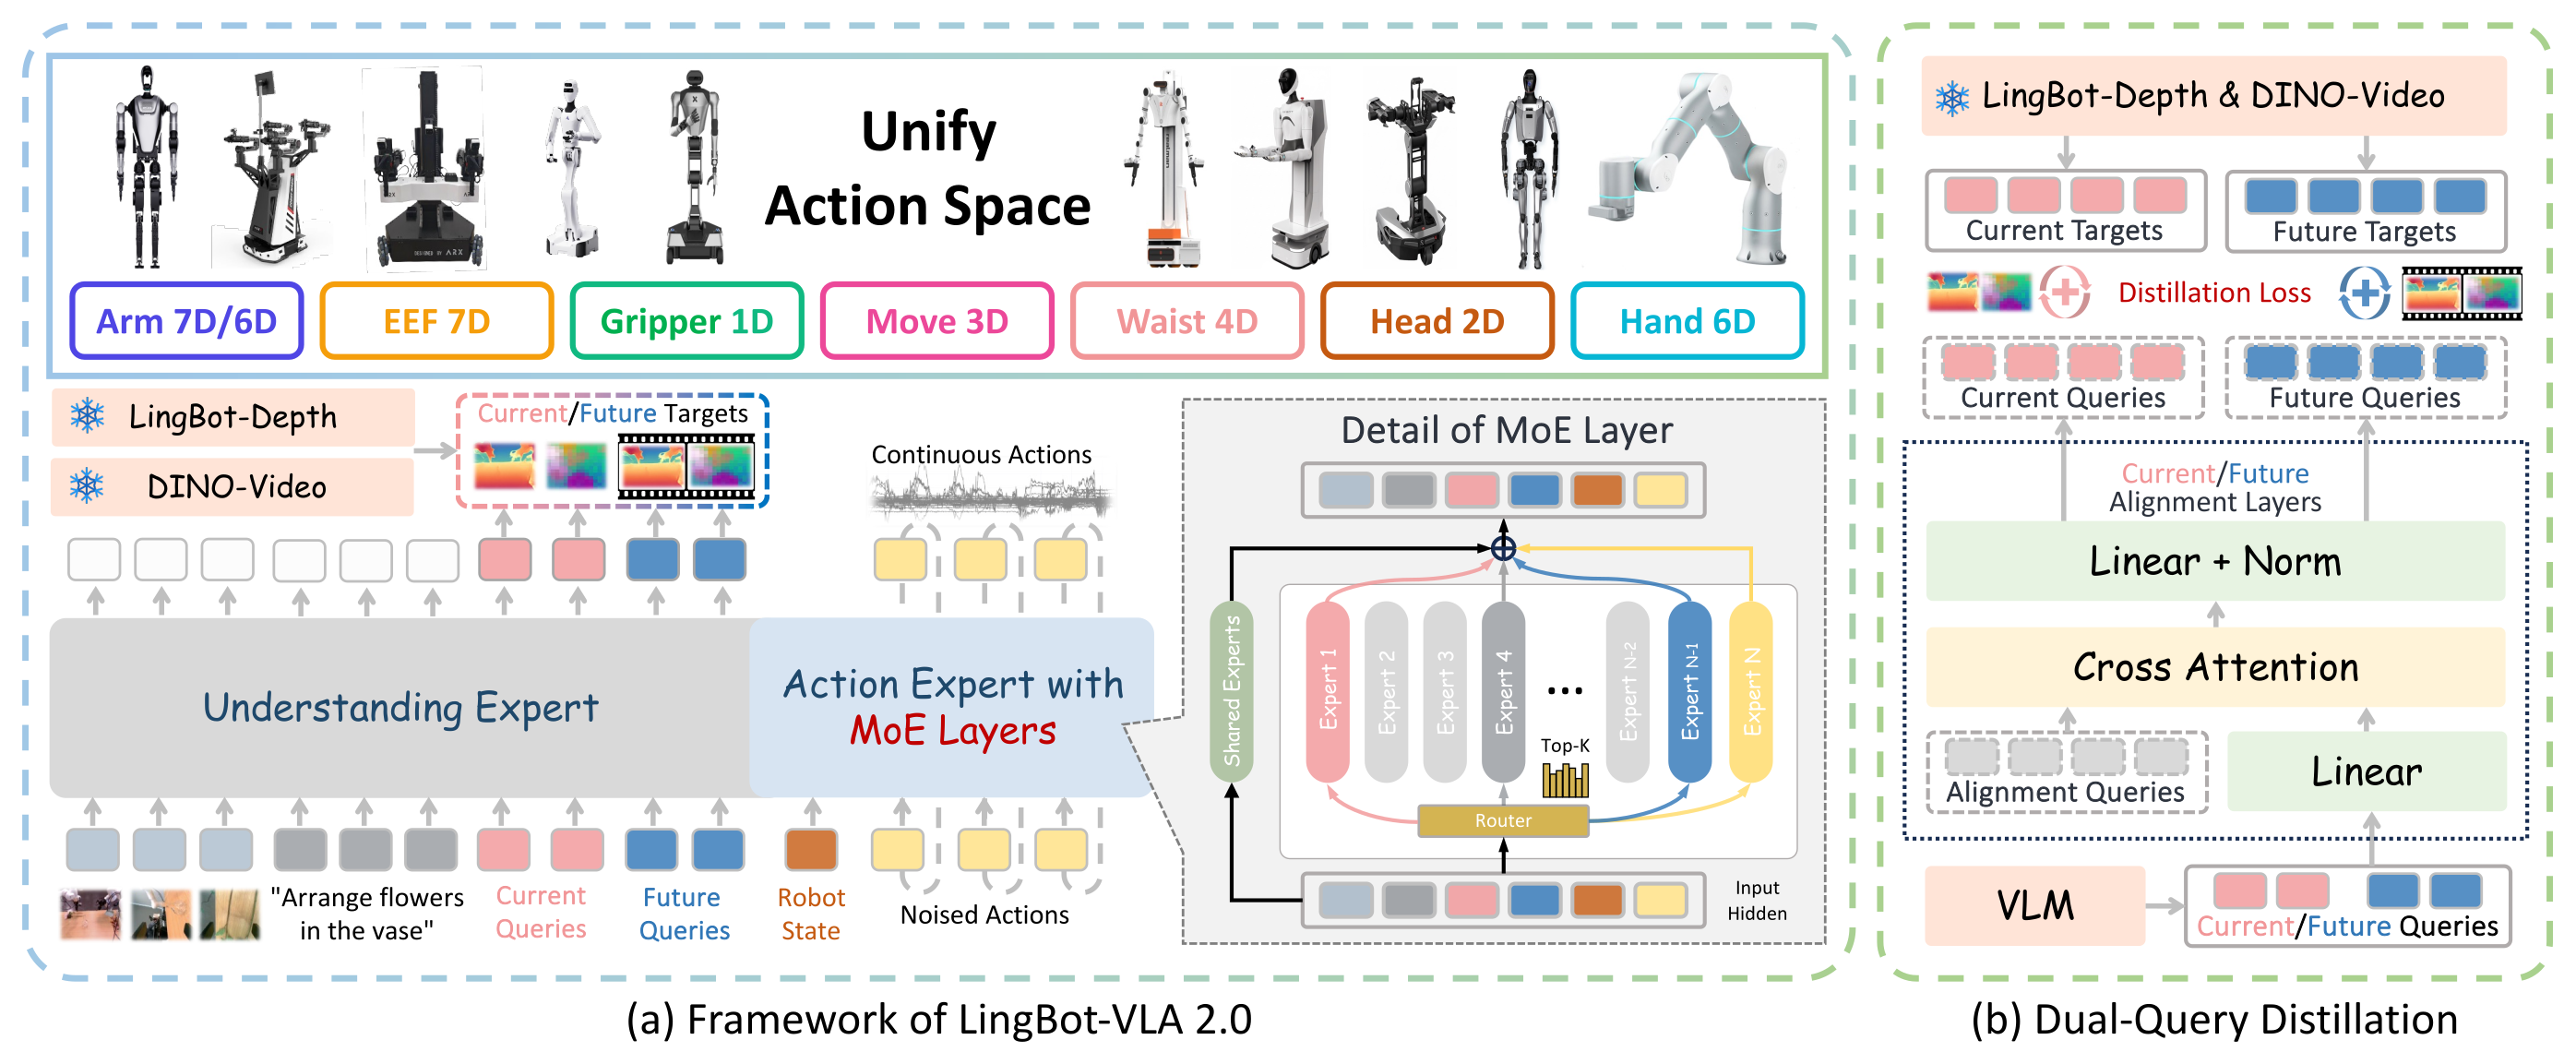
LingBot-VLA 2.0 是该系列的后续版本。官方页面 展示了统一多本体动作空间、Understanding Expert、含 MoE 层的 Action Expert,以及面向当前/未来视觉表征的 Dual-Query 蒸馏。本文只记录这些已公开设计;具体泛化范围、控制频率和成功率应以可复核的报告与评测表为准。
三、World Action Model:让模型”想象未来”
VLA 直接建模观测、指令与动作之间的条件关系;WAM 额外建模未来观测或使用未来视频提供辅助监督。有些 WAM 在推理时联合生成视频和动作,有些只在训练时保留视频分支,因此不能统一概括为“先想象、再行动”。
DreamZero
NVIDIA 的工作,把 WAM 直接当成 zero-shot 策略。它在预训练视频扩散骨干上建了一个 14B 的自回归世界动作模型,通过同时预测未来世界状态(视频)+ 动作来学物理动力学:
- 视频当稠密监督:当前 VLA 擅长语义泛化,却难泛化到新环境里没见过的物理运动;DreamZero 用视频把”世界怎么演化”学进模型。
- 仅视频/人类示范的跨本体迁移:论文研究了使用其他机器人或人类的仅视频示范进行适配,并在指定任务中减少目标本体所需的动作标注;能否降低整体数据成本仍取决于视频收集、域差异和目标机器人校准。
- 特定系统中的闭环速度:作者报告通过模型与系统协同优化,使 14B 模型在其硬件和推理配置下达到约 7 Hz。这是该系统的测量结果,不足以单独证明大 WAM 在不同机器人与硬件上都可部署。DreamZero 论文
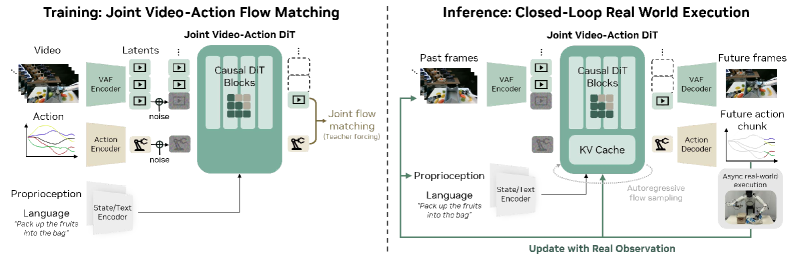
DreamZero 将预训练视频骨干用作 zero-shot 策略,并在论文设定中研究仅视频示范与跨本体迁移。结果支持视频监督有助于物理泛化这一假设,但不能据此断言视频世界模型是 zero-shot 泛化的唯一来源。
LingBot-VA / LingBot-VA 2.0
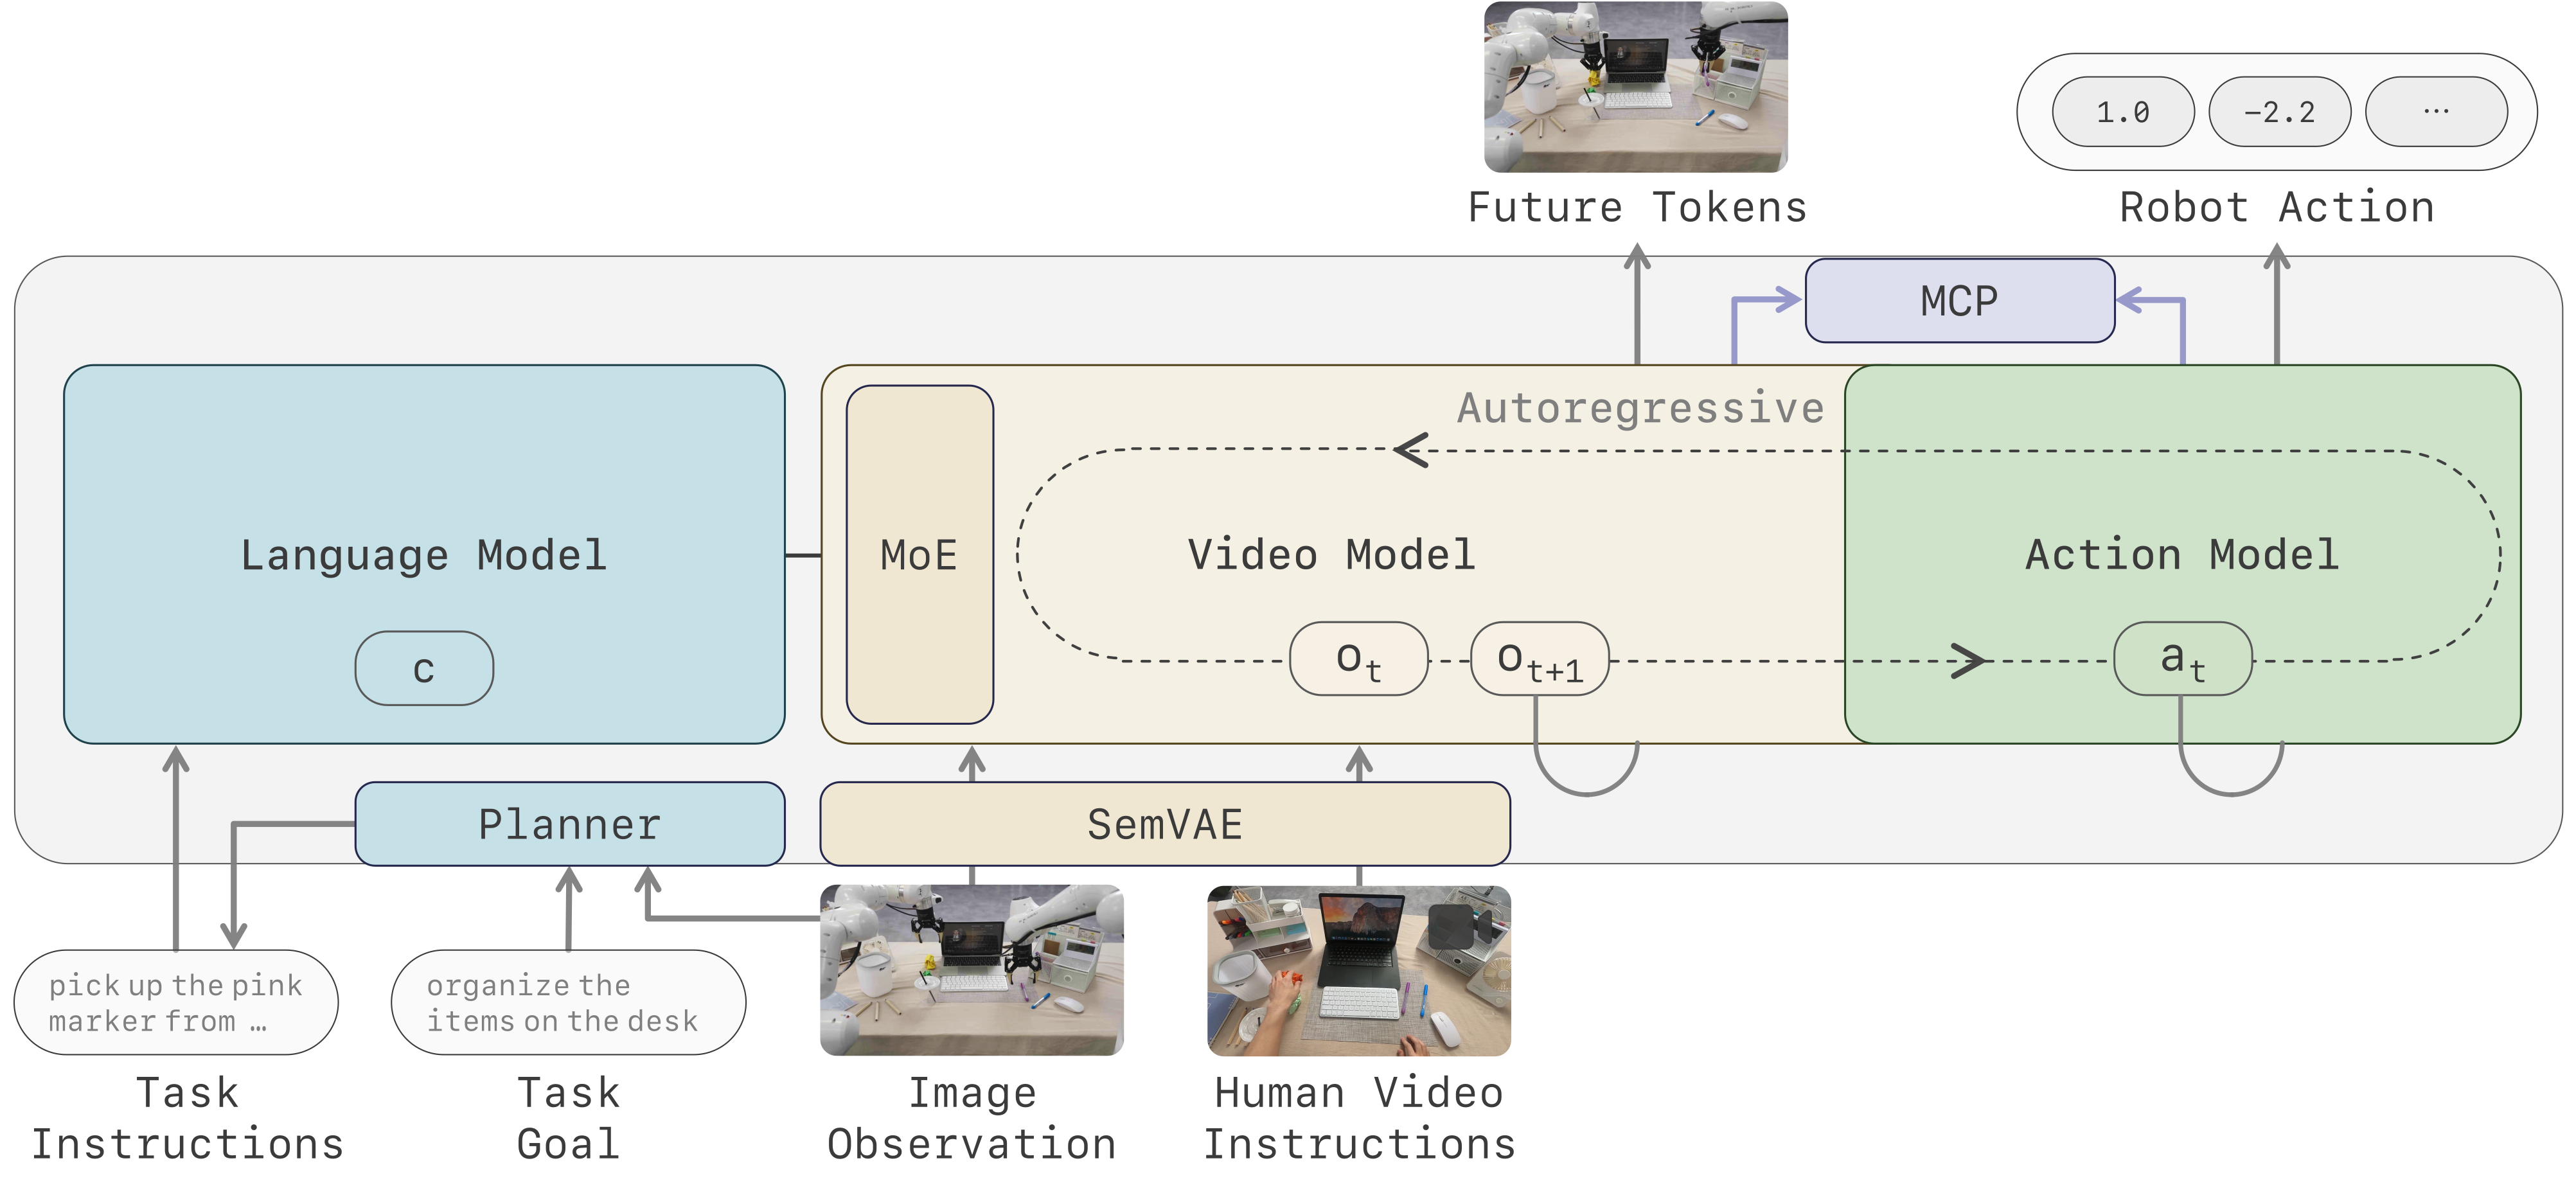
LingBot-VA 是 Robbyant 的视频动作(Video-Action)世界模型,走的是 WAM 里的”闭环鲁棒”支线。它的第一代(Causal World Modeling for Robot Control)用自回归扩散把”视频世界模型”和”动作策略”统一:
- 双流 Mixture-of-Transformers:视频流(初始化自 Wan2.2-5B)与动作流并行,各自 QKV,再跨模态注意力融合,避免模态互扰。
- 视频-动作交错 + 因果自回归:把视频帧与动作交错成一个序列,用因果掩码做统一的 next-token 预测——因果性保证未来不影响过去,符合物理直觉。
- 逆动力学出动作:世界模型先”想象”出期望的未来画面,逆动力学再反推”什么动作能得到这个画面”。
- 实时异步推理 + FDM grounding:用 KV cache 加速、异步流水线让”想象”与”电机执行”并行,并用前向动力学模型(FDM)以最新真实反馈重新对齐,避免开环漂移。
这套设计主要处理 chunk 式视频—动作生成中的三个问题:reactivity(反馈时效)、长时历史信息利用和物理因果一致性。
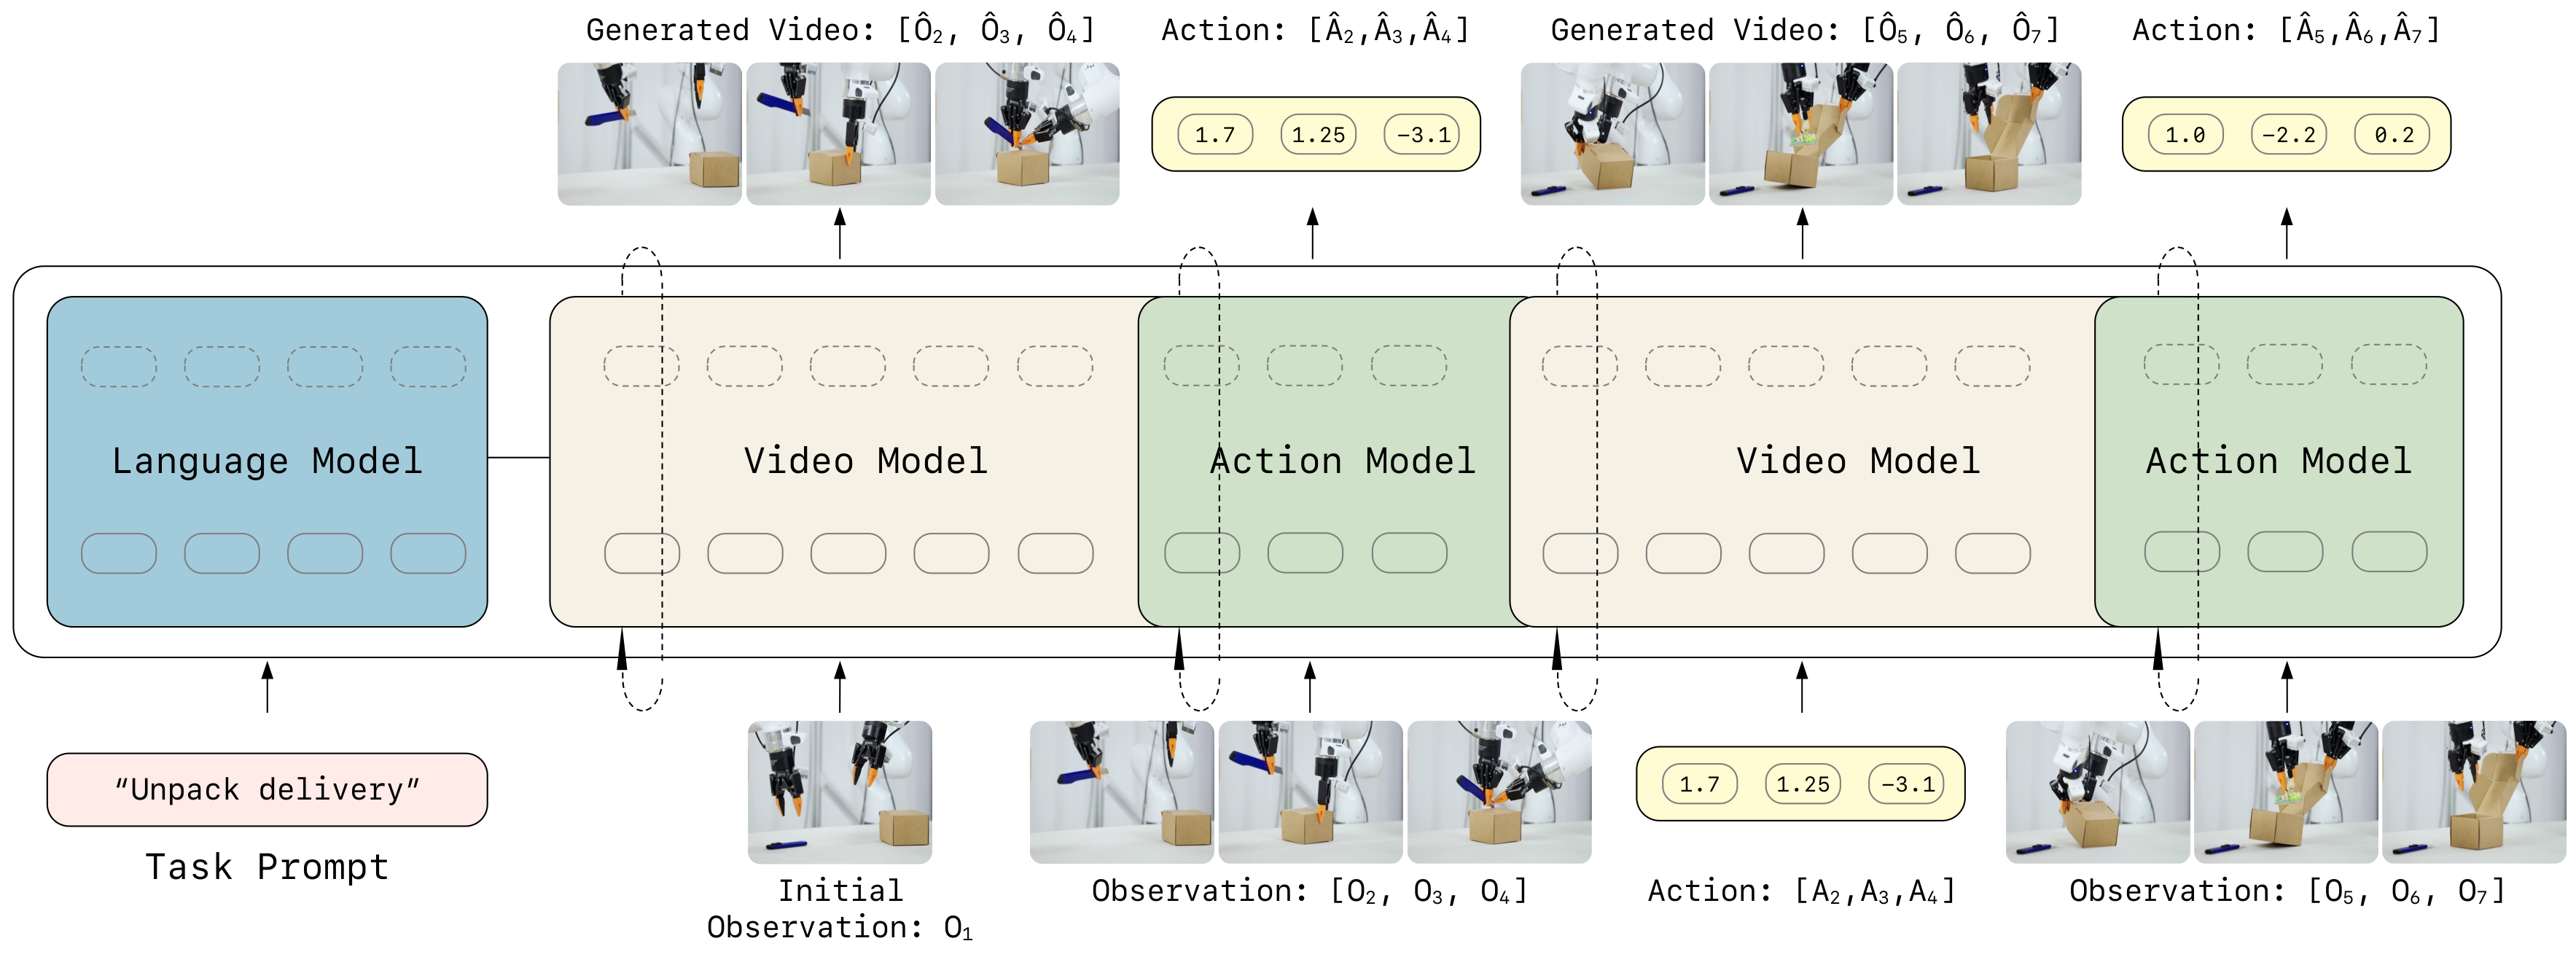
LingBot-VA 2.0 的公开材料见官方页面。在缺少可逐项核对的技术报告和统一评测表时,本文不对“更强、更长或更快”作定量判断,只将它记录为 LingBot-VA 路线的后续版本。
三类路线的关系
把这三类路线放在一起,可以看到它们解决的是不同但相关的问题:
- VLM 学习视觉—语言表征,可为定位、问答和高层语义提供基础;
- VLA 联合建模视觉、语言与动作,重点处理动作表示、闭环控制和跨本体数据;
- WAM 额外预测未来观测或使用视频辅助目标,研究物理动态表征能否改善策略学习。
这些系统需要在结构先验、预训练规模、闭环延迟和机器人数据质量之间权衡。预训练模型能够提供有用表示,但机器人能否可靠行动仍取决于动作数据、后训练、控制接口和真实环境评测。
无论采用哪条路线,最终性能都同时受后训练目标、数据覆盖与质量、计算预算以及闭环评测约束。接下来的两篇分别讨论后训练算法和数据规模化。