
Overview
本篇整理机器人 / 多模态系统里反复用到的十个视觉基础模型。它们不是某个任务的解法,而是被 VLA、感知、抓取管线反复复用的通用视觉组件。
按「学什么表征 → 怎么接语言 → 怎么做几何/分割」三条线索组织(顺序从早到近、从简到繁,同一系列相邻):
- 图文对比 & 自监督表征——CLIP(图文对比学习得到可迁移视觉塔)→ SigLIP(sigmoid 损失替代 softmax,去掉全局归一化);DINOv2(纯视觉自监督 + 数据管线)→ DINOv3(进一步 scaling,Gram anchoring 保住稠密特征)。这四个回答「怎么学一个好用的视觉编码器」。
- 视觉语言模型(VLM)——LLaVA(视觉编码器 + 投影 + LLM 的指令微调范式)→ Qwen-VL(多语种,带 grounding / OCR)→ InternVL(大视觉编码器 + 动态高分辨率的开放权重系列)。这三条线共享视觉塔、跨模态连接模块与 LLM 的基本组合,但训练时是否冻结视觉塔并不相同。
- 几何与分割基础模型——FoundationPose(新物体 6D 位姿估计与跟踪);SAM3(可提示概念分割)→ SAM3D(单图到 3D 重建)。这三个直接对接机器人感知管线。
这些工作使用不同监督信号:CLIP/SigLIP 使用图文对,DINO 系使用图像自身,VLM 将视觉表示接入语言模型,SAM 与 FoundationPose 则针对分割和位姿任务训练。视觉塔会影响上层系统,但动作数据、跨模态对齐、分辨率、后训练和闭环控制同样重要,不能只凭视觉 backbone 推断 VLM 或 VLA 的能力上限。
Paper List
| 简称 | 年份 / Venue | 主题 | 一句话定位 |
|---|---|---|---|
| CLIP | ICML 2021 | 图文对比学习 | 4 亿图文对对比训练,零样本迁移的视觉塔 |
| SigLIP | ICCV 2023 (Oral) | 图文对比训练 | sigmoid 成对损失,去全局归一化、省显存 |
| DINOv2 | arXiv 2023 | 视觉自监督 | 精选数据 + 判别式 SSL,强稠密特征 |
| DINOv3 | arXiv 2025 | 大规模 SSL | Gram anchoring 保稠密特征,单骨干免微调 |
| LLaVA | NeurIPS 2023 | 视觉指令微调 | GPT-4 造指令数据,投影层接 LLM |
| Qwen-VL | arXiv 2023 | 多语种 VLM | 视觉适配器压 token,带 grounding / OCR |
| InternVL | CVPR 2024 | 开源大 VLM | InternViT-6B 视觉编码器渐进对齐 LLM |
| FoundationPose | CVPR 2024 | 6D 位姿 | 新物体位姿估计+跟踪,测试免微调 |
| SAM3 | arXiv 2025 | 概念分割 | 可提示概念分割(PCS),图像+视频统一 |
| SAM3D | arXiv 2025 | 单图到 3D | 生成式几何+纹理,从单图重建 3D |
CLIP
Learning Transferable Visual Models From Natural Language Supervision
一句话用图像–文本对比学习在 4 亿网络图文对上训练一个可迁移视觉编码器:模型学「哪段 caption 配哪张图」,视觉表征从此以自然语言而非固定类别为基础,支持零样本分类与检索。它是后续绝大多数 VLM 的视觉塔起点。
年份 / Venue ICML 2021(arXiv 2103.00020)| 机构 OpenAI | 方向 图文对比学习 / 可迁移视觉表征 | 基准 30+ 数据集零样本迁移
BibTeX
@inproceedings{radford2021learning,
  title     = {Learning Transferable Visual Models From Natural Language Supervision},
  author    = {Radford, Alec and Kim, Jong Wook and Hallacy, Chris and Ramesh, Aditya and Goh, Gabriel and Agarwal, Sandhini and Sastry, Girish and Askell, Amanda and Mishkin, Pamela and Clark, Jack and others},
  booktitle = {International Conference on Machine Learning},
  year      = {2021},
  url       = {https://arxiv.org/abs/2103.00020}
}
Motivation
当时的 SOTA 视觉模型都在固定类别集上做有监督训练,换一个任务就要重新标注、重新训练,开放集与分布迁移能力差。CLIP 的动机:既然网上有海量自带文本描述的图片,能不能直接用自然语言当监督,学一个「一次训练、到处零样本迁移」的视觉表征。
Method
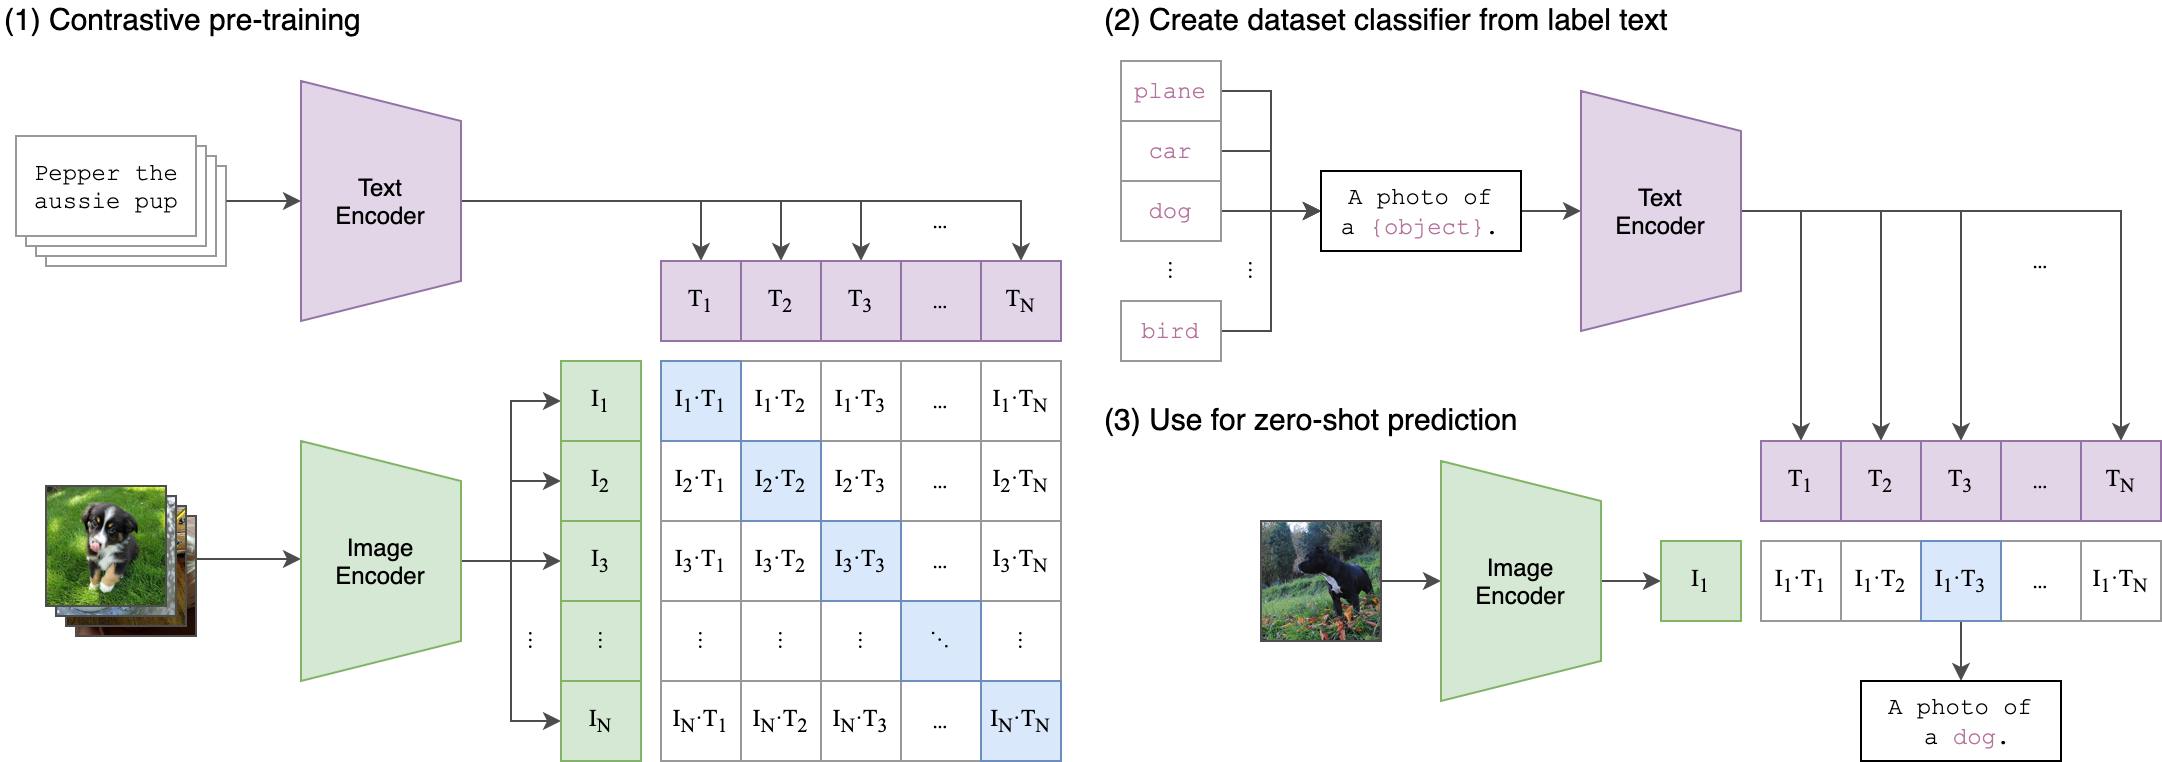
- 双塔对比学习:一个图像编码器(ResNet 或 ViT)+ 一个文本编码器(Transformer),各自编码后投到同一空间。
- InfoNCE 对比目标:一个 batch 内 N 张图 × N 段文本组成 N×N 相似度矩阵,对角线为正样本对,做对称交叉熵,配可学习温度 τ。
- 零样本推理:把候选类别名套进 prompt(如 “a photo of a {label}“)编码成文本向量,与图像向量比相似度即完成分类——无需下游训练。
- 数据:自建 WIT 4 亿图文对,规模是可迁移性的关键。
Experiments
- 零样本 ImageNet 匹配 ResNet-50 的有监督精度,却完全没用那 128 万张标注训练图——这是全篇最深刻的结论。
- 在 OCR、动作识别、细粒度分类等 30+ 数据集上零样本可用,且对分布迁移(ImageNet-R/A/Sketch 等)显著更鲁棒。具体各数据集精度此处定性描述。
Strengths and Limitations
Strengths:零样本 + 强鲁棒性 + 可扩展;视觉塔可直接拆下来喂给下游 VLM / 检测 / 分割。
局限:细粒度计数、抽象推理、专门 OCR 等任务偏弱;依赖 prompt engineering;训练数据的社会偏见会被带入。SigLIP 从损失函数、DINO 从去语言监督两个方向改进。
Takeaways
记住三个词:对比学习、自然语言监督、零样本。CLIP 确立了「图文对比 → 可迁移视觉塔」的范式,是 LLaVA 等 VLM 视觉塔与开放词汇分割的共同祖先。
SigLIP
Sigmoid Loss for Language Image Pre-Training
一句话把 CLIP 的 softmax 对比损失换成成对 sigmoid 损失:每个图文对独立做二分类(对角为正、其余为负),不需要跨全 batch 的全局归一化,因此对 batch size 不敏感、显存友好,小算力也能训出强图文对齐骨干。
年份 / Venue ICCV 2023(Oral,arXiv 2303.15343)| 机构 Google DeepMind(Zhai, Mustafa, Kolesnikov, Beyer)| 方向 图文对比训练 / 损失函数 | 基准 ImageNet 零样本等
BibTeX
@inproceedings{zhai2023sigmoid,
  title     = {Sigmoid Loss for Language Image Pre-Training},
  author    = {Zhai, Xiaohua and Mustafa, Basil and Kolesnikov, Alexander and Beyer, Lucas},
  booktitle = {Proceedings of the IEEE/CVF International Conference on Computer Vision},
  year      = {2023},
  url       = {https://arxiv.org/abs/2303.15343}
}
Motivation
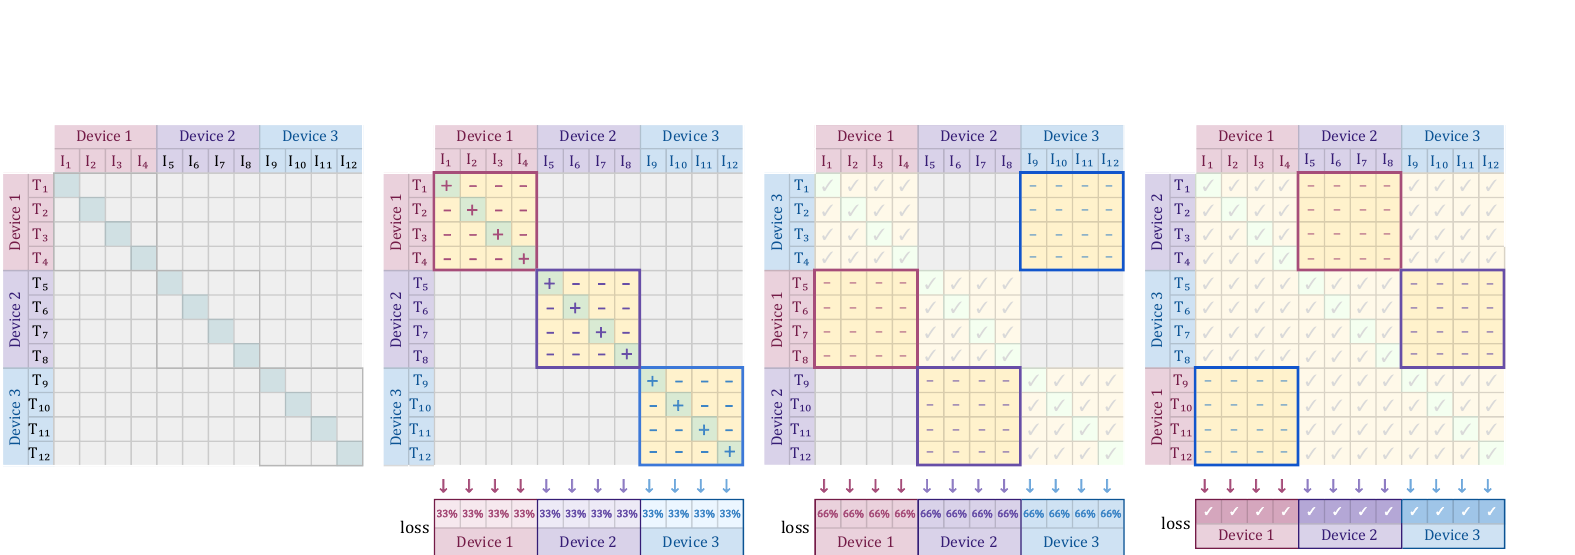
CLIP 的 softmax 对比损失要在整个 batch 的所有图文对上做全局归一化:分母是 batch 内全部相似度之和,因而需要大 batch + all-gather 把所有样本同步到每张卡,显存与通信开销大,损失与 batch size 强耦合。SigLIP 想解耦这一点。
Method
- 成对 sigmoid 损失:把对齐当成每个图文对独立的二分类——对角线上的正样本对希望 logit 为正,非对角负样本对希望为负,损失是逐对 sigmoid 交叉熵之和。
- 可学习温度 + 偏置:初期负样本远多于正样本,用一个可学习 bias 缓解不平衡。
- 无全局归一化:损失不再依赖「看到全 batch」,因此可分块计算(见上图),显存友好、对 batch size 鲁棒。
Experiments
- 论文报告 SigLiT 变体使用 4 块 TPUv4 训练两天,在其 ImageNet zero-shot 评测设置中达到 84.5%;硬件、训练数据和评测协议都是该数字的一部分。
- 探索到百万级 batch,但发现 32k batch 已基本足够——推翻了「对比学习越大 batch 越好」的直觉。
Strengths and Limitations
Strengths:简单、省显存、对 batch size 鲁棒;在同算力下匹配或超过 CLIP,成为新一代常用视觉–语言骨干(PaliGemma、多种 VLM / VLA 采用)。
局限:仍需大规模图文数据;sigmoid 下负样本权重需调。后续 SigLIP 2 进一步扩能力。
Takeaways
一句话:把 softmax 换成 sigmoid,训练从「必须看全 batch」解放出来。 与 CLIP 是同一范式的工程演进,是很多下游 VLM 的默认视觉塔候选。
DINOv2
DINOv2: Learning Robust Visual Features without Supervision
一句话纯视觉自监督(不用任何标签或文本),靠判别式自蒸馏在精选大规模数据上训练,产出无需微调即可用的通用特征——尤其是强稠密特征(分割、深度、对应关系),机器人里常作几何 / 关键点骨干。
年份 / Venue arXiv 2023(TPAMI,2304.07193)| 机构 Meta AI | 方向 视觉自监督 / 稠密特征 | 基准 图像级 + 像素级多任务
材料 Paper · Code / Models
BibTeX
@article{oquab2023dinov2,
  title   = {{DINOv2}: Learning Robust Visual Features without Supervision},
  author  = {Oquab, Maxime and others},
  journal = {arXiv preprint arXiv:2304.07193},
  year    = {2023},
  url     = {https://arxiv.org/abs/2304.07193}
}
Motivation
自监督学习(SSL)本可像 NLP 那样从无标签数据学通用特征,但此前的 SSL 特征不够鲁棒 / 通用,且在没精心构造的数据上训练易退化。DINOv2 的目标:产出免微调、跨图像级与像素级任务都好用的「全能」视觉特征。
Method
- 判别式自蒸馏:组合 DINO(图像级)+ iBOT(patch 级)目标,配 centering / Sinkhorn-Knopp 稳定训练、KoLeo 正则鼓励特征均匀分布。
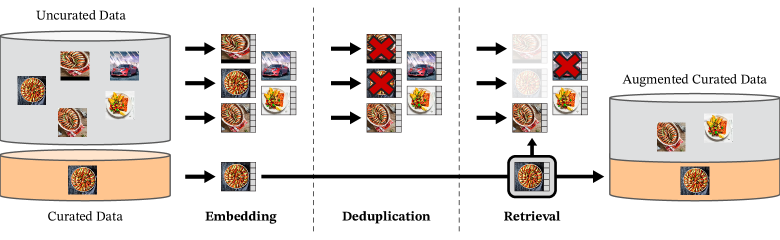
- 数据管线(本页配图):从海量未精选图像出发,用 embedding 做去重与检索,向已精选种子集对齐,构建 LVD-142M。论文消融说明该数据整理流程对结果重要,但不能据此给“数据质量”和“算法”赋予可普遍比较的同等权重。
- 规模 + 蒸馏:先训 10 亿参数 ViT-g,再蒸馏到 ViT-S/B/L 等小模型,兼顾性能与部署。
Experiments
- 冻结特征 + 线性探针,在图像级与像素级多数基准上超过当时最强通用特征 OpenCLIP(原文结论,具体分数定性描述)。
- 稠密特征在分割、深度、PCA 对应可视化上表现突出——这是它区别于 CLIP 的关键。
Strengths and Limitations
Strengths:免微调、强稠密特征、可蒸馏到小模型;机器人里做几何 / 关键点特征很顺手。
局限:无语言对齐(要接文本需额外对齐模块);数据管线与大模型训练成本高。
Takeaways
一句话:自监督 + 精选数据 + 蒸馏 = 通用稠密视觉特征。 与 CLIP 互补(一个有语言、一个几何强),是 DINOv3 的直接前身。
DINOv3
DINOv3
一句话把 DINO 系自监督进一步 scaling(更大模型 + 更大数据)的视觉基础模型;核心贡献是 Gram anchoring——解决「长训练周期下稠密特征图退化」这一已知难题,让单个冻结骨干免微调就能在稠密任务上超过专门模型。
年份 / Venue arXiv 2025(2508.10104,2025-08-13)| 机构 Meta AI | 方向 大规模视觉自监督 / 稠密特征 | 基准 多任务稠密预测等
BibTeX
@misc{simeoni2025dinov3,
  title         = {{DINOv3}},
  author        = {Sim{\'e}oni, Oriane and Vo, Huy V. and Seitzer, Maximilian and others},
  year          = {2025},
  eprint        = {2508.10104},
  archivePrefix = {arXiv},
  url           = {https://arxiv.org/abs/2508.10104}
}
Motivation
DINOv2 已证明 SSL 能出好特征,但训练一拉长、稠密特征图就会退化(patch 级表示随迭代变差),成为继续 scaling 的拦路虎。DINOv3 要在更大规模下同时保住稠密特征质量,并让单一骨干覆盖尽量多的下游 / 域。
Method
- Gram anchoring(印象最深):针对稠密特征退化提出的新正则——约束特征的 Gram(相似度)结构,长训练下也能维持稳定的 patch 级表示。
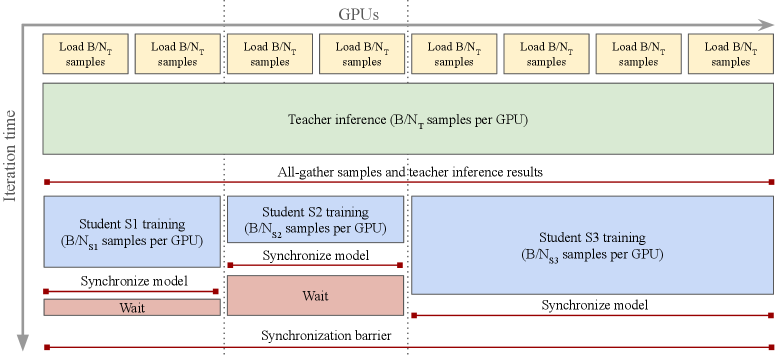
- 系统性 scaling:在数据准备、架构与优化上做整套扩展;训练用多学生并行蒸馏(见配图)提升效率。
- 后处理策略:免微调地增强对分辨率、尺度与文本对齐的灵活性。
Experiments
- 无需任务特定适配,稠密特征质量超越专门的自监督 / 弱监督基础模型(原文结论)。
- 结果口径:这里只记录论文摘要和表格能够直接支持的规模与下游结果,不根据项目宣传材料补写参数量或数据量。
Strengths and Limitations
Strengths:单个冻结骨干覆盖多任务多域、稠密特征稳;蒸馏出的家族便于部署。
局限:训练成本极高;同样偏几何 / 稠密,语言对齐仍需外接。
Takeaways
一句话:Gram anchoring 让 SSL 在更大规模下不牺牲稠密特征。 是 DINOv2 的 scaling 续作,机器人稠密感知的强候选骨干。
LLaVA
Visual Instruction Tuning
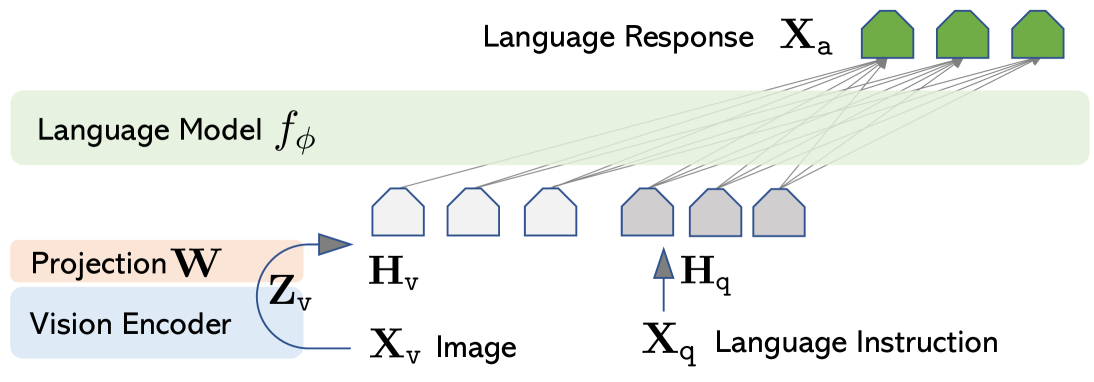
一句话LLaVA 使用 GPT-4 辅助构造多模态指令跟随数据,通过投影层连接冻结的 CLIP 视觉编码器与 LLM,再进行分阶段训练。视觉塔、连接模块与 LLM 的组合随后被多项开放 VLM 工作采用,但具体冻结策略和连接结构并不统一。
年份 / Venue NeurIPS 2023(arXiv 2304.08485)| 机构 UW–Madison · Microsoft(Liu, Li, Wu, Lee)| 方向 视觉指令微调 / VLM | 基准 ScienceQA、多模态对话
BibTeX
@inproceedings{liu2023llava,
  title     = {Visual Instruction Tuning},
  author    = {Liu, Haotian and Li, Chunyuan and Wu, Qingyang and Lee, Yong Jae},
  booktitle = {Advances in Neural Information Processing Systems},
  year      = {2023},
  url       = {https://arxiv.org/abs/2304.08485}
}
Motivation
指令微调让 LLM 学会「听人话办事」,但多模态指令数据几乎没有。LLaVA 的动机:既然纯文本的 GPT-4 很强,能不能用它从图像的 caption / 框标注生成对话式多模态指令数据,再拿来教一个视觉 LLM。
Method
- 数据生成:把图像的 caption、bounding box 喂给纯文本 GPT-4,让它生成对话 / 细节描述 / 复杂推理三类指令数据。
- 架构(本页配图):CLIP ViT-L 视觉编码器(冻结)→ 投影层(LLaVA-1.0 用线性、1.5 换 MLP)→ LLM(Vicuna)。
- 两阶段训练:先特征对齐预训练(只训投影层,对齐视觉 token 与词嵌入空间),再端到端指令微调(投影层 + LLM 一起训)。
Experiments
- 论文在 ScienceQA 上报告 92.53%,该结果使用 GPT-4 协同产生/处理的数据与预测;“SOTA”仅指论文发表时的对应评测设置。
- 在作者构造的多模态指令基准上,达到约 GPT-4 的 85% 相对水平;聊天式视觉理解质量突出。LLaVA-1.5 用简单改动(MLP 投影 + 学术任务数据)在 11 个基准上进一步走强。
Strengths and Limitations
Strengths:简单、数据高效、完全开源;「投影 + 指令微调」配方极易复现。
局限:早期分辨率有限、易幻觉、细粒度 / OCR 偏弱(后续版本与 InternVL 用高分辨率改进)。
Takeaways
LLaVA 展示了一个简洁且可复现的配方:用语言模型辅助生成视觉指令数据,以投影层连接 CLIP 视觉特征和 LLM,再进行分阶段训练。Qwen-VL 与 InternVL 也采用视觉塔—连接模块—LLM 的组合,但数据、结构和训练配方并不相同。
Qwen-VL
Qwen-VL: A Versatile Vision-Language Model for Understanding, Localization, Text Reading, and Beyond
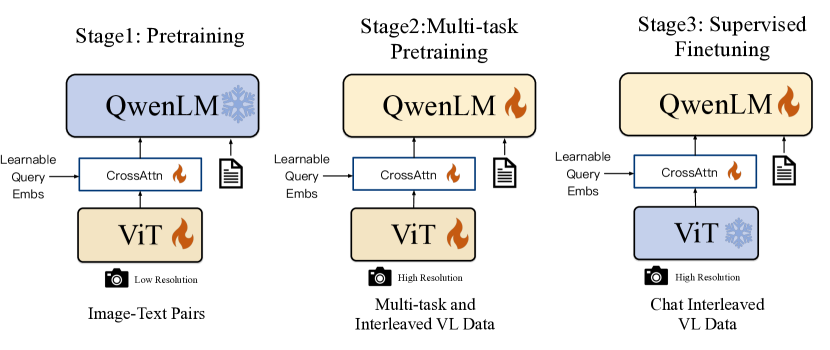
一句话Qwen-VL 在 Qwen LLM 上加入视觉编码器与位置感知适配器,将图像特征压缩为固定数量的视觉 token,并通过坐标 token 支持 grounding 与 OCR。论文在中英文图文理解、VQA、定位与 OCR 基准上进行评测。
年份 / Venue arXiv 2023(2308.12966)| 机构 阿里巴巴(通义实验室)| 方向 VLM / grounding / OCR | 基准 图文理解、VQA、grounding、OCR
BibTeX
@article{bai2023qwenvl,
  title   = {{Qwen-VL}: A Versatile Vision-Language Model for Understanding, Localization, Text Reading, and Beyond},
  author  = {Bai, Jinze and others},
  journal = {arXiv preprint arXiv:2308.12966},
  year    = {2023},
  url     = {https://arxiv.org/abs/2308.12966}
}
Motivation
通用 VLM 大多只会「看图说话」,对精确定位(grounding)与图内文字(OCR)支持弱,且多语种(尤其中文)能力不足。Qwen-VL 想做一个覆盖理解、定位、读字的多面手,并与 Qwen LLM 生态打通。
Method
- 四大组件:视觉编码器(ViT)、位置感知视觉–语言适配器(用一组可学习 query 做 cross-attention,把变长图像特征压成约 256 个定长 token,兼顾效率与位置信息)、结构化输入输出接口、Qwen LLM。
- 坐标 token:把 bounding box 坐标序列化为 token,使模型能输入/输出框,实现指代表达与检测式定位。
- 三阶段训练:预训练(图文对齐)→ 多任务预训练(VQA / grounding / OCR 等)→ 指令微调得到 Qwen-VL-Chat。
Experiments
- 论文在其选取的 captioning、VQA、grounding 与 OCR 基准上报告了有竞争力的 zero-shot/few-shot 结果;“SOTA”只适用于论文发布时列出的模型、数据和评测设置。
- 细粒度定位与图内文字读取是其相对同类的亮点。
Strengths and Limitations
Strengths:grounding + OCR + 多语种俱强;工程与部署、微调资料齐全,生态成熟。
局限:早期固定分辨率限制密集文档 / 高清场景(后续 Qwen2-VL 引入 naive dynamic resolution + M-RoPE,Qwen2.5-VL 继续增强)。
Takeaways
Qwen-VL 的位置感知适配器和坐标 token 使其同时处理生成、OCR 与定位任务。它可作为机器人高层语义模块的候选骨干,但是否适用于具体机器人仍需考虑延迟、视角变化和目标领域数据。
InternVL
InternVL: Scaling up Vision Foundation Models and Aligning for Generic Visual-Linguistic Tasks
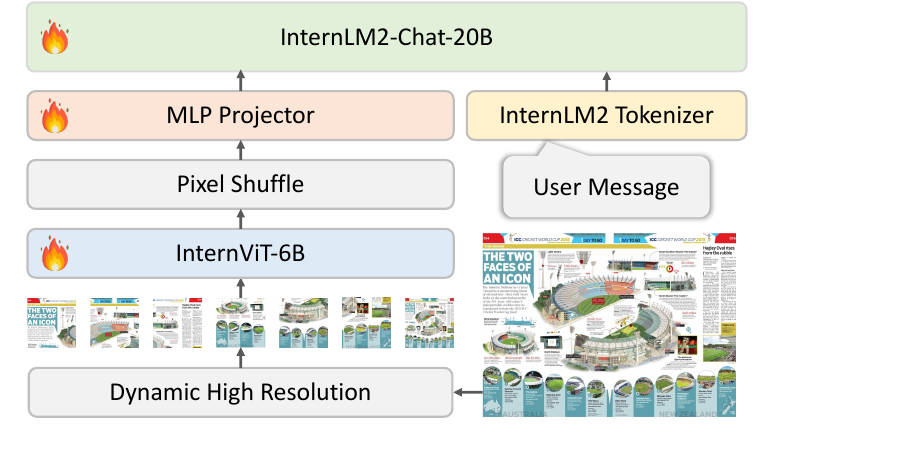
一句话InternVL 使用 InternViT-6B 等视觉编码器,并通过渐进对齐连接语言模型;1.5 版本采用 ViT–MLP–LLM 结构与动态高分辨率切图,重点评测文档、图表和 OCR 等场景。
年份 / Venue CVPR 2024(InternVL 1.0,arXiv 2312.14238)| 机构 上海 AI Lab / OpenGVLab 等 | 方向 开源大 VLM / 视觉编码器 scaling | 基准 32 个视觉–语言任务
材料 Paper · InternVL 1.5 · Code
BibTeX
@inproceedings{chen2024internvl,
  title     = {{InternVL}: Scaling up Vision Foundation Models and Aligning for Generic Visual-Linguistic Tasks},
  author    = {Chen, Zhe and others},
  booktitle = {Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition},
  year      = {2024},
  url       = {https://arxiv.org/abs/2312.14238}
}
Motivation
VLM 的语言侧动辄百亿参数,视觉侧却常停在 CLIP 级(几亿参数),形成能力瓶颈;且开源缺一个能与 LLM 对齐的大视觉编码器。InternVL 要把视觉塔做大,并给出与 LLM 渐进对齐的配方。
Method
- InternViT-6B:60 亿参数的大视觉编码器,用 web 级图文数据训练。
- 渐进对齐:先视觉–语言对比对齐,再经语言中间件 / 投影与 LLM 生成式对齐,逐步打通两侧。
- 1.5 的 ViT–MLP–LLM + 动态高分辨率(本页配图):把高清图动态切成多块分别过 InternViT,再用 Pixel Shuffle 降低 token 数、MLP 投影后接入 InternLM2-Chat——这是它在文档 / 图表 / OCR 上强的关键。
Experiments
- 在 32 个视觉–语言基准上有竞争力(原文),覆盖图像识别、零样本分类、视频–文本检索、多模态对话。
- 论文在若干高分辨率 OCR 和文档理解基准上报告了接近当时 GPT-4V 的结果;该比较受 GPT-4V 版本、提示词、评测时间和闭源接口变化影响,应按原表逐项阅读。
Strengths and Limitations
Strengths:视觉塔够大、动态高分辨率强、系列完全开源(1.5 / 2 / 3 持续迭代)。
局限:6B 视觉编码器 + 大 LLM 计算 / 显存开销大;切图带来 token 膨胀需 Pixel Shuffle 压。
Takeaways
一句话:把视觉塔做大 + 动态切高清图 = 能啃文档的开源大 VLM。 与 LLaVA/Qwen-VL 同为「视觉塔 + 适配器 + LLM」路线,是机器人 VLM / VLA 的开源骨干候选。
FoundationPose
FoundationPose: Unified 6D Pose Estimation and Tracking of Novel Objects
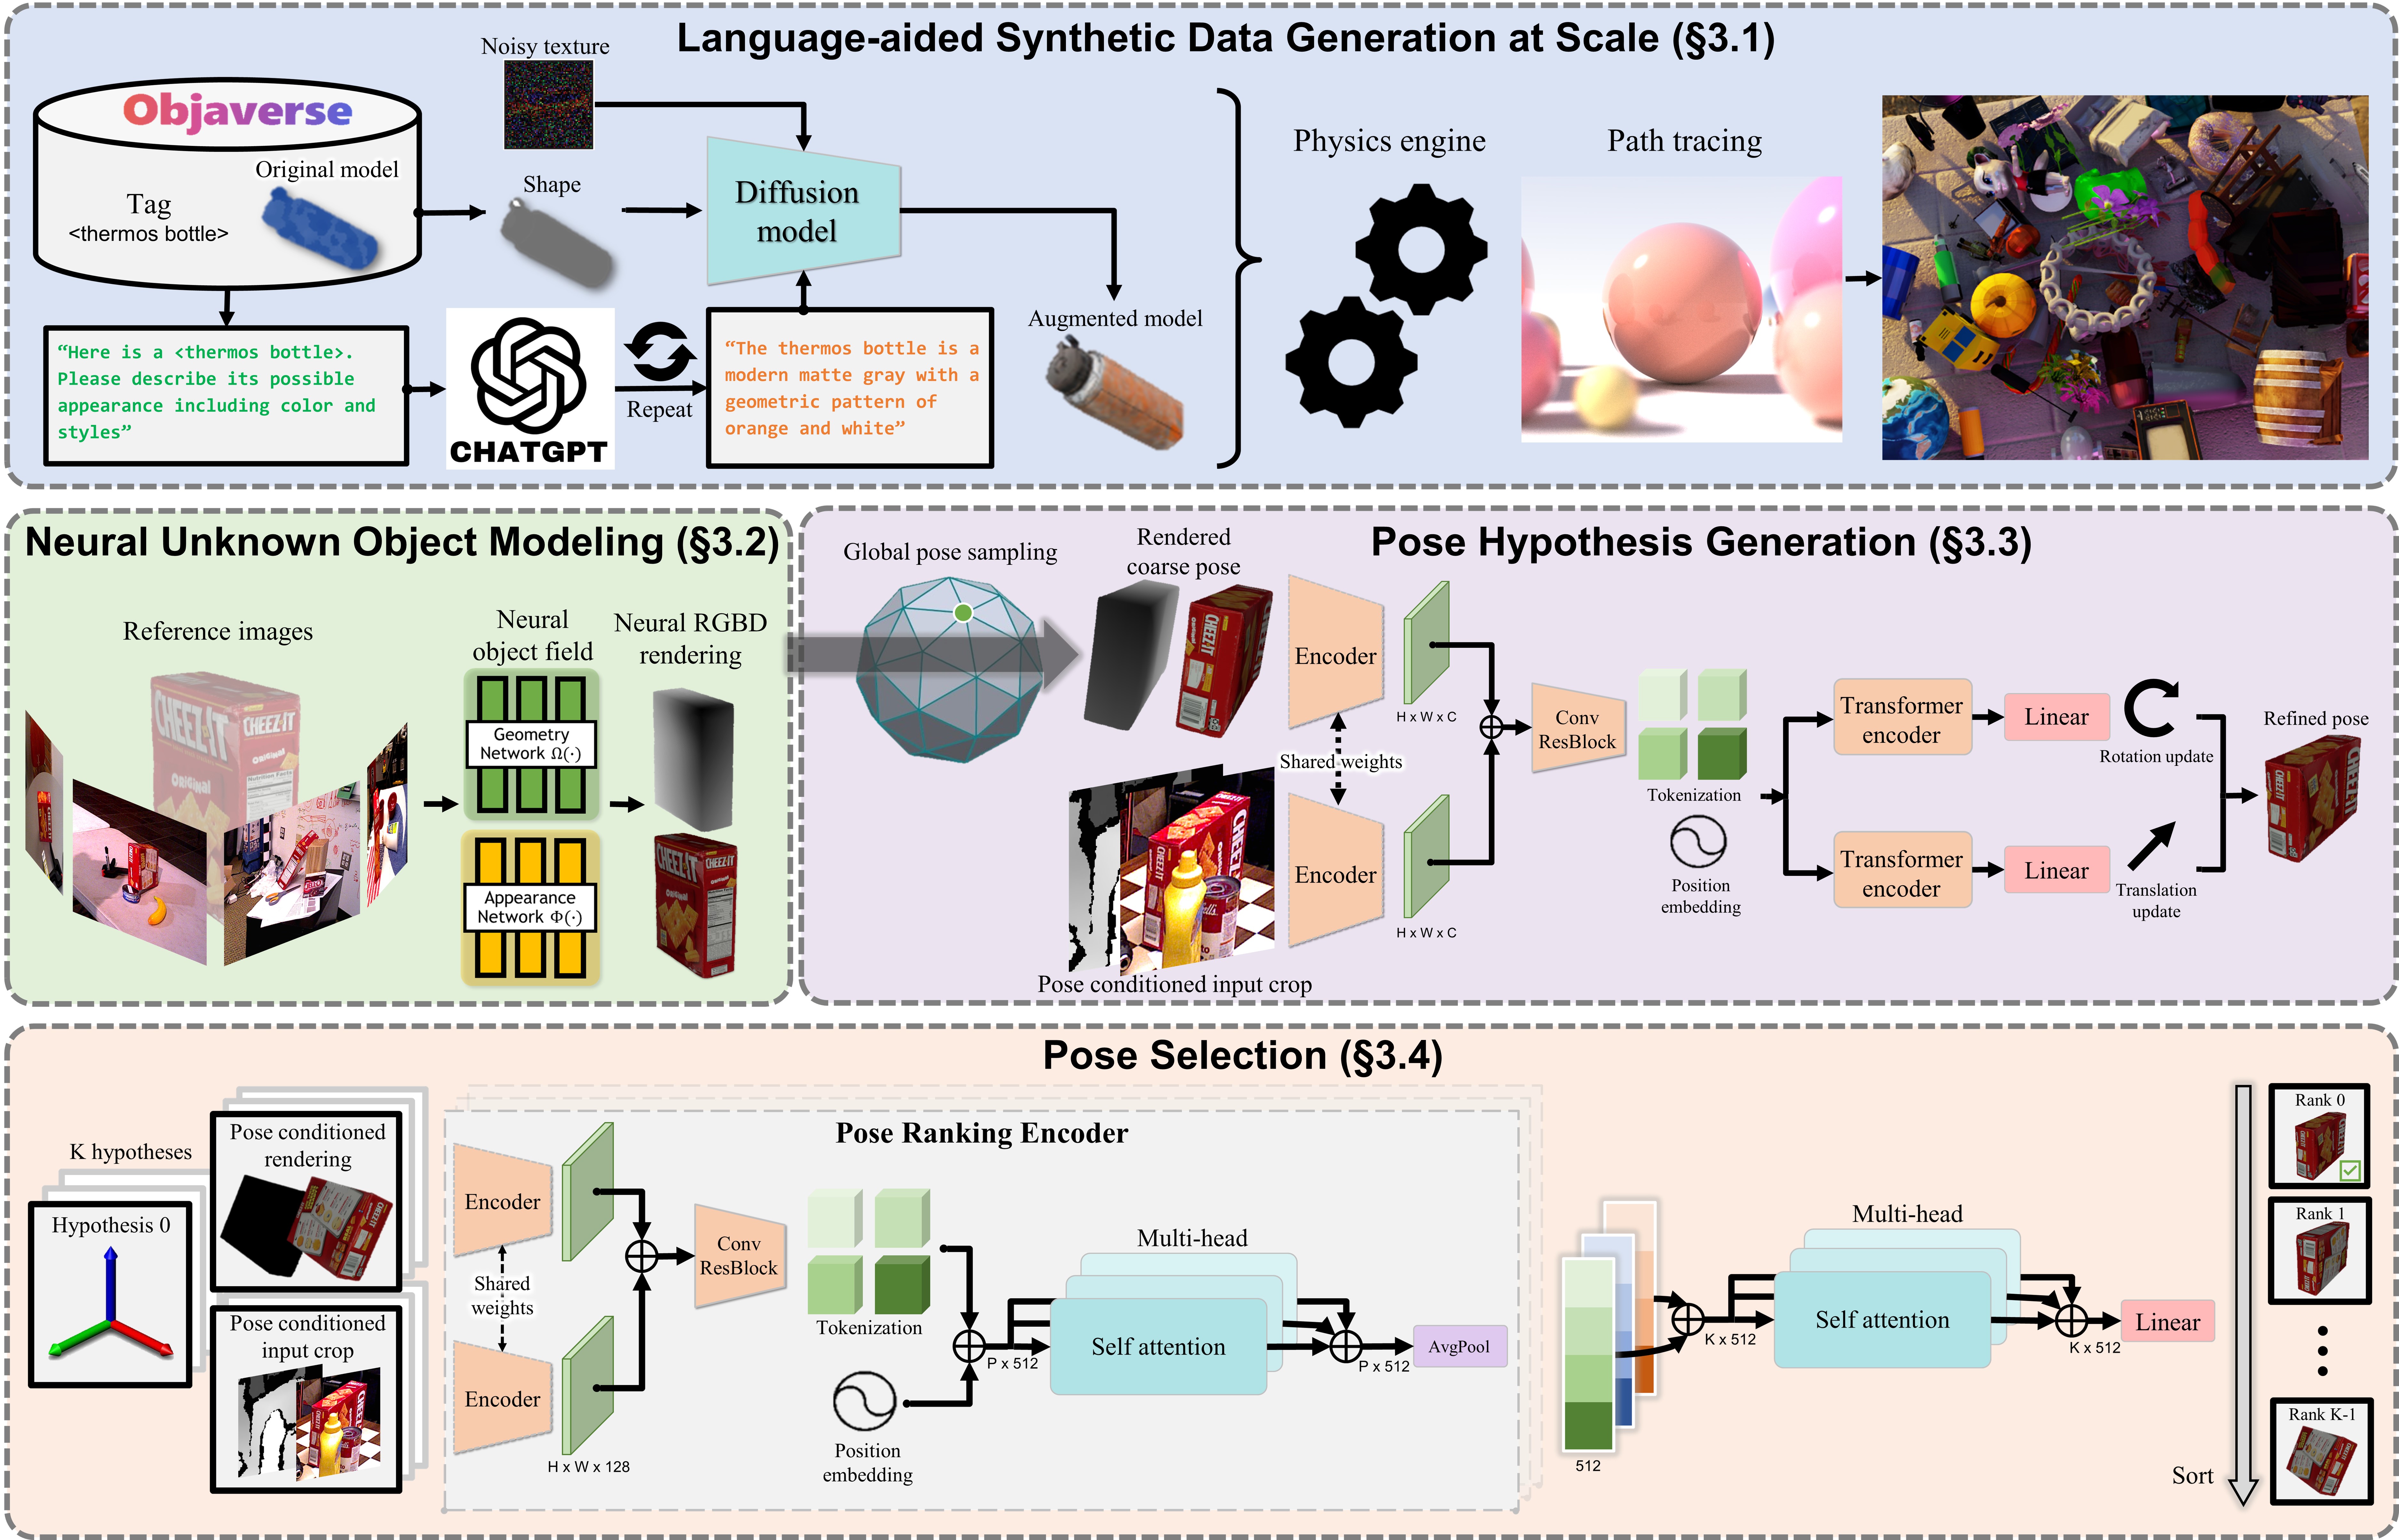
一句话一个统一模型对新物体做 6D 位姿估计与跟踪,测试时无需微调;同时支持 model-based(给 CAD)与 model-free(仅少量参考图),靠神经隐式表征做新视角合成把两种设置统一起来。机器人抓取 / 对准常用基线。
年份 / Venue CVPR 2024(arXiv 2312.08344)| 机构 NVIDIA(Wen, Yang, Kautz, Birchfield)| 方向 6D 位姿估计 / 跟踪 | 基准 YCB-Video、LINEMOD 等
BibTeX
@inproceedings{wen2024foundationpose,
  title     = {{FoundationPose}: Unified {6D} Pose Estimation and Tracking of Novel Objects},
  author    = {Wen, Bowen and Yang, Wei and Kautz, Jan and Birchfield, Stan},
  booktitle = {Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition},
  year      = {2024},
  url       = {https://arxiv.org/abs/2312.08344}
}
Motivation
传统 6D 位姿方法多为实例级(每个物体单独训练)或强依赖 CAD 模型,换新物体就得重训,难以泛化。FoundationPose 想做一个对新物体开箱即用、且能在「有 CAD」与「只有几张参考图」两种设置下都工作的统一基础模型。
Method
- 神经隐式物体表征:用类 NeRF 的表征做新视角合成,从而把 model-free(参考图)和 model-based(CAD)统一到同一套「渲染–比较」框架。
- 大规模合成训练:论文使用 LLM 辅助的数据生成与大规模合成训练来缓解真实 3D 标注稀缺;正文不在缺少原文依据时进一步指定为“扩散生成纹理”。
- render-and-compare + 位姿选择:先生成一批位姿假设并 refine,再用一个对比学习的排序网络从中选最优(本页配图的两大后段)。RGBD 输入。
Experiments
- 在 YCB-Video、LINEMOD 等多个位姿基准上大幅超越各任务专用方法,甚至逼近实例级方法,尽管它的假设更宽松(原文结论,分数定性描述)。
- 支持稳定的位姿跟踪。
Strengths and Limitations
Strengths:统一、泛化强、估计 + 跟踪一体;直接服务机器人抓取 / 对准。
局限:需 RGBD(依赖深度);仍要 CAD 或参考图;NeRF 式建模 + 假设排序有计算开销。
Takeaways
一句话:神经物体建模 + render-and-compare + 排序 = 新物体开箱即用的 6D 位姿。 与本页表征类模型互补——它是几何 / 位姿侧的基础模型。
SAM3
SAM 3: Segment Anything with Concepts
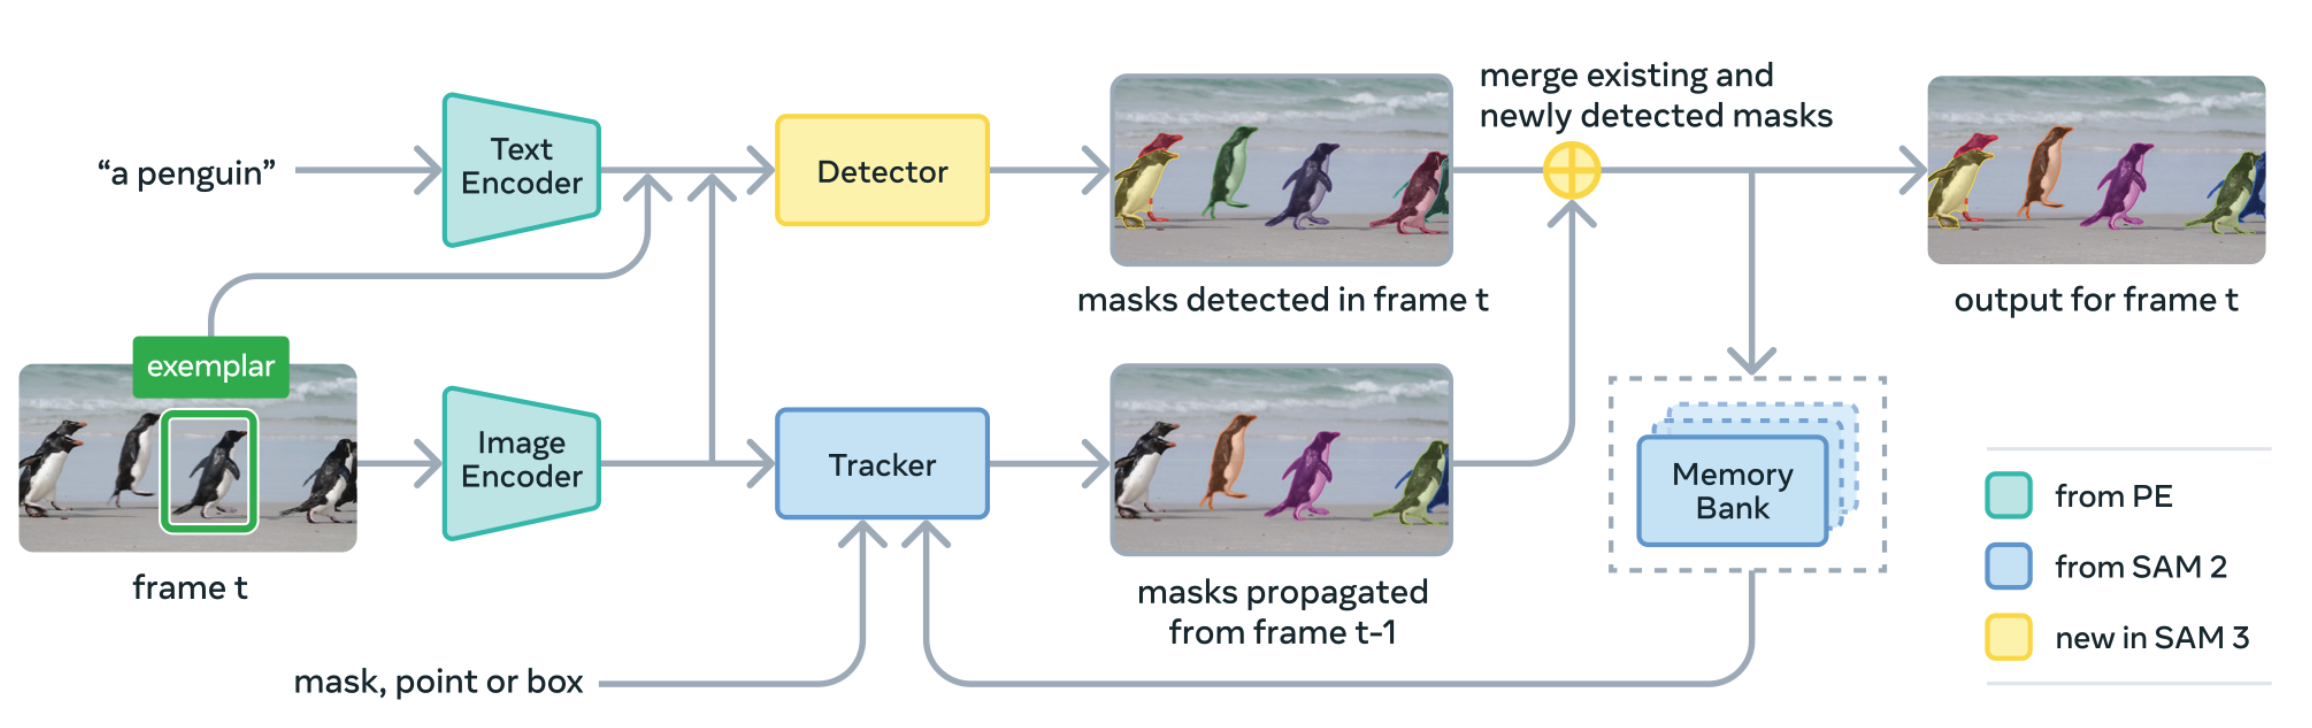
一句话在 SAM 2 之上提出 可提示概念分割(Promptable Concept Segmentation, PCS):给一个「概念提示」(短名词短语如 “yellow school bus”、图像样例,或两者组合),模型就在图像 / 视频里检测、分割并跟踪该概念的所有实例,且每个实例带唯一身份。
年份 / Venue arXiv 2025(2511.16719,2025-11-20)| 机构 Meta AI(Carion 等;Feichtenhofer 通讯)| 方向 开放词汇 / 概念分割 | 基准 SA-Co(新发布)
BibTeX
@article{carion2025sam3,
  title   = {{SAM} 3: Segment Anything with Concepts},
  author  = {Carion, Nicolas and others},
  journal = {arXiv preprint arXiv:2511.16719},
  year    = {2025},
  url     = {https://arxiv.org/abs/2511.16719}
}
Motivation
SAM 1/2 靠点 / 框 / 掩码这类几何提示分割「某个东西」,但不理解「概念」——你没法说「把所有黄色校车都分出来」。SAM 3 要把分割从几何提示升级到语义概念提示,并在图像与视频里统一处理。
Method
- PCS 任务:输入概念提示(名词短语 / 图像样例 / 组合),输出该概念所有实例的掩码,视频中还要保持实例身份。
- 共享骨干的检测器 + 跟踪器(本页配图):图像级 Detector(开放词汇检测 + 分割)与基于 Memory Bank 的视频 Tracker(承自 SAM 2)共享单一 backbone;用 presence head 把「识别(有没有这个概念)」与「定位(在哪)」解耦。
- SA-Co 数据与基准:配套数据与基准包含大规模概念标注和 hard negatives。概念词表、标注实例与独特标签是不同统计口径,具体数量按论文数据章节定义,不在正文中混写。
Experiments
- 论文在其图像和视频 PCS 基准上报告了相对所选既有系统的显著提升;正文应结合具体 metric 与 baseline 阅读,不将“翻倍”外推到所有分割任务。
Strengths and Limitations
Strengths:概念级、开放词汇、图像 + 视频统一、实例身份可跟踪;产品化 / 感知管线友好。
局限:概念提示的粒度与歧义仍是挑战;大规模标注 / 训练成本高。
Takeaways
一句话:从「点这里分这个」升级到「说个概念分全部」。 是 SAM 家族向语义 / 开放词汇的跃迁,直接服务机器人的语言指定分割。
SAM3D
SAM 3D: 3Dfy Anything in Images
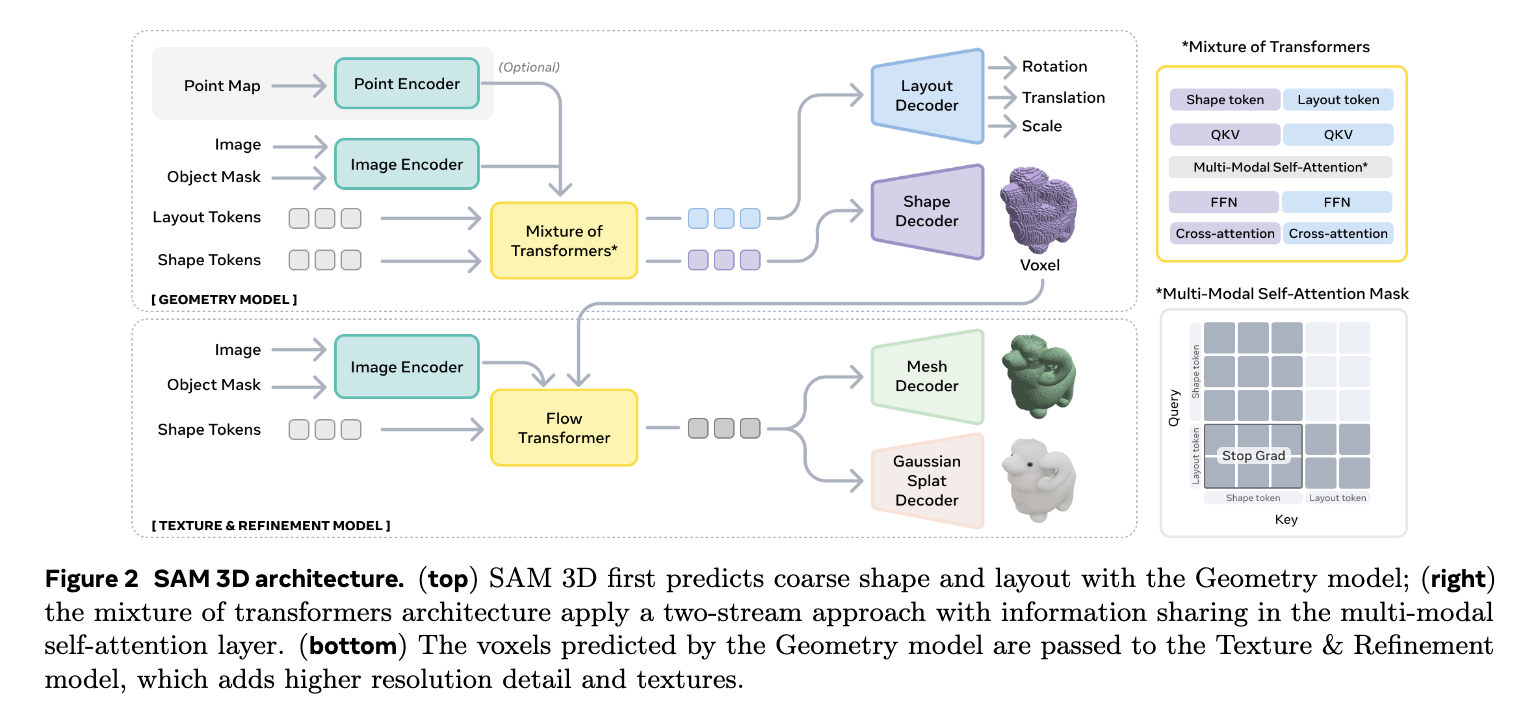
一句话与 SAM 3 协同的单图到 3D基础模型(SAM 3D Objects):一个生成式模型从单张图像预测物体的几何、纹理与布局,做视觉 grounded 的 3D 物体 / 场景重建,能应对遮挡与杂乱场景。
年份 / Venue arXiv 2025(2511.16624,2025-11-20)| 机构 Meta AI(SAM 3D Team;含 Dollár、Gkioxari、Malik 等)| 方向 单图到 3D 重建 | 基准 真实物体 / 场景人类偏好评测
材料 SAM 3D Objects Paper · Objects Code · 独立工作:SAM 3D Body
BibTeX
@article{sam3d2025,
  title   = {{SAM} 3D: 3Dfy Anything in Images},
  author  = {{SAM 3D Team}},
  journal = {arXiv preprint arXiv:2511.16624},
  year    = {2025},
  url     = {https://arxiv.org/abs/2511.16624}
}
Motivation
从单张真实图像重建 3D 一直受限于遮挡、杂乱背景与真实 3D 标注稀缺。SAM 3D 想做一个对「野外真实图片」鲁棒的视觉 grounded 3D 重建基础模型,把 SAM 的「分割任何东西」延伸到「3D 化任何东西」。
Method
- 两段式架构(本页配图):Geometry model 用 Mixture of Transformers(双流 + 多模态自注意力共享信息),从图像 / 物体掩码(可选 point map)预测粗几何(voxel)与布局(旋转 / 平移 / 尺度);再由 Texture & Refinement model(Flow Transformer)补细节与纹理,输出 Mesh / Gaussian Splat。
- 多阶段训练:合成数据预训练 + 真实数据对齐,配 human / model-in-the-loop 标注管线处理遮挡与场景杂乱。
Experiments
- 在论文定义的真实物体/场景人类偏好测试中,作者报告相对所选近期方法至少 5:1 的偏好比;该指标是主观成对评测,不等同于几何误差或真实机器人成功率。
Strengths and Limitations
Strengths:单图即可 3D、对真实遮挡 / 杂乱鲁棒、可输出 Mesh 或 Gaussian Splat;服务 AR / 电商 / 机器人感知。
局限:生成式重建对不可见部分靠先验「猜」;SAM 3D Body(人体网格,arXiv 2602.15989)为独立模型,二者定位不同。
Takeaways
一句话:把「分割任何东西」延伸成「3D 化任何东西」。 与 SAM3 协同(分割 → 3D),补全机器人感知里的几何重建一环。
Cross-Paper Comparison
| 简称 | 年份 | 监督 / 输入 | 核心机制 | 训练目标 | 一句话贡献 |
|---|---|---|---|---|---|
| CLIP | 2021 | 图文对 | 双塔 + InfoNCE | softmax 对比 | 图文对比学可迁移视觉塔 |
| SigLIP | 2023 | 图文对 | 双塔 + 成对 sigmoid | sigmoid 二分类 | 去全局归一化,省显存 |
| DINOv2 | 2023 | 纯图像 | 判别式自蒸馏 + 数据管线 | DINO+iBOT | 精选数据学强稠密特征 |
| DINOv3 | 2025 | 纯图像 | SSL scaling + Gram anchoring | 自蒸馏 | 大规模下保住稠密特征 |
| LLaVA | 2023 | 图 + 指令 | 视觉塔 + 投影 + LLM | 指令微调 | GPT-4 造数据的开源 VLM 模板 |
| Qwen-VL | 2023 | 图 + 文 + 框 | 视觉适配器 + 坐标 token | 三阶段训练 | 带 grounding/OCR 的多语种 VLM |
| InternVL | 2024 | 图 + 文 | InternViT-6B + 动态高分辨率 | 渐进对齐 | 大视觉塔的开源 VLM 系列 |
| FoundationPose | 2024 | RGBD + CAD/参考图 | 神经物体建模 + render-compare | 合成数据 + 排序 | 新物体 6D 位姿免微调 |
| SAM3 | 2025 | 图/视频 + 概念提示 | Detector + Tracker + Memory | PCS | 可提示概念分割 |
| SAM3D | 2025 | 单图 | Geometry + Texture 双模型 | 生成式重建 | 单图到 3D |
Discussion
-
两条表征路线:语言监督 vs 自监督。 CLIP/SigLIP 用文本当监督,特征天然与语言对齐、擅长语义;DINOv2/DINOv3 用图像自身当监督,特征几何 / 稠密强但需外接语言。下游选哪种塔,取决于任务更吃语义还是几何。
-
VLM 的骨架高度收敛。 LLaVA→Qwen-VL→InternVL 都是「视觉塔(CLIP/SigLIP/InternViT)+ 适配器 + LLM」;差异主要在适配器(线性 / MLP / cross-attn 压 token)与分辨率策略(固定 / 动态切图)。理解 LLaVA 一篇,等于拿到读懂这一组的钥匙。
-
损失与效率是暗线。 SigLIP 用 sigmoid 去掉 softmax 的全局归一化;InternVL 用 Pixel Shuffle 压高清切图的 token;FoundationPose 用合成数据绕开真实 3D 标注稀缺。做大之外,「怎么训得起 / 跑得动」同样是核心。
-
从「识别」走向「几何 + 3D」。 表征类(CLIP/DINO)→ 语义分割(SAM3)→ 位姿 / 3D(FoundationPose/SAM3D):视觉基础模型正把输出从「这是什么」推进到「在哪、什么姿态、什么形状」,这正是机器人操作最需要的。