
Overview
本篇是「基础模型」阅读笔记:把当代 AI / 机器人系统反复用到的八块底层积木放在一起精读。它们不是某个任务的解法,而是被 VLA、LLM、生成模型、离线 RL 反复复用的通用组件。
八块积木按四条线索组织(顺序从早到近、从简到繁):
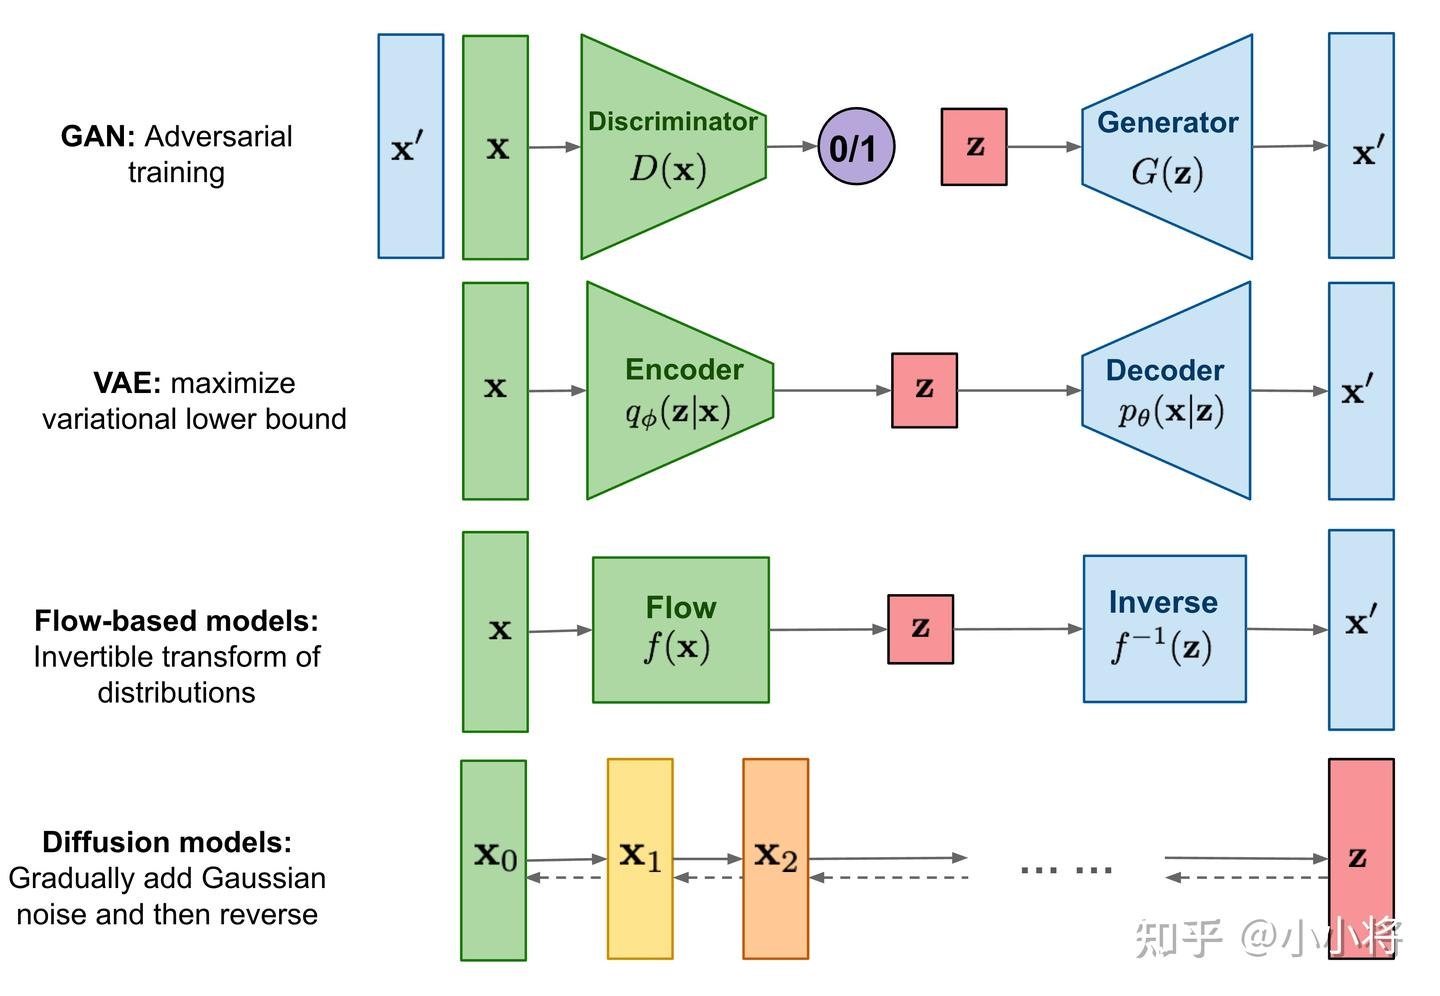
- 生成模型的两条早期路线 — VAE 用潜变量与变分下界近似优化边缘似然;NFs 用可逆变换和变量替换公式计算变换后变量的密度。二者都能学习可采样分布,但约束与适用方式不同。
- 通用注意力骨干 — Transformer(自注意力取代循环/卷积)→ ViT(把同一套骨干搬到视觉 patch)。后续几乎所有大模型都长在这上面。
- 连续生成的现代主线 — Diffusion(前向加噪 / 反向去噪)→ DiT(把扩散去噪网络从 U-Net 换成 Transformer)→ Flow(流匹配,免仿真地学噪声到数据的向量场)。
- 序列决策 — DT(把 Transformer 当作条件序列模型来做 RL)。
一条主线贯穿全篇:如何用可微、可扩展的神经网络,去逼近一个复杂分布或一个复杂映射。 VAE/NFs 从「显式建模似然」入手,Diffusion/Flow 从「学一个逐步变换过程」入手;Transformer/ViT/DT 则回答「用什么架构承载这些学习」。它们彼此交叉——DiT = Diffusion + Transformer,π0 类策略 = Flow + Transformer,DT = RL + Transformer——正是这些交叉构成了今天的基础模型版图。
Paper List
| 简称 | 年份 / Venue | 主题 | 一句话定位 |
|---|---|---|---|
| VAE | ICLR 2014 | 潜变量生成 | 变分下界 + 重参数化,摊销推断学生成模型 |
| NFs | ICML 2015 | 可逆密度 | 可逆变换堆叠 + 变量替换,可计算变换后密度 |
| Transformer | NeurIPS 2017 | 序列骨干 | 自注意力取代 RNN/CNN,可并行、建长程依赖 |
| ViT | ICLR 2021 | 视觉骨干 | 图像切 patch 当 token,纯 Transformer 做识别 |
| Diffusion | NeurIPS 2020 | 扩散生成 | 前向加噪 / 反向去噪,预测噪声即训练目标 |
| DiT | ICCV 2023 | 扩散骨干 | U-Net → Transformer,扩散随算力可扩展 |
| Flow | ICLR 2023 | 流匹配 | 免仿真回归向量场,OT 路径采样更直更快 |
| DT | NeurIPS 2021 | 序列决策 | RL 当序列建模,回报条件自回归预测动作 |
VAE
Auto-Encoding Variational Bayes
一句话用变分下界(ELBO)训练带连续潜变量的生成模型:一个识别网络(编码器)摊销地近似后验,配合重参数化技巧让采样可导,从而端到端用 SGD 学习。潜空间表示是后续 β-VAE、VQ-VAE、以及 Diffusion/DiT 潜空间的前置知识。
年份 / Venue ICLR 2014(arXiv 1312.6114, 2013)| 机构 Universiteit van Amsterdam(Kingma & Welling)| 方向 潜变量生成 / 变分推断 | 基准 MNIST, Frey Faces
材料 Paper
BibTeX
@article{kingma2014autoencoding,
  title   = {Auto-Encoding Variational Bayes},
  author  = {Kingma, Diederik P. and Welling, Max},
  journal = {arXiv preprint arXiv:1312.6114},
  year    = {2014},
  url     = {https://arxiv.org/abs/1312.6114}
}
Motivation
想学一个带潜变量的生成模型 ,难点在于后验 不可解,经典变分推断又要对每个数据点单独优化一套变分参数,无法随大数据集扩展。VAE 的目标:给出一个对连续潜变量、大数据集都高效的近似推断 + 学习算法。
Method
- 摊销推断:用一个神经网络(识别网络 / 编码器) 直接输出近似后验的参数(如高斯的 ),一套参数服务所有样本。
- 变分下界(ELBO):最大化对数似然的下界
前项是重构、后项把近似后验拉向先验 。
- 重参数化技巧(reparameterization):把 写成 ,使采样对 可导,得到低方差的 SGVB 梯度估计——这是全篇的关键。
Experiments
- 基准:MNIST、Frey Faces 等小图像数据集。
- 结果:随潜维度 / 数据量增加,变分下界稳定提升;能从潜空间采样生成可辨识样本,并给出比朴素 wake-sleep 等更优的下界。具体下界数值此处定性描述,不引用精确值。
Strengths and Limitations
Strengths:原理清晰、训练稳定、推断摊销后采样与编码都是一次前向;潜空间连续可插值,是表示学习与条件生成的通用底座。
局限:常见高斯观测模型可能产生偏平滑样本;解码器过强时可能忽略 ,形成 posterior collapse;ELBO 与真实对数边缘似然之间还存在 variational gap。Normalizing flow 可增强变分后验的表达力,VQ-VAE 使用离散潜码,扩散模型则采用不同的生成目标;它们不是针对同一个失败模式的统一修补。
Takeaways
VAE 给出用神经网络与变分下界学习潜变量模型的范式,核心概念是 ELBO、摊销推断与重参数化。Normalizing flow 可用于构造更灵活的后验,扩散模型提供另一类渐进生成目标;潜扩散则复用预训练自编码器的潜空间。几条路线有关联,但不能都归结为“解决 VAE 后验坍缩”。
NFs
Variational Inference with Normalizing Flows
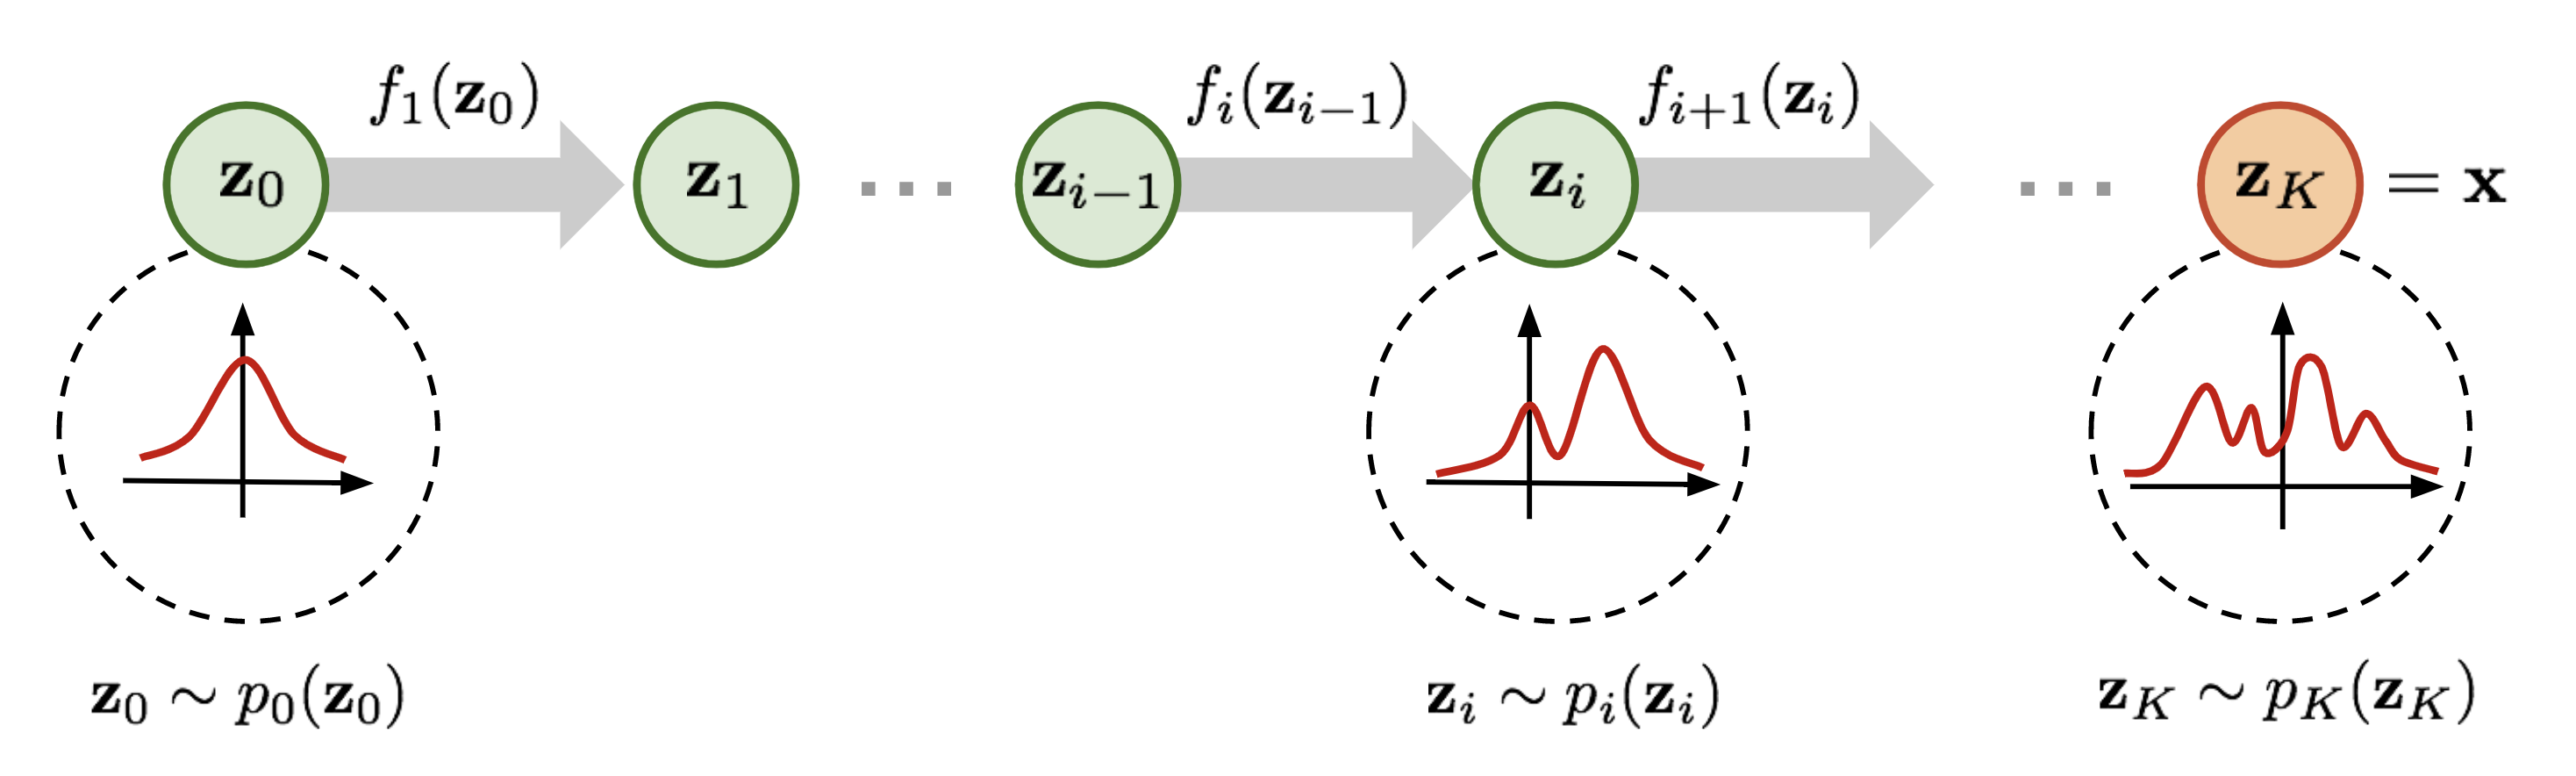
一句话把简单分布经过一串可逆变换映射为复杂分布,并用变量替换公式计算变换后变量的密度。Flow 可以作为 VAE 的灵活近似后验,也可以直接构造显式密度模型;前一种情况下,后验密度可计算并不意味着潜变量模型的边缘似然自动变为闭式可解。
年份 / Venue ICML 2015(arXiv 1505.05770)| 机构 Google DeepMind(Rezende & Mohamed)| 方向 可逆密度 / 变分推断 | 基准 MNIST, CIFAR(作为 VAE 后验)
材料 Paper
BibTeX
@inproceedings{rezende2015variational,
  title     = {Variational Inference with Normalizing Flows},
  author    = {Rezende, Danilo Jimenez and Mohamed, Shakir},
  booktitle = {International Conference on Machine Learning},
  year      = {2015},
  url       = {https://arxiv.org/abs/1505.05770}
}
Motivation
VAE 的近似后验通常是对角高斯,表达力太弱,限制了下界的紧致度。NFs 的动机:构造任意灵活但仍可精确求密度的分布族,用来当更好的后验(也可独立作生成模型)。
Method
- 可逆变换链:从简单基分布 出发,施加一串可逆映射 。
- 变量替换(change of variables):密度按雅可比行列式修正
- 廉价行列式的流:论文提出 planar flow 与 radial flow,利用矩阵行列式引理把 的计算降到 ,使深层堆叠可行。
Experiments
- 基准:作为 VAE 的后验近似,在 MNIST / CIFAR 上评估。
- 结果:随流长度 增加,近似后验更贴近真实后验、下界更紧,优于对角高斯与早期 NICE 等基线。具体下界数值此处定性描述,不引用精确值。
Strengths and Limitations
Strengths:对于独立的 normalizing-flow 密度模型,变量替换给出可计算的精确对数密度;密度表达灵活,采样与密度评估均可直接执行。作为 VAE 后验时,整体模型仍通常通过 ELBO 训练。
局限:为保证雅可比行列式可算,架构受强约束(planar/radial 单步表达力有限,需堆很多层);后续 RealNVP、IAF、Glow 用耦合层 / 自回归结构增强表达力,但可逆性约束始终是流模型的根本张力。
Takeaways
NFs 以可逆变换和可计算密度为核心,与 VAE 的变分下界、Diffusion 的渐进去噪形成不同建模选择。变量替换与 Jacobian 行列式也是理解连续归一化流(CNF)的入口;Flow Matching 则进一步直接学习连续向量场。
Transformer
Attention Is All You Need
一句话用自注意力彻底取代 RNN 的循环与 CNN 的局部卷积:序列中每个位置直接与所有位置交互,既可并行训练又能建长程依赖。它是 LLM、ViT、DiT、DT 乃至几乎所有现代大模型的共同祖先。
年份 / Venue NeurIPS 2017(arXiv 1706.03762)| 机构 Google Brain / Google Research | 方向 序列 transduction 骨干 | 基准 WMT’14 EN-DE / EN-FR 机器翻译
BibTeX
@inproceedings{vaswani2017attention,
  title     = {Attention Is All You Need},
  author    = {Vaswani, Ashish and Shazeer, Noam and Parmar, Niki and Uszkoreit, Jakob
               and Jones, Llion and Gomez, Aidan N. and Kaiser, Lukasz and Polosukhin, Illia},
  booktitle = {Advances in Neural Information Processing Systems},
  year      = {2017},
  url       = {https://arxiv.org/abs/1706.03762}
}
Motivation
RNN 的计算沿时间步串行,无法并行、且长程依赖随距离衰减;CNN 虽可并行但需堆很多层才能覆盖长程。Transformer 的问题意识:能否只用注意力、完全去掉循环与卷积,既拿到并行度又拿到「任意两位置常数距离交互」?
Method
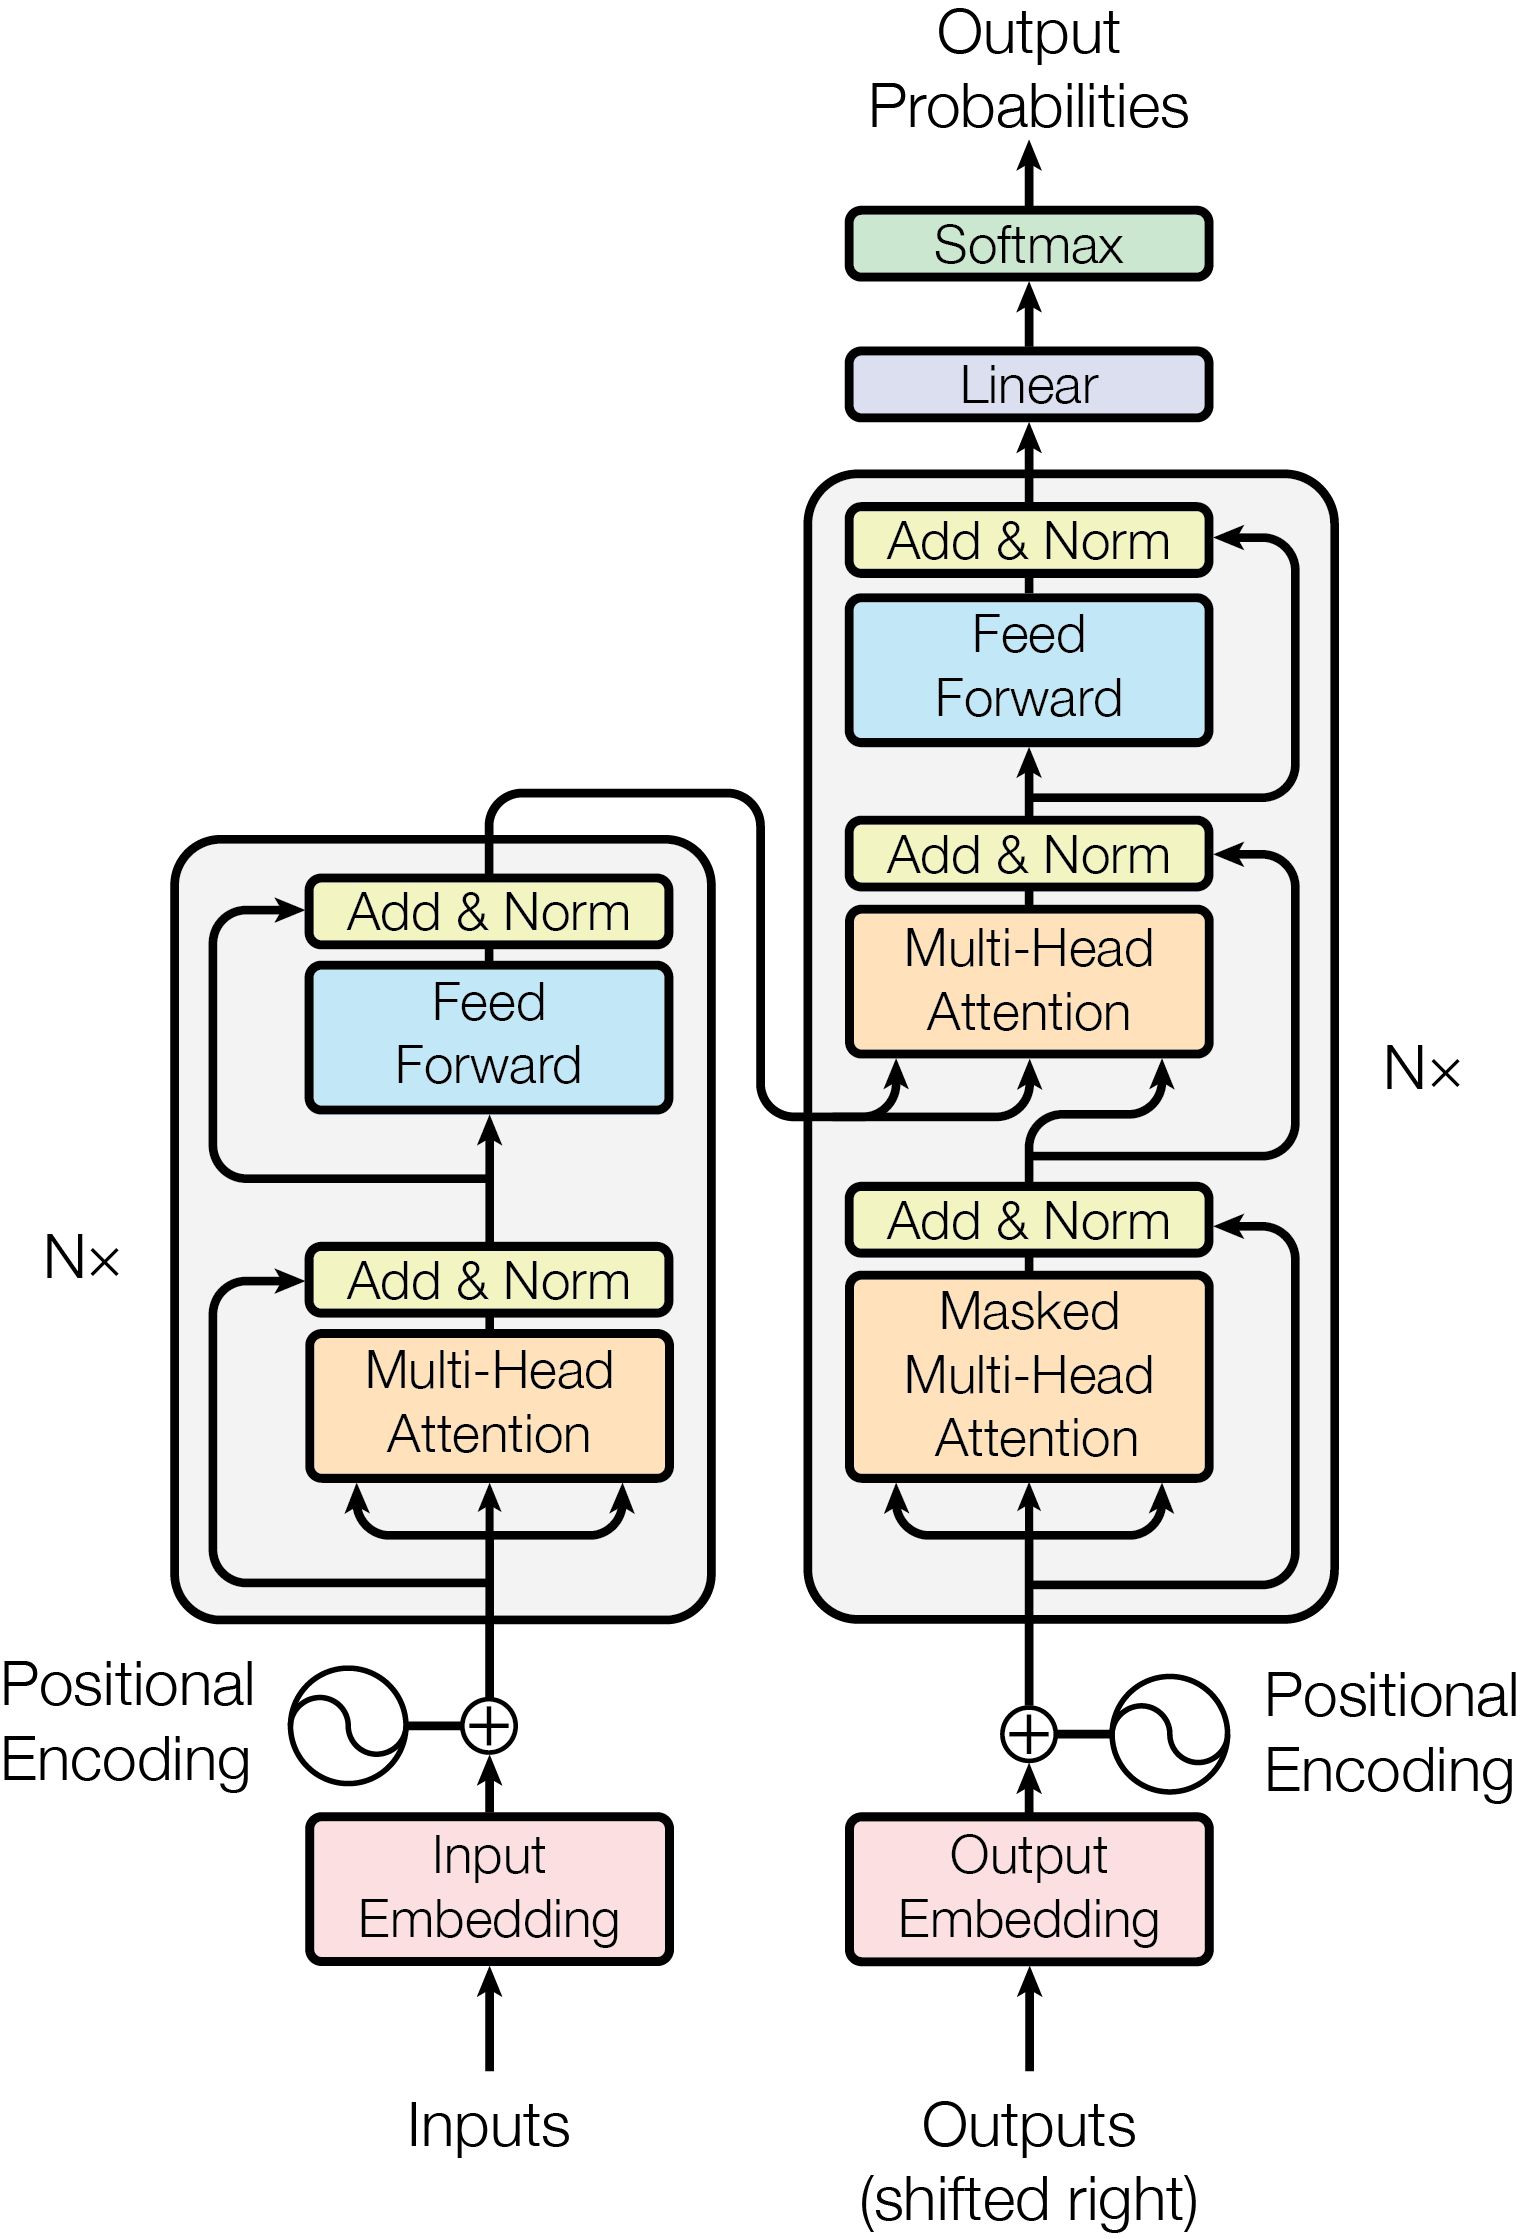
- 缩放点积注意力:
除以 防止点积过大导致 softmax 梯度消失。
- 多头注意力(multi-head):把 投影到多个子空间并行做注意力再拼接,让模型同时关注不同类型的关系。
- 位置编码:注意力本身对顺序不敏感,用正弦位置编码注入位置信息。
- 整体:编码器–解码器堆叠,每层 = 多头注意力 + 位置前馈网络(FFN),配 残差连接 + LayerNorm;解码器用掩码保证自回归。
Experiments
- 基准:WMT’14 英德 / 英法机器翻译。
- 论文结果:大模型在 EN-DE 达 28.4 BLEU、EN-FR 达 41.8 BLEU,均为当时该评测设置下的领先结果;论文同时报告其训练成本低于所比较的循环与卷积模型。
Strengths and Limitations
Strengths:高度并行、长程依赖直接、随数据与参数极佳扩展——这是它成为一切大模型骨干的根本原因。
局限:自注意力对序列长度是 计算/显存;需显式位置编码;小数据上因缺乏归纳偏置不如 CNN/RNN。后续 sparse/linear attention、FlashAttention、RoPE 等围绕这些点改进。
Takeaways
Transformer 是本篇的枢纽:ViT 把它搬到图像、DiT 把它搬进扩散去噪、DT 把它搬去做序列决策。读懂「注意力 + 多头 + 残差/LN + 位置编码」这套结构,本页后面一半的模型都只是它的变体。
ViT
An Image is Worth 16×16 Words: Transformers for Image Recognition at Scale
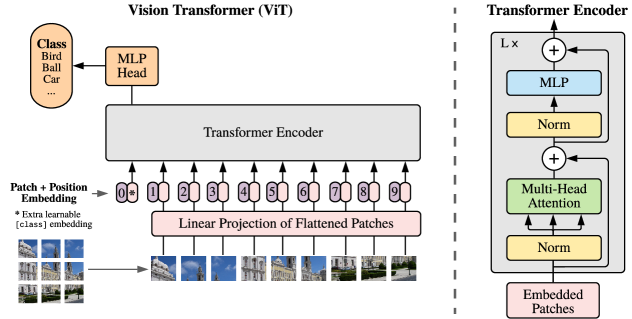
一句话把图像切成固定大小的 patch 序列,线性嵌入后当作 token 直接喂给标准 Transformer 编码器——几乎不改架构就把 NLP 的骨干搬到视觉。关键结论:够大规模预训练后,纯 Transformer 可匹敌乃至超越 CNN。
年份 / Venue ICLR 2021(arXiv 2010.11929)| 机构 Google Research(Brain Team)| 方向 视觉骨干 | 基准 ImageNet / ImageNet-21k / JFT-300M 预训练 + 下游迁移
BibTeX
@inproceedings{dosovitskiy2021image,
  title     = {An Image is Worth 16x16 Words: Transformers for Image Recognition at Scale},
  author    = {Dosovitskiy, Alexey and Beyer, Lucas and Kolesnikov, Alexander and Weissenborn, Dirk
               and Zhai, Xiaohua and Unterthiner, Thomas and Dehghani, Mostafa and Minderer, Matthias
               and Heigold, Georg and Gelly, Sylvain and Uszkoreit, Jakob and Houlsby, Neil},
  booktitle = {International Conference on Learning Representations},
  year      = {2021},
  url       = {https://arxiv.org/abs/2010.11929}
}
Motivation
CNN 长期垄断视觉,其局部性 + 平移等变是很强的归纳偏置。ViT 的问题:如果数据足够多,能否不要这些先验、直接用通用 Transformer 学视觉?动机是把 NLP 里「大数据 + 大模型 + 通用架构」的成功复制到图像。
Method
- patchify:把 图像切成 的 patch,每个 patch 展平后线性投影成一个 token embedding。
- 序列构造:patch embedding + 可学习位置嵌入,前置一个 [class] token 作为分类表示(借鉴 BERT)。
- 主干:标准 Transformer 编码器;[class] token 的输出接 MLP 头做分类。除切 patch 外,几乎不引入图像专属结构。
Experiments
- 基准:在 ImageNet-21k / JFT-300M 上大规模预训练,再迁移到 ImageNet 等下游。
- 结果:中小数据上 ViT 逊于同级 ResNet(缺归纳偏置);但在大规模预训练后,ViT 匹配或超过强 CNN 基线(BiT),且预训练算力更省。具体各基准精度此处定性描述,不引用精确数值。
Strengths and Limitations
Strengths:全局感受野、随数据/规模扩展性好、与 NLP 骨干统一(利于多模态);成为 CLIP、多数 VLM 视觉塔与视觉预训练的默认选择之一。
局限:数据饥渴(弱归纳偏置需大数据补偿); 注意力对高分辨率昂贵。后续 DeiT(蒸馏省数据)、Swin(层级 + 窗口注意力)针对性改进。
Takeaways
ViT 表明标准 Transformer 在足够数据和正则化下也能用于图像分类。它把图像切成 patch token,再沿用序列 Transformer;DiT 采用相似 token 化思路,但优化目标是扩散去噪而不是分类。应用侧可对照 Vision Foundation Models。
Diffusion
Denoising Diffusion Probabilistic Models (DDPM)
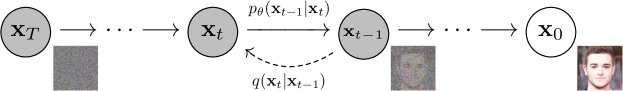
一句话定义一个前向过程逐步往数据里加高斯噪声直至纯噪声,再训练一个网络学反向去噪过程。关键简化:把变分目标化简成预测每步噪声 的均方误差,训练稳定、样本质量高——现代图像/视频生成与 Diffusion Policy 的数学起点。
年份 / Venue NeurIPS 2020(arXiv 2006.11239)| 机构 UC Berkeley(Ho, Jain, Abbeel)| 方向 扩散生成 | 基准 CIFAR-10, LSUN, CelebA-HQ
材料 Paper · Project/Blog · Code
BibTeX
@inproceedings{ho2020denoising,
  title     = {Denoising Diffusion Probabilistic Models},
  author    = {Ho, Jonathan and Jain, Ajay and Abbeel, Pieter},
  booktitle = {Advances in Neural Information Processing Systems},
  year      = {2020},
  url       = {https://arxiv.org/abs/2006.11239}
}
Motivation
GAN 样本质量高但训练不稳、易模式崩塌;VAE 稳但样本模糊。扩散模型(Sohl-Dickstein 2015)理论优雅但当时质量一般。DDPM 的目标:把扩散模型的样本质量做到与 GAN 竞争,同时保留似然模型的稳定训练与模式覆盖。
Method
- 前向过程(固定、无参数):,可闭式跳步:
- 反向过程(学习): 用网络(原文用 U-Net)参数化。
- 简化目标:将变分下界重参数化后,训练目标等价于预测注入的噪声:
这一步把复杂的 KL 目标变成朴素回归,是 DDPM 好训练的关键;并揭示与去噪得分匹配 / Langevin 采样的联系。
Experiments
- 基准:CIFAR-10、LSUN、CelebA-HQ 等无条件 / 类条件图像生成。
- 论文结果:CIFAR-10 无条件生成达 FID 3.17、Inception Score 9.46,为当时该设定下的领先结果;论文报告高分辨率 LSUN 样本质量与 ProgressiveGAN 相当。
Strengths and Limitations
Strengths:样本质量高、训练稳定(纯回归损失)、模式覆盖好、易做条件生成。
局限:采样慢——需数百上千步反向迭代(后续 DDIM、少步蒸馏、一致性模型缓解);原始 U-Net 骨干扩展性有限(DiT 换 Transformer 解决);像素空间直接扩散昂贵(潜扩散 / Stable Diffusion 移到 VAE 潜空间)。
Takeaways
DDPM 把「加噪—去噪」变成一个可训练、可扩展的生成范式。它的两处软肋——采样慢与骨干选择——分别通向 Flow(更直的路径、更少步)与 DiT(Transformer 骨干),也直接支撑机器人里的 Diffusion Policy。
DiT
Scalable Diffusion Models with Transformers
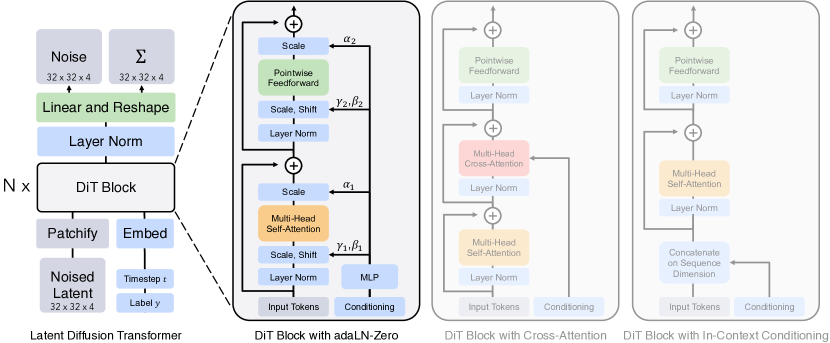
一句话DiT 用 Transformer 替换扩散模型常用的 U-Net 去噪器:在 VAE 潜空间中将 latent 划分为 patch,并用带 adaLN-Zero 条件注入的 Transformer 块预测去噪目标。论文在所测试模型族中观察到:增加去噪网络计算量(Gflops)与 FID 改善存在较稳定的相关趋势。
年份 / Venue ICCV 2023(arXiv 2212.09748)| 机构 UC Berkeley / New York University(Peebles & Xie)| 方向 扩散骨干 / 可扩展生成 | 基准 ImageNet 256×256 / 512×512 类条件生成
BibTeX
@inproceedings{peebles2023scalable,
  title     = {Scalable Diffusion Models with Transformers},
  author    = {Peebles, William and Xie, Saining},
  booktitle = {Proceedings of the IEEE/CVF International Conference on Computer Vision},
  year      = {2023},
  url       = {https://arxiv.org/abs/2212.09748}
}
Motivation
扩散模型一直默认用 U-Net 做去噪网络,其归纳偏置和可扩展性未被系统检验。而 Transformer 在 NLP/视觉上已展现清晰扩展律。DiT 的问题:用 Transformer 替换 U-Net,扩散能否获得同样干净的「越大越好」扩展性?
Method
- 潜空间 + patchify:沿用潜扩散,在预训练 VAE 的 latent 上操作;把 latent 切成 patch token(呼应 ViT)。
- DiT 块:标准 Transformer 块处理 patch 序列做噪声预测。
- 条件注入 adaLN-Zero:把时间步 与类别标签经 MLP 映射为 自适应 LayerNorm 的缩放/平移参数注入每个块,并将残差分支初始化为零(zero-init),显著稳住训练——这是 DiT 的关键设计。
- 扩展轴:以模型 Gflops(深度/宽度/patch 大小)为轴系统扫描。
Experiments
- 基准:ImageNet 类条件生成 256×256 与 512×512。
- 论文结果:最大模型 DiT-XL/2 在 256×256 达 FID 2.27,为当时该基准的领先结果;在论文测试的模型配置中,FID 随去噪网络 Gflops 增加而下降。
Strengths and Limitations
Strengths:干净的扩展律、去掉 U-Net 的手工归纳偏置、与 Transformer 生态(并行、大模型工程)统一;是 Stable Diffusion 3、Sora 等现代生成系统的架构基础。
局限:依赖预训练 VAE(两阶段);大模型训练/采样算力高;与所有扩散一样受采样步数拖累。
Takeaways
DiT = Diffusion 的过程 + Transformer/ViT 的骨干,是「架构统一到 Transformer」这条大趋势在生成领域的落点。机器人里的 RDT 等大型扩散策略正是同一条架构线。
Flow
Flow Matching for Generative Modeling
一句话不学「逐步去噪」,而是免仿真地回归一个向量场:定义从噪声到数据的概率路径,训练网络去匹配沿该路径的目标速度场。用最优传输(OT)式的直线路径时,采样轨迹更直、步数更少——π0 类机器人策略与 SD3 等采用。
年份 / Venue ICLR 2023(arXiv 2210.02747;Oral / Outstanding)| 机构 Meta AI (FAIR) / Weizmann(Lipman 等)| 方向 连续时间生成 / 流匹配 | 基准 ImageNet(图像生成、似然)
BibTeX
@inproceedings{lipman2023flow,
  title     = {Flow Matching for Generative Modeling},
  author    = {Lipman, Yaron and Chen, Ricky T. Q. and Ben-Hamu, Heli and Nickel, Maximilian and Le, Matt},
  booktitle = {International Conference on Learning Representations},
  year      = {2023},
  url       = {https://arxiv.org/abs/2210.02747}
}
Motivation
连续归一化流(CNF)表达力强但训练要仿真 ODE、昂贵;扩散的 SDE / 得分匹配框架有效但推导绕、采样慢。Flow Matching 的目标:给出一个免仿真、回归式的目标,直接学出定义生成过程的向量场,并能自由选择概率路径。
Method
- 目标:学一个时间相关向量场 ,其诱导的 ODE 把噪声分布 沿概率路径 输运到数据分布 。
- Conditional Flow Matching (CFM):直接回归边缘向量场不可解,但以单个数据点为条件的路径 及其速度 可闭式写出,且二者的回归目标梯度相同:
- OT 路径:取高斯条件路径 + 线性插值()时,轨迹接近直线,采样所需 ODE 步数更少、训练更稳。扩散是它的一个特例(特定路径)。
Experiments
- 基准:ImageNet 图像生成与似然评估。
- 结果:以 OT 路径的 Flow Matching 训练 CNF,在样本质量、似然与采样效率上匹配或优于扩散基线,且训练更稳定。具体 FID / NLL 此处定性描述,不引用精确数值。
Strengths and Limitations
Strengths:免仿真训练、路径可自由设计(OT 路径采样更快更直)、把扩散/CNF 统一在一个回归框架下;已成机器人策略(π0)与新一代图像生成(SD3)的主流选择。
局限:采样仍需数值 ODE 求解;生态较扩散年轻;OT 路径的优势依赖路径/耦合设计。
Takeaways
Flow Matching 通过回归条件概率路径对应的向量场来训练连续归一化流;扩散概率路径是其可选路径族之一。Optimal-Transport displacement interpolation 在原论文实验中带来更高效的训练和采样,但推理仍需数值求解 ODE,步数优势取决于路径、模型和求解器。原论文
DT
Decision Transformer: Reinforcement Learning via Sequence Modeling
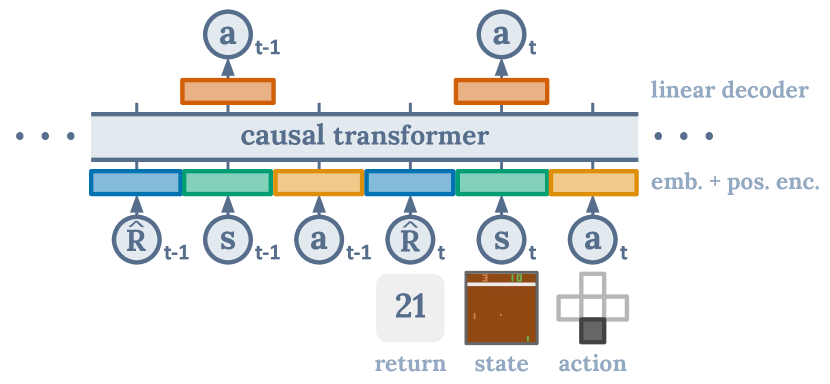
一句话把 RL 轨迹当成一条序列 (return-to-go, state, action, …),用 GPT 式 Transformer 自回归地预测动作,以「期望回报」为条件。不做价值自举、不做动态规划——把(离线)RL 直接化为监督式序列建模。
年份 / Venue NeurIPS 2021(arXiv 2106.01345)| 机构 UC Berkeley / Facebook AI / Google Brain | 方向 离线 RL / 序列建模 | 基准 Atari, D4RL, Key-to-Door
BibTeX
@inproceedings{chen2021decision,
  title     = {Decision Transformer: Reinforcement Learning via Sequence Modeling},
  author    = {Chen, Lili and Lu, Kevin and Rajeswaran, Aravind and Lee, Kimin and Grover, Aditya
               and Laskin, Michael and Abbeel, Pieter and Srinivas, Aravind and Mordatch, Igor},
  booktitle = {Advances in Neural Information Processing Systems},
  year      = {2021},
  url       = {https://arxiv.org/abs/2106.01345}
}
Motivation
传统 RL 靠 TD 自举 + 动态规划,面临 致命三要素、离线分布偏移等稳定性难题。DT 的问题意识:既然 Transformer 在序列建模上如此强大,能否绕开价值/策略梯度,把 RL 直接当成「给定想要的回报,预测该做什么动作」的条件序列建模?
Method
- 轨迹序列化:把轨迹表示为 ,其中 return-to-go 是从当前起的剩余回报。
- 自回归建模:GPT 式因果 Transformer 以过去 token 为条件预测下一个动作 ,训练是纯监督(对动作做回归/分类),无 TD、无 bootstrapping。
- 回报条件生成:推理时把 设为期望目标回报,模型据此「演」出达成该回报的动作序列;注意力天然处理长程信用分配。
Experiments
- 基准:Atari(离线)、D4RL(连续控制)、Key-to-Door(长程信用分配)。
- 结果:原论文在 Atari、OpenAI Gym 和 Key-to-Door 的指定离线数据设置中,报告了与若干 model-free offline RL 基线相当或更好的结果。不同任务上的相对排名并不一致,因此不把这些实验概括为普遍的长程信用分配优势。原论文
Strengths and Limitations
Strengths:概念极简、复用 Transformer 的扩展性与工程、无 TD 不稳定;长程信用分配由注意力自然承担。
局限:性能受数据集回报覆盖限制,难以「拼接」次优轨迹超越数据(stitching 弱于动态规划类方法);依赖设定合理的目标回报;本质离线。后续 Trajectory Transformer、Online DT、Q-learning DT 等改进。
Takeaways
DT 展示了「Transformer 骨干 + 序列建模」可以吞下决策问题,是本页架构线与 RL 线的交汇点。它与离线 RL(CQL/IQL)解决同一问题的两种哲学——序列建模 vs. 保守价值学习——值得对照。
Cross-Paper Comparison
| 模型 | 年份 | 类别 | 核心机制 | 训练目标 | 主要贡献 / 对治问题 |
|---|---|---|---|---|---|
| VAE | 2014 | 潜变量生成 | 编码器 + 重参数化 | ELBO(下界) | 摊销变分推断,可导潜变量学习 |
| NFs | 2015 | 可逆密度 | 可逆变换 + 变量替换 | 精确对数似然 | 灵活后验 / 精确似然 |
| Transformer | 2017 | 序列骨干 | 自注意力 + 多头 | 序列预测(如翻译) | 去循环、并行、建长程依赖 |
| ViT | 2021 | 视觉骨干 | patch token + 编码器 | 分类交叉熵 | Transformer 通用于视觉(需大数据) |
| Diffusion | 2020 | 扩散生成 | 前向加噪 / 反向去噪 | 预测噪声 MSE | 稳定训练、高质量样本 |
| DiT | 2023 | 扩散骨干 | patch + adaLN-Zero | 扩散去噪 | U-Net→Transformer,可扩展扩散 |
| Flow | 2023 | 流匹配 | 回归向量场 (CFM) | 条件向量场 MSE | 免仿真、OT 路径少步采样 |
| DT | 2021 | 序列决策 | 回报条件自回归 | 动作监督 | RL 化为序列建模,无 TD |
Discussion
-
两大脉络:生成 vs 骨干。 一条线是「怎么学一个分布」——VAE(下界)、NFs(精确似然)、Diffusion/Flow(渐进变换 / 向量场);另一条线是「用什么架构承载学习」——Transformer→ViT→DT。二者在 DiT(扩散 × Transformer)交汇,也在机器人 π0(Flow × Transformer)交汇。
-
架构在收敛到 Transformer。 ViT 把视觉、DiT 把扩散、DT 把决策统统改造成「切成 token 序列 + 注意力」。理解 Transformer 一篇,等于拿到读懂本页一半模型的钥匙。
-
生成建模的三种数学味道。 VAE 是变分下界、NFs 是可逆 + 精确似然、Diffusion/Flow 是渐进随机 / 确定性变换。三者互为参照:Flow Matching 甚至把扩散收作特例,NFs 与 CNF/Flow 一脉相承。
-
「采样效率」是连续生成的暗线。 扩散样本好但步数多;Flow 用 OT 直线路径压步数;这条线继续通向少步蒸馏 / 一致性模型。机器人实时控制尤其吃这一点。