
Overview
世界模型(world model)指一个学到的、能预测环境如何随动作演化的模型:给定当前状态与动作,预测未来(未来观测、未来表征或未来奖励)。有了它,智能体就能在「想象」里做规划、试错、学策略,而不必每一步都真的和世界交互——这对样本昂贵的机器人尤其关键。
本篇把 world model 的代表作按两条建模路线串起来:
生成式 / 重建式(reconstructive):预测未来的像素、观测或其分布,Dreamer、RoboDreamer、FOCUS 属于这一类。TD-MPC 更适合称为任务导向的潜在动力学模型:它预测控制所需的潜状态、奖励与价值,而不重建完整观测。
非生成式(predictive / JEPA):只在表征空间预测,不重建像素。JEPA / V-JEPA 是 LeCun 力推的这条线——赌「世界的可预测结构在抽象表征里,而非像素细节里」。
七篇的定位:
- Dreamer — RSSM 潜空间 + 想象轨迹中的 actor-critic;DreamerV3 在论文的 150 多项任务上使用同一组主要超参数。
- DayDreamer — 把 Dreamer 直接搬上真实机器人在线学习,1 小时学会四足行走。
- TD-MPC — 潜空间 MPC + TD 学的终值函数,model-based 与 model-free 的缝合。
- RoboDreamer — 组合式视频世界模型:把指令拆成原语、组合扩散模型,泛化到没见过的指令组合。
- FOCUS — 物体中心世界模型:显式建实体,用物体中心探索奖励更好地探索物体交互。
- JEPA (I-JEPA) — 非生成的联合嵌入预测架构:从 context 预测 target 的表征而非像素。
- V-JEPA — 把 JEPA 搬到视频:纯特征预测学到既懂运动又懂外观的通用表征。
一条主线:世界模型的核心分歧不是「用不用」,而是「在什么抽象层级预测世界」——像素、潜状态、还是纯表征。
Paper List
| 简称 | 年份 / Venue | 路线 | 预测什么 | 如何出动作 | 核心思想 |
|---|---|---|---|---|---|
| Dreamer | ICLR 2020→2023 | 生成式 | 未来潜状态 + 像素重建 | 想象里学 actor-critic | RSSM + latent imagination;V3 跨任务统一主要超参数 |
| DayDreamer | CoRL 2022 | 生成式 | 同上(真机在线) | 同上 | Dreamer 直接上真实机器人,1h 学会走 |
| TD-MPC | ICML 2022 | 任务导向的潜在动力学 | 潜动态 + 奖励 + 终值 | 潜空间 MPC 规划 | 短程 MPPI 规划 + TD 终值,model-based×free |
| RoboDreamer | ICML 2024 | 生成式(视频) | 未来视频(组合式) | 视频→逆动力学 | 拆指令为原语、组合扩散,组合泛化 |
| FOCUS | arXiv 2023 | 生成式(物体中心) | 物体分割/RGB/本体 | 物体中心探索 + 规划 | object-centric world model + 探索奖励 |
| JEPA | ICCV 2023 | 非生成的静态表征学习 | target 块的表征 | (表征预训练) | 时序 JEPA 的前身,而非控制模型 |
| V-JEPA | arXiv 2024 | 非生成(视频) | 掩码时空块的表征 | (表征预训练) | 纯特征预测,冻结骨干即强 |
Dreamer
Dreamer / DreamerV3: Mastering Diverse Domains through World Models
一句话Dreamer 使用 RSSM 将高维观测编码成潜状态并学习动态,再用 latent rollouts 训练 actor-critic。DreamerV3 结合 symlog、two-hot、free bits 和 KL balancing 等设计,在论文覆盖的 150 多项任务中使用同一组主要超参数;作者还报告它是首个在其设定中无需人类数据或课程、从零收集 Minecraft 钻石的算法。DreamerV3
年份 / Venue Dream to Control(ICLR 2020)→ DreamerV2(ICLR 2021)→ DreamerV3(arXiv 2023)| 机构 DeepMind · Toronto | 方向 Model-based RL, latent imagination | 真机 见 DayDreamer
BibTeX
@article{hafner2023dreamerv3,
  title   = {Mastering Diverse Domains through World Models},
  author  = {Hafner, Danijar and Pasukonis, Jurgis and Ba, Jimmy and Lillicrap, Timothy},
  journal = {arXiv preprint arXiv:2301.04104},
  year    = {2023},
  url     = {https://arxiv.org/abs/2301.04104}
}
Motivation
强化学习换个领域就要重新调参、堆人力。Dreamer 想要一个通用的 model-based 算法:学一个环境模型,在其中「想象未来」来改进行为,从而既样本高效又能跨领域即插即用。难点在于,让同一套超参在从 Atari 到连续控制到 Minecraft 的迥异任务上都稳定,需要解决不同任务间回报尺度、稀疏度、观测模态的巨大差异。
Method
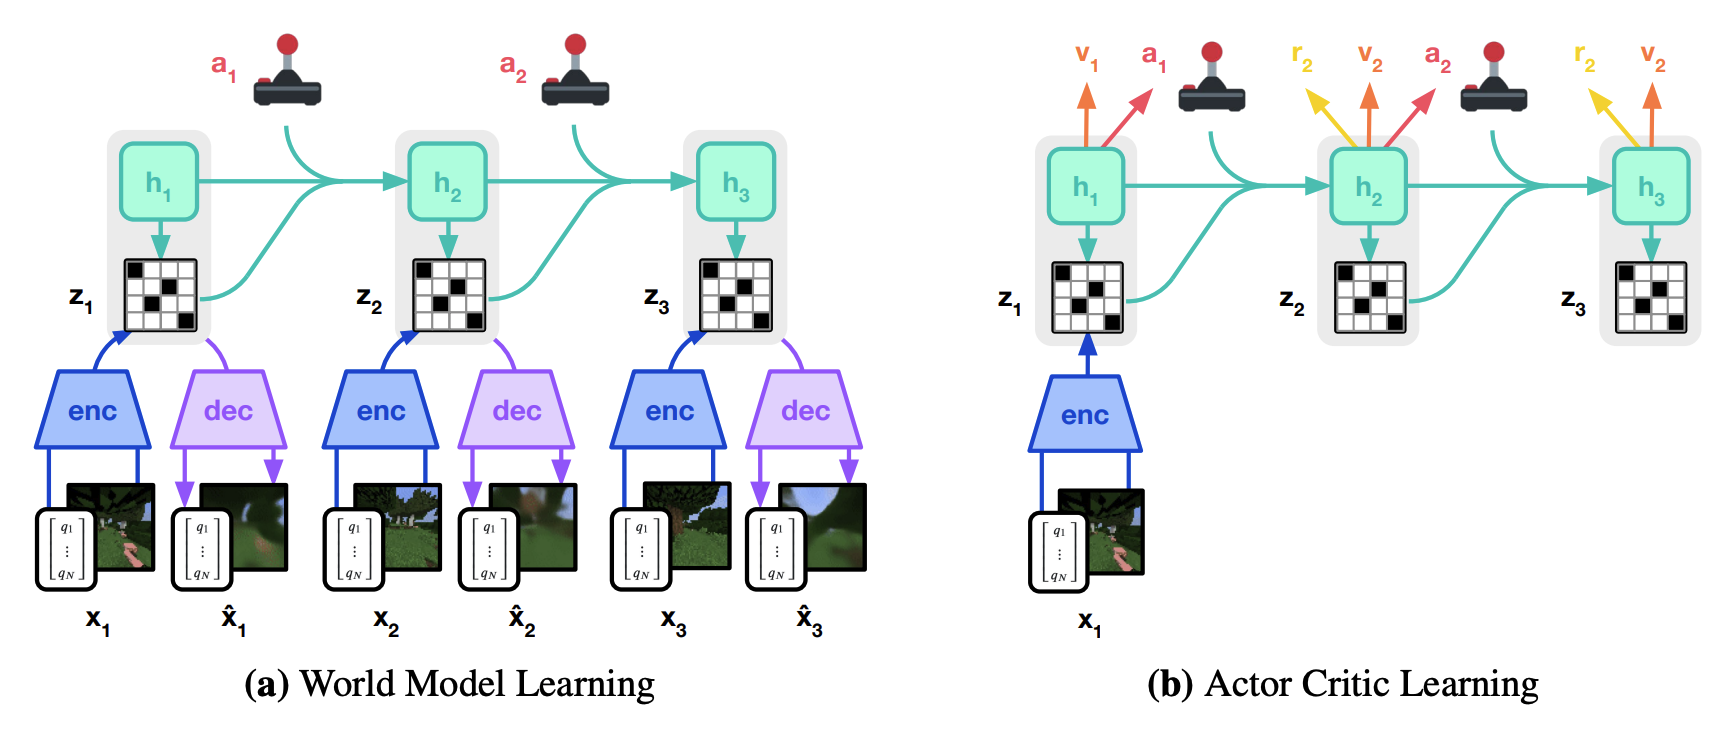
- RSSM(Recurrent State-Space Model):世界模型的核心。用编码器把观测 压成随机潜状态 ,配一个确定性循环状态 ;模型学习转移(给定 预测下一个 )、观测重建(解码回像素,提供学习信号)与奖励/连续性预测。
- 想象里学 actor-critic:世界模型学好后,从真实经验的潜状态出发,在潜空间里 rollout 一段想象轨迹;actor 最大化想象回报、critic 估值,完全不碰真实环境——这是样本效率的来源。
- DreamerV3 的跨任务训练配方:
- symlog 变换压缩回报/值的尺度差异;
- two-hot 离散回归让值/奖励预测更稳;
- free bits 防止 KL 项塌缩;
- KL balancing 平衡表征学习与动态学习。
- 演进:V1(Dream to Control)确立 latent imagination;V2 在 Atari 用离散潜变量登顶;V3 加鲁棒性配方并扩展到 Minecraft/连续控制等 150+ 任务。
Experiments
- 广度:DreamerV3 用单一配置在 150+ 任务(Atari、DMControl、ProcGen、Crafter、Minecraft 等)上超过为各领域专门调过的方法。
- 头条:首个从零、无人类数据/课程在 Minecraft 里挖到钻石的算法——需要从像素与稀疏奖励里探索远期策略。
- 规模律:更大模型同时提升最终性能与数据效率(论文给出 scaling 曲线)。具体逐任务分数未逐一核到,此处引用「一套超参 150+ 任务、Minecraft 钻石」两条头条。
Strengths and Limitations
Strengths:世界模型 + 想象训练的样本效率;跨领域免调参(工程价值极高);鲁棒性配方可复用(symlog/two-hot 已被广泛借用);开源、可复现。
局限(分析):仍是生成式——要重建像素,算力与建模负担随观测复杂度上升,且像素级细节未必都与控制相关;RSSM 的想象在长时程/高随机环境下会累积误差;Minecraft 之外的开放世界泛化仍有限。
Takeaways
Dreamer 定义了「学世界模型 → 在想象里学策略」这套现代 model-based RL 范式。后面 DayDreamer 把它搬上真机、TD-MPC 换成「潜空间规划」、FOCUS 换成「物体中心」,而 JEPA 线则质疑「到底要不要重建像素」。
DayDreamer
DayDreamer: World Models for Physical Robot Learning
一句话把 Dreamer 直接搬到真实机器人上在线学习、无仿真:在真机上边采数据边学世界模型、在想象里学行为,用同一套超参让四足机器人 1 小时从零学会站立行走、机械臂从像素 + 稀疏奖励学会抓放。
年份 / Venue CoRL 2022 | 机构 UC Berkeley(+ DeepMind)| 方向 Real-world model-based robot learning | 真机 ✅ 四足 A1 / 两台机械臂 / 轮式机器人
BibTeX
@inproceedings{wu2022daydreamer,
  title     = {{DayDreamer}: World Models for Physical Robot Learning},
  author    = {Wu, Philipp and Escontrela, Alejandro and Hafner, Danijar
               and Goldberg, Ken and Abbeel, Pieter},
  booktitle = {Conference on Robot Learning (CoRL)},
  year      = {2022},
  url       = {https://arxiv.org/abs/2206.14176}
}
Motivation
深度 RL 往往需要大量交互,真机试错成本高,因此许多工作依赖仿真。Dreamer 的关键不是部署时执行显式 MPC 搜索,而是在学习到的潜在动力学中生成想象轨迹,并用这些轨迹训练 actor-critic。DayDreamer 进一步检验这种训练方式能否提高真实机器人的在线学习效率。
Method
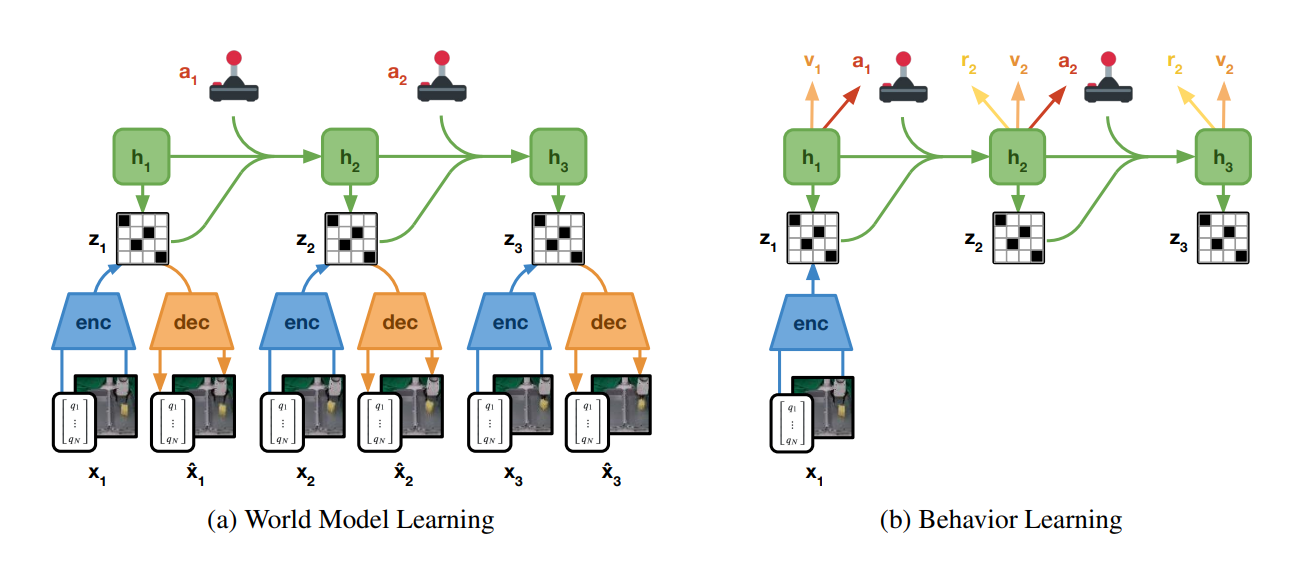
- 在真机上在线学世界模型:机器人边与真实世界交互边把经验存入 replay,同时持续训练 Dreamer 的世界模型(RSSM)与想象轨迹中的 actor-critic。实验不使用仿真;其中四足 A1 的自翻身、站立和行走训练无需人工 reset,这一条件不能直接外推到全部机器人任务。
- 从像素 + 稀疏奖励:机械臂任务直接从相机图像和稀疏奖励学,逼近人类表现;轮式机器人纯从相机导航并自动消解朝向歧义。
- 同一套超参:四个差异极大的机器人/任务共用 Dreamer 超参,说明范式的通用性。
Experiments
- 四足 A1:从零 1 小时学会翻正、站立、行走,无 reset;被推后 10 分钟内学会抵抗扰动或快速翻起。
- 两台机械臂:直接从相机 + 稀疏奖励学多物体抓放,接近人类水平。
- 轮式机器人:纯相机导航到目标点。
Strengths and Limitations
Strengths:论文在四类真实机器人上展示了无需仿真的在线学习;其中四足 A1 在约 1 小时内学习翻身、站立和行走且无需人工 reset,并在扰动后继续在线适应。两个机械臂与轮式机器人也使用同一组主要超参数,但“无 reset”不是全部实验的共同条件。原论文
局限(分析):真机在线学习对安全/损耗敏感(尤其无 reset 的探索阶段);奖励仍需人工设计(稀疏奖励也要能测量);任务复杂度与时长仍受限,离长时程灵巧操作尚远;继承 Dreamer 的像素重建负担。
Takeaways
DayDreamer 是「世界模型 = 省数据」这一主张在物理机器人上的直接证据,也是 Dreamer 从游戏走向真机的桥梁。它把「样本效率」从学术指标变成了「1 小时学会走」的工程事实。
TD-MPC
TD-MPC: Temporal Difference Learning for Model Predictive Control
一句话TD-MPC 结合学习到的任务导向潜动态模型(TOLD)和价值学习:在潜空间用采样式 MPPI 优化做短程轨迹规划,并用 TD 学到的终值函数估计规划视野之外的回报。它不重建像素,而是学习与任务决策相关的潜表示。
年份 / Venue ICML 2022 | 机构 UC San Diego | 方向 Latent MPC, model-based RL | 真机 仿真连续控制(后续 TD-MPC2 扩展)
BibTeX
@inproceedings{hansen2022tdmpc,
  title     = {Temporal Difference Learning for Model Predictive Control},
  author    = {Hansen, Nicklas and Wang, Xiaolong and Su, Hao},
  booktitle = {International Conference on Machine Learning (ICML)},
  year      = {2022},
  url       = {https://arxiv.org/abs/2203.04955}
}
Motivation
Model-based 有两大优势:模型学习带来样本效率、规划算力越多性能越好。但长时程规划昂贵、精确建模环境困难。TD-MPC 想两头取长:只在短视野里用模型规划(避开长程模型误差),视野之外用一个 TD 学的值函数兜底(避免长程 rollout)。关键洞见是——不必建一个能重建像素的通用世界模型,只需建一个「对当前任务的规划有用」的潜动态。
Method
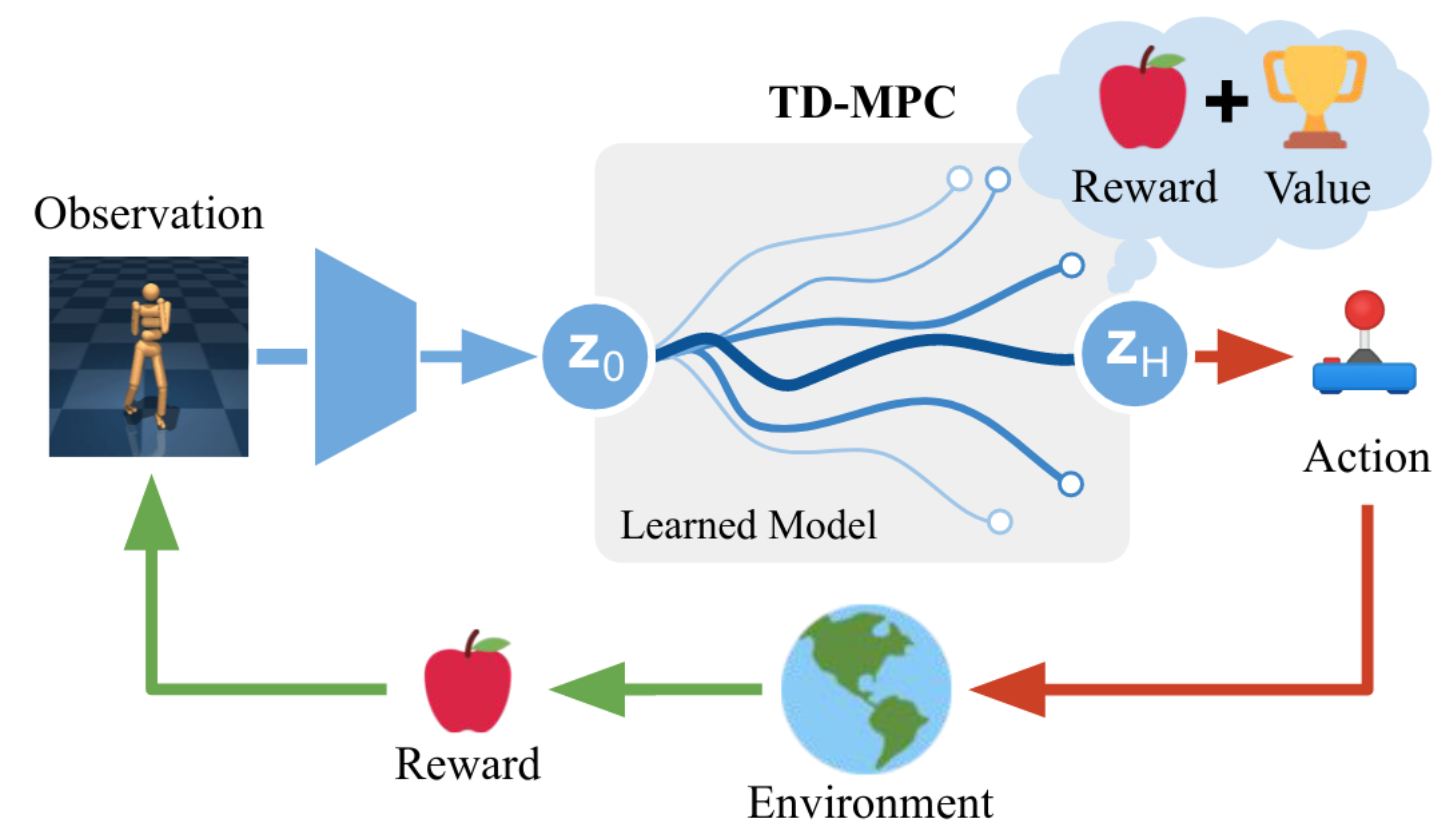
- TOLD(Task-Oriented Latent Dynamics)模型:编码器把观测映到潜表征 ,学习潜空间的转移与奖励预测;它不重建观测,只优化与任务/值相关的量 → 潜空间更紧凑、更抗无关细节。
- 潜空间规划:每步用论文采用的 MPPI 风格采样优化器,在潜空间对短视野 的动作序列进行评估和迭代。
- TD 终值:规划视野末端接一个学到的终值函数 (由 temporal difference 学习),把 步之外的长期回报估进来。模型、奖励、值联合由 TD 训练。
- 规划得到动作序列,执行第一个动作,下一步重规划(MPC 风格)。
Experiments
- 基准:DMControl 与 Meta-World 的状态与图像连续控制任务。
- 结论:在样本效率与渐近性能上均优于此前方法(含 model-free SAC 与仿真 MPC 基线),尤其在 Humanoid / Dog 等高维任务上优势明显。
- 后续:TD-MPC2(2024)把这套配方 scale 成单一大模型跨 104 个任务、多本体,是本方法的规模化延伸。
Strengths and Limitations
Strengths:任务导向潜空间免像素重建,紧凑高效、抗干扰;短程规划 + TD 终值兼顾局部精度与长期回报;样本效率与渐近性能双高;理念清晰、可 scale(TD-MPC2)。
局限(分析):TOLD 是任务专属表征,不像 Dreamer 那样能重建/可视化,跨任务复用弱(TD-MPC2 才补上多任务);每步 MPPI/CEM 规划有推理开销;依赖可测的稠密/半稠密奖励;纯仿真验证为主,真机需额外工程。
Takeaways
TD-MPC 把「世界模型」窄化为「对规划有用的潜动态」,并示范了 model-based(规划)与 model-free(TD 值)的高效缝合。它与 Dreamer 是同一目标的两种手法:Dreamer 在想象里学策略,TD-MPC 在潜空间里做规划。
RoboDreamer
RoboDreamer: Learning Compositional World Models for Robot Imagination
一句话把「文本→视频」世界模型做成组合式:用语言的天然组合性把指令拆成低层原语(动作短语 / 关系短语),对每个原语条件一个扩散模型再组合生成视频,从而泛化到训练时没见过的指令组合,还能加入目标图像等多模态目标。
年份 / Venue ICML 2024 | 机构 HKUST · MIT · UMass Amherst · Google(Yilun Du、Chuang Gan 等)| 方向 Compositional video world model | 评测范围 RT-X 真实机器人数据训练 + 论文规定的仿真/视频规划评测
BibTeX
@inproceedings{zhou2024robodreamer,
  title     = {{RoboDreamer}: Learning Compositional World Models for Robot Imagination},
  author    = {Zhou, Siyuan and Du, Yilun and Chen, Jiaben and Li, Yandong
               and Yeung, Dit-Yan and Gan, Chuang},
  booktitle = {International Conference on Machine Learning (ICML)},
  year      = {2024},
  url       = {https://arxiv.org/abs/2404.12377}
}
Motivation
文本条件视频模型可以生成候选未来观测,并与逆动力学模型组合成动作规划管线。已有方法在未见指令组合上容易退化;RoboDreamer 因此把语言指令分解成可组合原语,研究视频世界模型的组合泛化。
Method
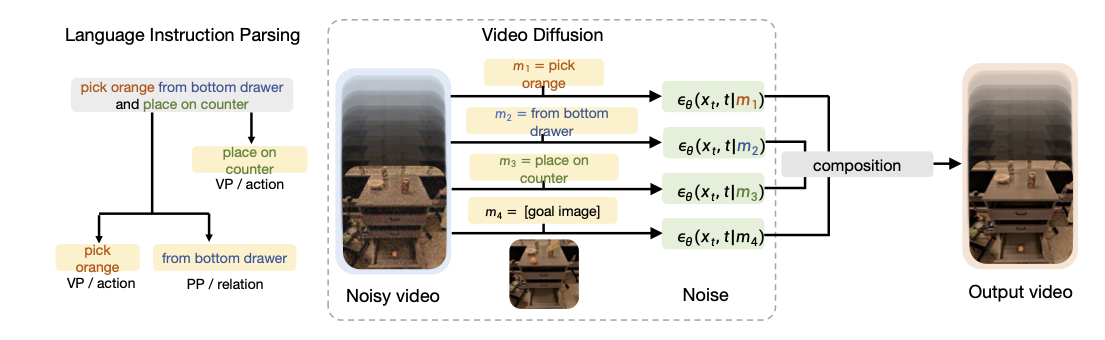
- 指令解析为原语:利用语言的组合性,把自然语言指令 parse 成一组低层组件——如动作短语(VP/action)与关系短语(PP/relation)。
- 组合式视频扩散:不训一个单体(monolithic)模型,而是让一组扩散模型分别条件在各原语上,在生成时组合它们的得分(score composition)→ 新指令只要能表示成「已见组件的组合」,就能生成对应视频。
- 多模态目标:这种因子化天然支持追加目标——例如同时给「语言指令 + 目标图像」来指定想生成的视频。
- 出动作:生成的未来视频计划再经逆动力学 / 动作模型转成机器人动作并在仿真执行(沿 UniPi 式「视频即计划」思路)。
Experiments
- 数据 / 设置:在 RT-X(RT-1 系)真机数据上训练,在未见目标/指令组合上合成视频计划并驱动仿真执行。
- 结论:能对未见组合成功合成视频计划,仿真执行成功,且显著优于单体视频生成基线。逐项数值未逐一核到,此处引用「组合泛化 + 优于 monolithic」这一头条。
Strengths and Limitations
Strengths:把组合泛化引入视频世界模型,直击「文本→视频」策略泛化窄的痛点;因子化天然支持多模态目标(语言 + 目标图像);建在真实机器人数据(RT-X)上。
局限(分析):依赖指令能被干净 parse 成原语,复杂/歧义语言可能失效;视频扩散生成慢、且要额外逆动力学才能出动作;仿真执行为主,真机闭环鲁棒性待验;生成保真度与物理一致性受扩散模型上限约束。
Takeaways
RoboDreamer 代表 world model 的另一支:用大规模视频生成当世界模型(与 UniPi/UniSim 同源),并用组合性换泛化。它与 Dreamer/TD-MPC 的潜空间路线互补——一个建像素级未来、一个建潜状态未来。
FOCUS
FOCUS: Object-Centric World Models for Robotics Manipulation
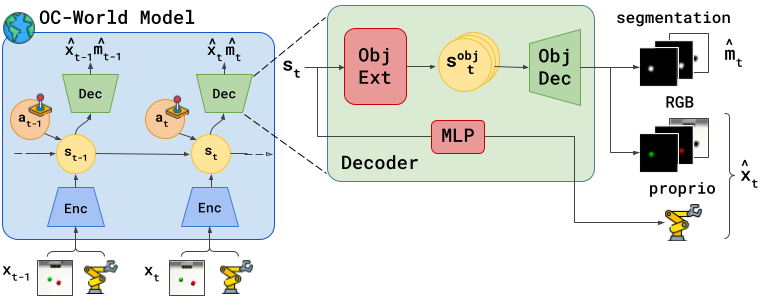
一句话把世界模型做成物体中心:在 Dreamer 式底座上显式建模「实体」,让潜状态解码出物体分割 / RGB / 本体;由物体中心表征导出一个探索奖励,鼓励智能体去探索「机器人-物体」交互,从而在操作任务上更高效。
年份 / Venue arXiv 2023(cs.RO)| 机构 Ghent University–imec · VUB(Ferraro、Mazzaglia、Verbelen、Dhoedt)| 方向 Object-centric world model, exploration | 真机 ✅ Franka Emika(真实场景展示)
BibTeX
@article{ferraro2023focus,
  title   = {{FOCUS}: Object-Centric World Models for Robotics Manipulation},
  author  = {Ferraro, Stefano and Mazzaglia, Pietro and Verbelen, Tim and Dhoedt, Bart},
  journal = {arXiv preprint arXiv:2307.02427},
  year    = {2023},
  url     = {https://arxiv.org/abs/2307.02427}
}
Motivation
机器人操作需要区分场景中的对象及其交互。Dreamer 的 RSSM 使用确定性递归状态与随机潜状态共同表示整体观测,并不显式分配对象槽;这种全局表示不保证各对象可独立寻址。FOCUS 因此研究显式对象中心表示是否能改善对象预测与探索。
Method
- 物体中心世界模型(OC-World Model):在 Dreamer(V2) 式 RSSM 底座上,让潜状态 通过一个物体中心解码器产出物体分割 、RGB 与本体(proprio)——即模型被要求把场景按物体重建,从而在表征里保留实体结构。
- 物体中心探索奖励:从物体中心表征里导出一个探索 bonus,鼓励智能体主动去接触/操作物体、探索机器人-物体交互(而非在与物体无关的状态里瞎逛)。
- 用于操作:更结构化的世界模型 + 更有的放矢的探索,使其在多种操作设置下更高效地解任务;并在 Franka 上做真实世界展示。
Experiments
- 设置:不同 setting 的操作任务(仿真
/stack/faucet/banana 等 + 真机)。 - 结果:论文在其仿真和真机设置中报告,对象中心表示相对 DreamerV2 基线改善了对象重建、预测以及面向对象交互的探索效率。本文不跨任务汇总未在同一指标下报告的数字。
Strengths and Limitations
Strengths:把结构化(物体中心)先验注入世界模型,契合操作任务的本质;物体中心探索奖励直接解决「探索物体交互」这一操作难点;真机可用性展示。
局限(分析):依赖物体分割/发现的质量,杂乱、遮挡、无清晰物体边界的场景会退化;物体中心解码增加建模复杂度;评测规模相对小,离大规模通用操作尚远;仍是生成式(要重建分割/RGB)。
Takeaways
FOCUS 代表 world model 的「结构化」支线:不追求一个更大的单体模型,而是给世界模型注入物体这一归纳偏置。它和 Dreamer 的关系,类似 CoPa/ReKep 之于端到端 policy——都在问「显式结构能否让世界模型更省样本、更好探索」。
JEPA
I-JEPA: Self-Supervised Learning from Images with a Joint-Embedding Predictive Architecture
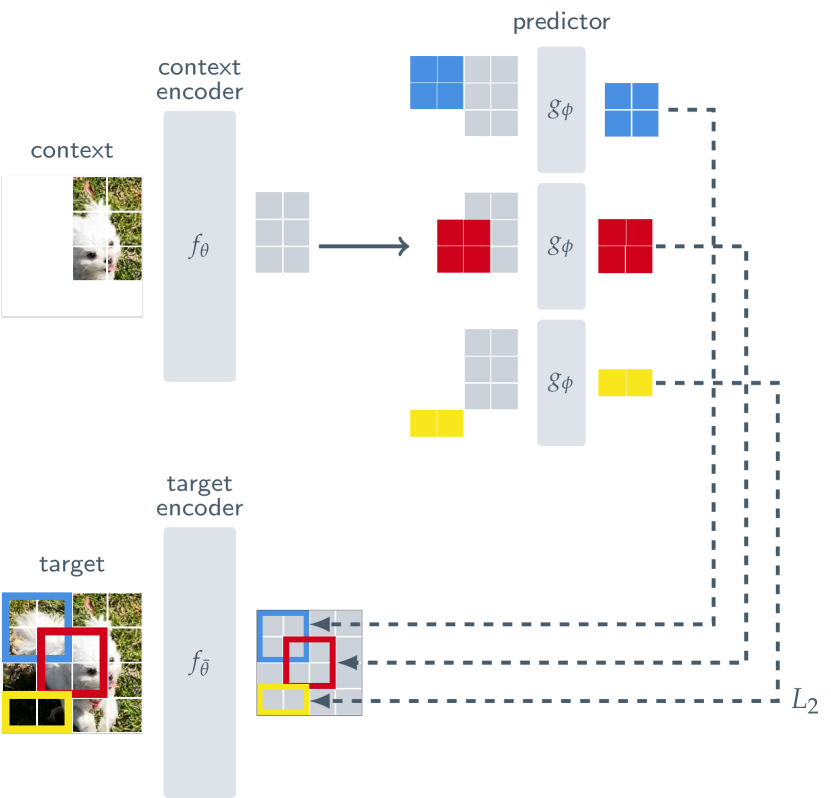
一句话LeCun 力推的非生成式世界模型雏形:从一个 context 块去预测同图多个 target 块的表征(而非像素);用 context/target 编码器 + predictor,靠合适的掩码策略学到高语义表征,不重建像素、不用手工数据增强。
年份 / Venue ICCV 2023 | 机构 Meta AI (FAIR) · McGill · Mila (Assran、LeCun、Ballas 等) | 方向 Non-generative self-supervised image representation learning | 控制用途 无;这是静态图像表征预训练方法
BibTeX
@inproceedings{assran2023ijepa,
  title     = {Self-Supervised Learning from Images with a Joint-Embedding Predictive Architecture},
  author    = {Assran, Mahmoud and Duval, Quentin and Misra, Ishan and Bojanowski, Piotr
               and Vincent, Pascal and Rabbat, Michael and LeCun, Yann and Ballas, Nicolas},
  booktitle = {IEEE/CVF International Conference on Computer Vision (ICCV)},
  year      = {2023},
  url       = {https://arxiv.org/abs/2301.08243}
}
Motivation
I-JEPA 的研究动机是:像素重建会把建模能力分配给许多下游任务并不关心的细节,而对比学习常依赖较强的数据增强。它改为在表征空间预测被遮挡区域,并通过目标块尺度和上下文采样策略引导模型学习语义特征。这是论文提出并由下游实验支持的设计选择,不意味着像素重建在所有任务中都“浪费算力”。
Method
- 三件套:context 编码器 、target 编码器 (context 编码器的 EMA,不回传梯度)、predictor 。
- 任务:从一个 context 块的表征出发,predictor 去预测同图多个 target 块的表征;损失是预测表征与 target 编码器输出表征之间的 L2(在表征空间,不在像素空间)。
- 掩码策略(关键)
块要足够大(语义级)、context 要空间分布充分(信息量足)——否则会退化成学低层特征。 - 非生成、非对比:靠 target 编码器 EMA + 表征预测避免坍缩,不需负样本、不需增强。
Experiments
- 效率
/14 在 ImageNet 上用 16 张 A100、<72 小时训练即得强下游表现。 - 表现:线性探针分类强,且在低样本(1%)、物体计数、深度预测等多类任务上迁移好;相比生成式/对比式更语义、更省算力。逐项精度未逐一核到,引用「ViT-H/14、16×A100<72h、强线性探针」这一头条。
Strengths and Limitations
Strengths:非生成——不重建像素,算力花在语义上;免手工增强(比对比学习更少归纳偏置);可扩展、语义强;是「表征空间世界模型」的关键实证。
局限(分析):掩码策略敏感,需精心设计 target/context 尺度;学到的是表征,本身不是控制策略(要下游接头);表征无法直接可视化/重建,可解释性弱;单图内预测,未涉及时间/动力学(V-JEPA 才补上)。
Takeaways
I-JEPA 在静态图像上验证了表征空间预测可以获得有竞争力的下游表示,并展示了较好的训练扩展性。它不建模动作或时间动力学,因此本身不是机器人控制意义上的 world model;V-JEPA 才把该目标扩展到视频时序。原论文
V-JEPA
V-JEPA: Revisiting Feature Prediction for Learning Visual Representations from Video
一句话把 JEPA 搬到视频:掩掉时空区域,只预测其表征(特征预测)作为唯一自监督目标——不重建像素、不用文本、不用负样本、不用预训练图像编码器;学到既懂运动又懂外观的通用表征,冻结骨干即强。
年份 / Venue arXiv 2024 | 机构 Meta AI (FAIR) (Bardes、LeCun、Assran、Ballas 等) | 方向 Non-generative video SSL (JEPA) | 真机 V-JEPA 2(2025)扩展为机器人规划世界模型
BibTeX
@article{bardes2024vjepa,
  title   = {Revisiting Feature Prediction for Learning Visual Representations from Video},
  author  = {Bardes, Adrien and Garrido, Quentin and Ponce, Jean and Chen, Xinlei
             and Rabbat, Michael and LeCun, Yann and Assran, Mahmoud and Ballas, Nicolas},
  journal = {arXiv preprint arXiv:2404.08471},
  year    = {2024},
  url     = {https://arxiv.org/abs/2404.08471}
}
Motivation
I-JEPA 在静态图像上展示了表征空间预测的可行性;V-JEPA 将目标扩展到视频,研究仅使用 feature prediction、而不依赖像素重建、文本或负样本时,能否学习可迁移的视频表征。时间建模对控制类世界模型很重要,但是否必须显式建模时间取决于“world model”的具体定义和用途。
Method
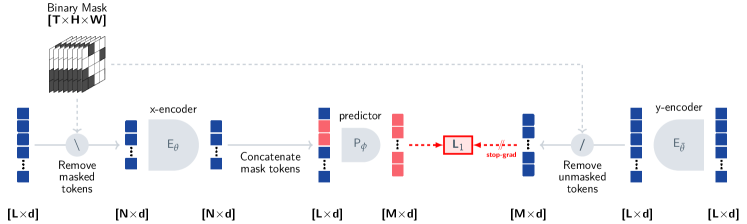
- 纯特征预测目标:把视频切成时空 token,掩掉一部分时空区域;x-encoder 编码可见部分,predictor 预测被掩区域的表征,与 y-encoder(处理完整/被掩目标、提供目标表征)输出对齐,损失为表征空间的 L1,并对目标侧 stop-grad(防坍缩)。
- 五不用:不用预训练图像编码器、不用文本、不用负样本、不用像素重建、不用其他监督——只有特征预测。
- 数据/规模:在 200 万条公开视频上训练;评测用冻结骨干(frozen evaluation),不微调参数。
Experiments
- 冻结评测(官方,已核到):最大模型 ViT-H/16 仅用视频训练即达 Kinetics-400 81.9% / Something-Something-v2 72.2% / ImageNet-1K 77.9%——运动类与外观类任务兼强,且无需为下游调参。
- 结论:特征预测本身足以学到通用视觉表征;相比像素重建式方法更高效。
Strengths and Limitations
Strengths:V-JEPA 将 JEPA 目标扩展到视频,在不使用像素重建、文本监督或负样本的设置下训练,并在冻结编码器评测中取得有竞争力的动作与图像任务结果。这支持 feature prediction 作为视频自监督目标的有效性,但不意味着它在所有任务上优于生成式目标。原论文
局限(分析):仍是表征学习,本体不是策略/规划器(要接下游);冻结评测虽说明表征质量,但动作/控制上的用处需 V-JEPA 2 等后续验证;时空掩码与 predictor 设计影响大;对精细像素级任务(需重建)非其所长。
Takeaways
V-JEPA 把非生成世界模型从图像推到视频,坐实了 LeCun 路线「在表征空间预测动态世界」。其后 V-JEPA 2(2025) 进一步把这套表征用作机器人规划的世界模型,直接把这条线接回了本篇开头的控制问题——非生成 world model 正式进入机器人操作。
Cross-Paper Comparison
| 论文 | 路线 | 世界模型建在哪 | 预测目标 | 怎么产生行为 | 局限(分析) |
|---|---|---|---|---|---|
| Dreamer | 生成式 | RSSM 潜空间(+像素重建) | 未来潜状态/奖励 | 想象里学 actor-critic | 像素重建负担、长程漂移 |
| DayDreamer | 生成式 | 同 Dreamer(真机在线) | 同上 | 同上 | 真机安全/损耗、任务尚短 |
| TD-MPC | 生成式(任务导向) | 任务导向潜动态 TOLD | 潜动态+奖励+终值 | 潜空间 MPC 规划 | 表征任务专属、规划开销 |
| RoboDreamer | 生成式(视频) | 组合式视频扩散 | 未来视频 | 视频→逆动力学 | 生成慢、依赖指令可解析 |
| FOCUS | 生成式(物体中心) | 物体中心 RSSM | 物体分割/RGB/本体 | 物体中心探索+规划 | 依赖物体发现、评测规模小 |
| JEPA | 非生成 | 图像表征空间 | target 块表征 | 表征预训练(接下游) | 非策略、掩码敏感 |
| V-JEPA | 非生成(视频) | 视频表征空间 | 时空块表征 | 表征预训练(V-JEPA 2 规划) | 非策略、控制用处待验 |
Discussion
把七篇放一起,world model 的版图大致沿两个轴展开:
-
在什么抽象层级预测世界? 这是最本质的分歧。
- 像素/观测层
、DayDreamer、FOCUS(重建 RGB/分割)、RoboDreamer(生成视频)——好处是可视化、信息完整,坏处是算力花在与控制无关的细节上、长程易漂移。 - 任务导向潜层
只建「对规划有用」的潜动态,砍掉重建。 - 纯表征层
/V-JEPA 彻底不重建,只在表征空间预测——LeCun 的赌注是「可预测结构在表征里」。这条线最省算力、最语义,但离「产生动作」最远,需要下游接头。
- 像素/观测层
-
世界模型怎么变成动作?
- 想象里学策略(Dreamer/DayDreamer):在潜 rollout 里跑 actor-critic。
- 潜空间里做规划(TD-MPC)
+ TD 终值。 - 生成计划再解动作(RoboDreamer):视频即计划 + 逆动力学。
- 先学表征再接控制(JEPA/V-JEPA→V-JEPA 2):表征预训练,下游再规划/控制。
-
结构化 vs 规模化。FOCUS(物体中心)、RoboDreamer(组合式)代表「注入结构先验」的支线,和 Dreamer/V-JEPA「堆规模 + 通用架构」形成张力——这与 Robot Learning (3) 里 CoPa/ReKep 给 policy 注入几何结构的思路一脉相承。
-
与 VLA/端到端策略的关系。 Robot Learning (2) 的 π0 系列直接学习观测到动作的条件分布;world model 额外学习环境动态或未来表示。V-JEPA 2、RoboDreamer 和 Dreamer 系分别展示了表征预测、视频生成和潜在想象如何参与规划或策略训练。是否在统一模型中同时保留世界预测与动作输出,以及在哪个抽象层级预测,仍需要任务级实验比较。