
Overview
世界动作模型(World Action Model, WAM)是 2026 年上半年集中爆发的一条新范式。和 VLA(Vision-Language-Action,直接学「观测→动作」的前馈映射)不同,WAM 多学一层「世界会怎样」:它把动作生成与未来世界状态(通常是视频/像素)预测放进同一个模型里联合建模,并且几乎都建在预训练的视频生成模型骨干上——借视频扩散模型学到的时空、物理先验,让预测出的动作更符合物理、也更能泛化到没见过的场景与运动。
一句话对照:
VLA:观测(+语言)→ 动作。一个网络把「看懂 + 懂物理 + 会控制」全压进单一表征。
WAM:观测(+语言)→ 未来世界(视频)+ 动作。用「想象未来画面」当稠密监督,把动力学建模和动作控制解耦又协同。
这带来一个新的核心问题:既然要同时生成视频,推理就变贵了。于是本篇八篇的看点,就落在三条轴上:
① 视频与动作怎么耦合? latent frames(Cosmos-Policy)/双流 MoT(LingBot-VA)/三流 UniDiffuser(MotuBrain)/双分支(GigaWorld-Policy)/物体槽(OA-WAM)/表征 tokenizer(RepWAM)/交错自回归。
② 昂贵的视频生成怎么在推理时省掉? 因果设计让推理丢掉视频分支(GigaWorld / MotuBrain 的 V2A)、异步流水线(LingBot-VA)、半量去噪 + KV cache、step reduction / FP8 / DiT caching(MotuBrain)。
③ 靠结构先验还是靠规模? 对象可寻址(OA-WAM)、历史记忆库(DiM-WAM)、表征 tokenizer(RepWAM)注入结构;DreamZero(14B)、Cosmos-Policy 则赌通用视频骨干 + 规模。
证据等级说明(核查于 2026-09-11):本篇八项工作均为 2026 年 arXiv 预印本或公司项目。下述数字均应视为作者在指定 benchmark、硬件和数据设置中的报告,不能替代同行评审或独立复现;代码状态与项目页内容也可能继续变化。
八篇工作的定位:
- Cosmos-Policy — 最干净的范式陈述:把预训练视频模型 Cosmos-Predict2 单阶段微调成策略,动作/未来状态/价值全编码成 latent frames,还能测试时规划。
- DreamZero — 将 14B 自回归视频扩散骨干作为 zero-shot 策略,并在作者定义的新任务/新环境评测中报告跨本体迁移结果。
- LingBot-VA — 因果世界建模:自回归生成、逆动力学与异步闭环,重点改善 chunk 式生成中的反馈时效、历史信息利用和因果一致性。
- GigaWorld-Policy — 以动作为中心:双分支训练、推理丢视频分支,效率优先。
- MotuBrain — 用三流 MoT + UniDiffuser 在同一架构中承担 policy、world modeling、video generation 与 inverse dynamics 等任务,并报告针对特定部署配置的加速结果。
- RepWAM — 表征型视觉-动作 tokenizer:不再只做像素重建,在语义 latent 空间里建「未来视觉 + 隐式动作」。
- OA-WAM — 对象可寻址:把世界拆成物体槽(address + content),指令能精确「寻址」到目标物体,抗场景扰动。
- DiM-WAM — 历史事件记忆库:多尺度记忆缓解长时程操作里的「遗忘」。
一条主线:WAM 的核心分歧不是「要不要世界模型」,而是「视频与动作在哪层、以何种结构耦合,以及怎么把昂贵的视频生成在推理时省掉」。
Paper List
| 简称 | 年份 / arXiv | 机构 | 视频×动作怎么耦合 | 推理效率手段 | 核心思想 |
|---|---|---|---|---|---|
| Cosmos-Policy | 2026 / 2601.16163 | NVIDIA | 动作/状态/价值→latent frames | 单阶段后训练、测试时规划 | 视频模型零改架构微调成策略 |
| DreamZero | 2026 / 2602.15922 | NVIDIA | 14B 自回归视频扩散联合建模 | 系统优化达 7Hz 闭环 | WAM 即 zero-shot 策略、跨本体迁移 |
| LingBot-VA | 2026 / 2601.21998 | 蚂蚁 Robbyant | 双流 MoT + 视频-动作交错自回归 | 异步推理 + 半量去噪 + KV cache | 因果世界建模、逆动力学出动作 |
| GigaWorld-Policy | 2026 / 2603.17240 | GigaAI | 双分支(动作 + 未来视频)互监督 | 因果设计→推理丢视频分支 | 以动作为中心、效率优先 |
| MotuBrain | 2026 / 2604.27792 | 生数科技 | 三流 MoT(UniDiffuser) | 作者报告 50×+ 加速、FP8/caching/V2A | 统一多任务 WAM |
| RepWAM | 2026 / 2606.13674 | 复旦·蚂蚁·港科大 | 表征视觉-动作 tokenizer + Causal WAM | — | 语义 latent 里建隐式动作 |
| OA-WAM | 2026 / 2605.06481 | 见论文作者信息 | 物体槽(address+content) | flow-matching 动作头、单前向 | 对象可寻址、抗场景扰动 |
| DiM-WAM | 2026 / 2606.27677 | 中科院自动化所 | 记忆库 + 视频/动作联合建模 | — | 多尺度历史记忆解长时程遗忘 |
Cosmos-Policy
Cosmos Policy: Fine-Tuning Video Models for Visuomotor Control and Planning
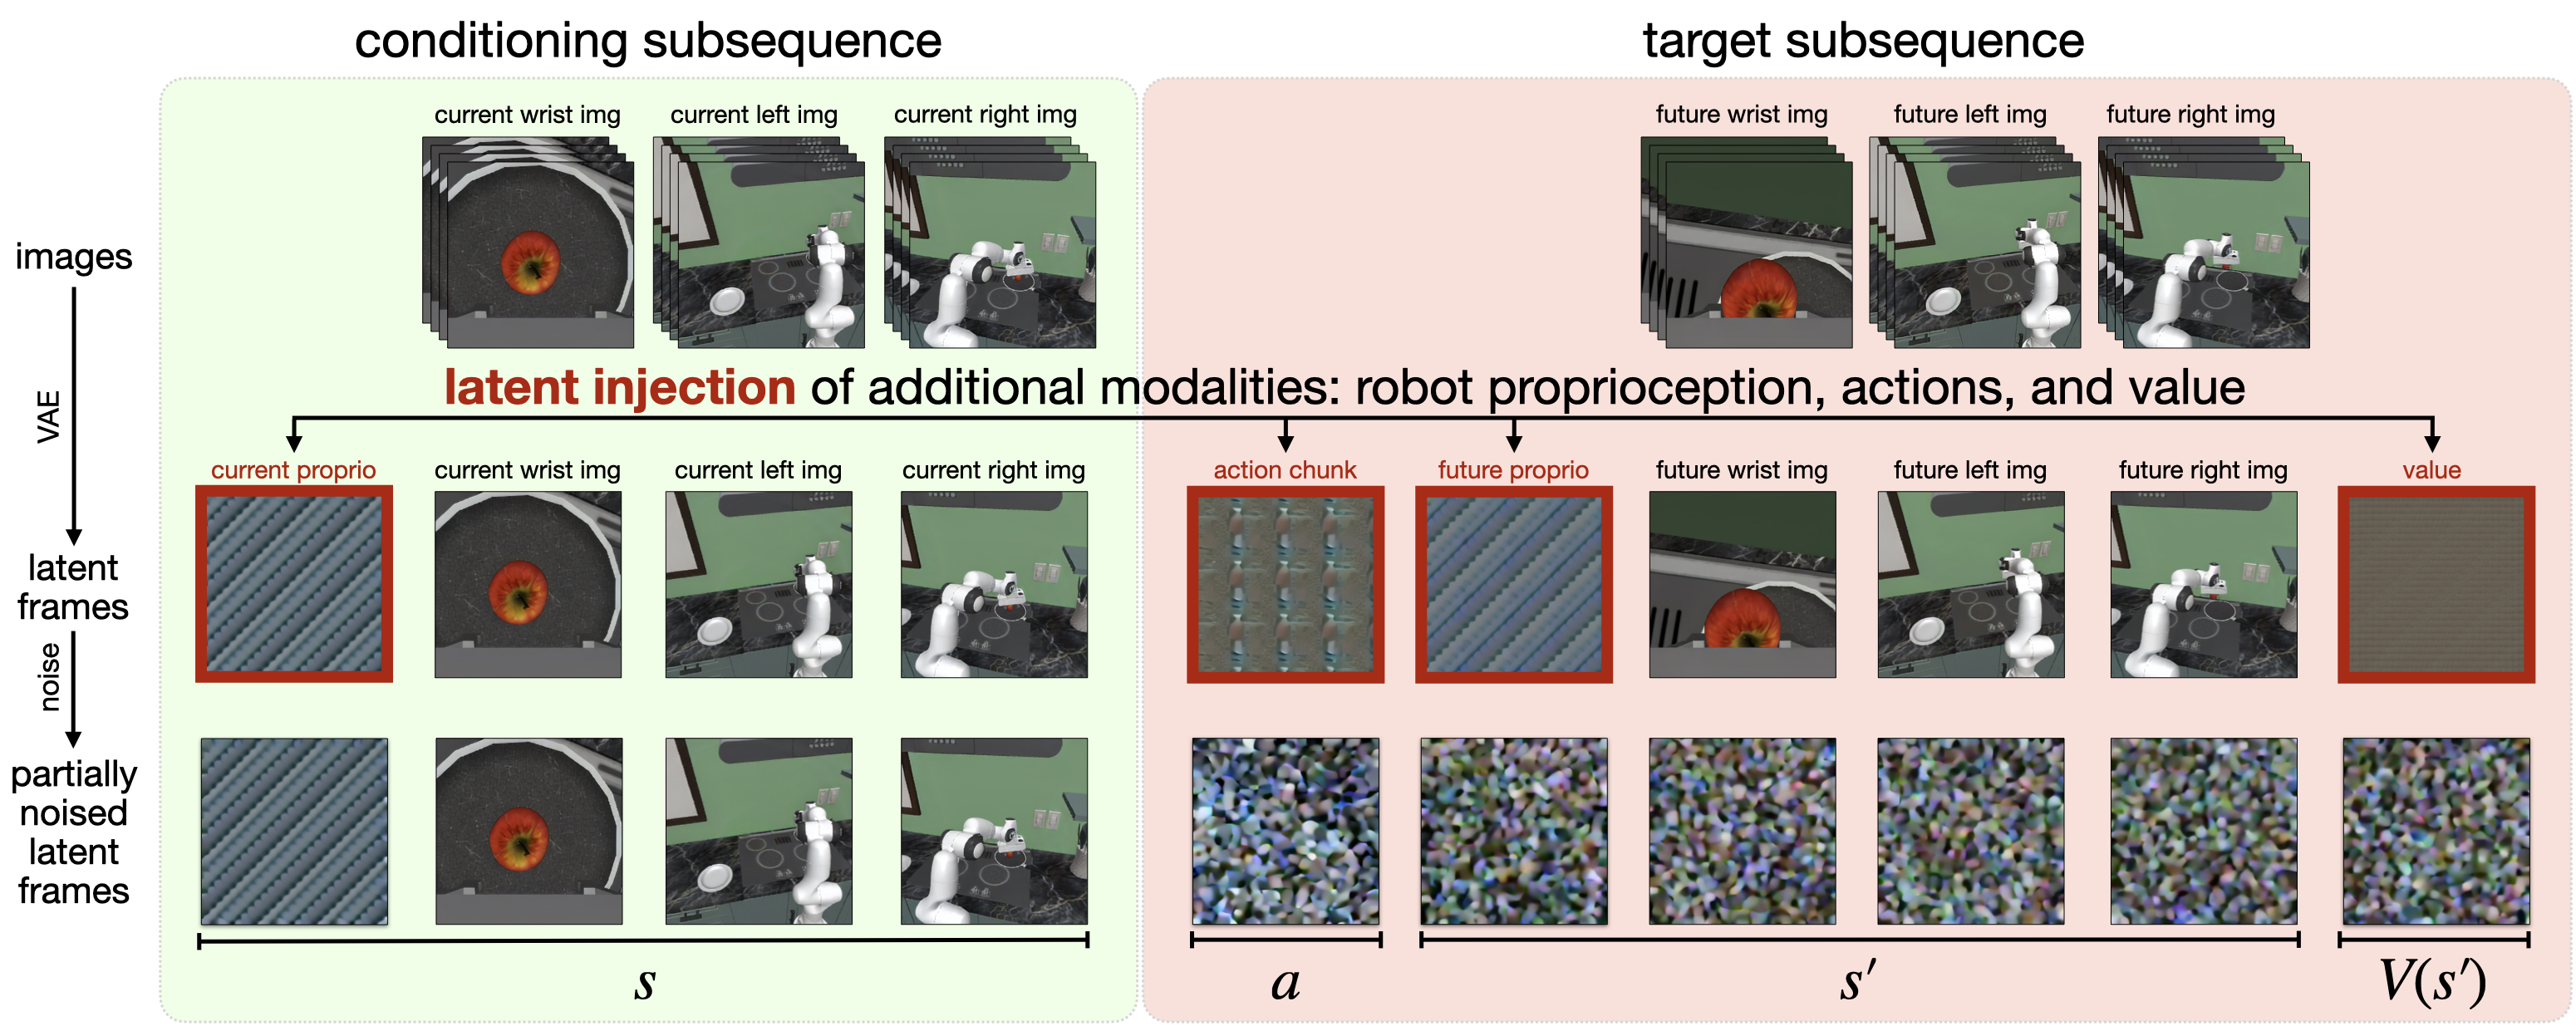
一句话把大型预训练视频模型(Cosmos-Predict2)零架构改动、单阶段后训练就变成机器人策略:把动作、未来状态图像、价值(预期累计奖励)统统编码成视频模型潜在扩散过程里的 latent frames,从而在同一个原生扩散算法里既生成动作、又能做测试时规划。
年份 / Venue arXiv 2026(2601.16163)| 机构 NVIDIA(NVlabs · Cosmos Lab)| 方向 Video-model-as-policy, WAM | 真机 ✅ 双臂 ALOHA 操作
BibTeX
@article{kim2026cosmospolicy,
  title   = {Cosmos Policy: Fine-Tuning Video Models for Visuomotor Control and Planning},
  author  = {Kim, Moo Jin and Gao, Yihuai and Lin, Tsung-Yi and Lin, Yen-Chen
             and Ge, Yunhao and Lam, Grace and Liang, Percy and Song, Shuran
             and Liu, Ming-Yu and Finn, Chelsea and Gu, Jinwei},
  journal = {arXiv preprint arXiv:2601.16163},
  year    = {2026},
  url     = {https://arxiv.org/abs/2601.16163}
}
Motivation
视频生成模型有很强的时空/物理先验,是天然的「世界模型」。但此前把视频模型用于策略学习,往往要多阶段后训练 + 新增动作生成的架构组件,复杂且难复现。Cosmos-Policy 想用最简单的方式回答:能不能单阶段、零架构改动就把一个视频模型变成有效策略?
Method
- 视频骨干直接微调:以预训练视频模型 Cosmos-Predict2 为基座,只用目标平台采集的机器人示范做单阶段后训练,不改架构。
- 一切皆 latent frame:把机器人动作编码为视频模型潜在扩散里的 latent frames,直接用其原生扩散学习算法生成,以刻画复杂动作分布;未来状态图像与**价值(expected cumulative rewards)**也同样以 latent frames 编码。
- 测试时规划:利用生成的未来状态 + 价值对候选动作轨迹打分,选更可能成功的轨迹(test-time planning)。
- 从经验精炼:给定 policy rollout 数据后,可进一步精炼其世界模型与价值函数,再借基于模型的规划提升成功率。
Experiments
- LIBERO:作者按论文定义汇总四个 task suite,报告平均成功率 98.5%;“SOTA”仅指论文发布时列出的基线与相同评测协议。
- RoboCasa:平均成功率 67.1%,且项目页称所需示范显著更少(50 demos vs 300)。
- 真机双臂(ALOHA):平均分最高,优于从零训练的 diffusion policy、其他视频模型策略,以及在相同示范上微调的 SOTA VLA。
- 基于经验精炼世界模型/价值 + 模型规划可在困难任务上进一步提升,具体增量原文未给精确值。
Strengths and Limitations
Strengths:把「视频模型→策略」简化到单阶段、零改架构,工程门槛低;latent frames 统一表示动作/状态/价值,天然支持规划;开源(Apache-2.0)+ HF 模型。
局限(分析):仍要跑视频扩散,推理成本高于纯 VLA;测试时规划带来额外开销;数据仍需目标平台示范;latent-frame 动作表示的精度上限受视频 tokenizer 约束。
Takeaways
Cosmos-Policy 给出了 WAM 最简洁的一版陈述:别为动作单独造轮子,把动作也塞进视频模型的扩散过程。它和 DreamZero 同出 NVIDIA、同赌「视频骨干 = 世界模型」,是本篇「范式奠基」的两块基石。
DreamZero
World Action Models are Zero-shot Policies(DreamZero)
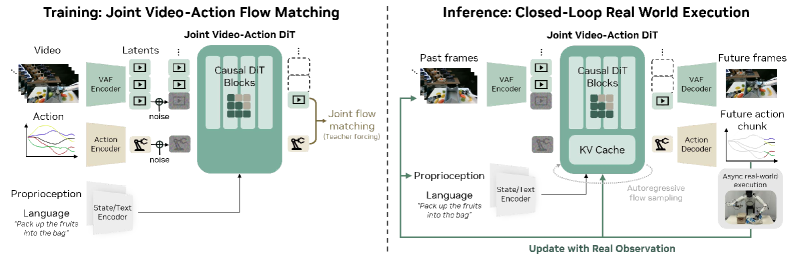
一句话把「WAM」直接当zero-shot 策略:在预训练视频扩散骨干上建一个 14B 自回归世界动作模型,通过同时预测未来世界状态(视频)+ 动作学物理动力学;靠模型/系统协同优化让 14B 模型跑到 7Hz 实时闭环,并能用其他机器人甚至人类的「仅视频」示范做跨本体迁移。
年份 / Venue arXiv preprint, 2026(2602.15922)| 机构 NVIDIA(Yuke Zhu · Jim Fan · Joel Jang 等)| 方向 Video-diffusion WAM, zero-shot generalization | 真机 ✅ 作者在指定泛化设置中报告 >2× 相对提升
BibTeX
@article{ye2026dreamzero,
  title   = {World Action Models are Zero-shot Policies},
  author  = {Ye, Seonghyeon and Ge, Yunhao and Zheng, Kaiyuan and Gao, Shenyuan
             and Jang, Joel and Fan, Linxi and Zhu, Yuke and others},
  journal = {arXiv preprint arXiv:2602.15922},
  year    = {2026},
  url     = {https://arxiv.org/abs/2602.15922}
}
Motivation
当前 SOTA 的 VLA 擅长语义泛化,却难泛化到新环境里没见过的物理运动/动作,且依赖大量重复示范。DreamZero 想用视频当稠密监督信号——视频天然记录了「世界如何演化」——从异构机器人数据里高效学多样技能,并把泛化能力推到 zero-shot。
Method
- 视频扩散骨干 + 14B 自回归 WAM:在预训练视频扩散模型上构建世界动作模型。
- 联合建模视频 + 动作:通过预测未来世界状态与动作学习物理动力学,把视频当「世界怎么演化」的稠密表征。
- 异构数据学习:从多来源机器人数据学,不依赖重复示范。
- 实时闭环:模型 + 系统优化让 14B 自回归视频扩散做到 7Hz 闭环控制。
- 跨本体迁移:用其他机器人/人类的仅视频示范迁移,并支持少样本本体适配。
Experiments
- 实机泛化:作者在论文定义的新任务/新环境集合上,相对所选 VLA 基线报告 >2× 提升;该倍率不代表所有机器人任务。
- 跨本体:仅 10–20 分钟「其他机器人/人类视频」数据,未见任务上相对提升 >42%。
- 少样本适配:仅 30 分钟 play data 即可迁移到新本体,同时保留 zero-shot 泛化。
- 效率:14B 模型 7Hz 实时闭环。
- 项目页另给出更细的进度分数(如 seen 62.2% / 27.4%、unseen 39.5%),但未在 arXiv 摘要逐字核到,本篇不作精确引用。
Strengths and Limitations
Strengths:论文把 WAM 直接作为 zero-shot 策略,并研究仅视频/人类示范对跨本体迁移的帮助;作者还在指定硬件与系统配置下报告 14B 模型约 7 Hz 的闭环速度。结果说明该方向具备可行性,但数据成本与部署能力仍需在更多本体、硬件和长时间运行中验证。
局限(分析):14B 骨干训练/部署成本高(需系统级优化才实时);泛化幅度为作者自报头条,逐任务表需回原文;仍依赖视频骨干质量;开放世界长时程仍待验证。
Takeaways
DreamZero 展示了将视频扩散骨干直接用于 zero-shot 策略和跨本体迁移的一种实现;Cosmos-Policy 则把视频、动作和价值建模结合起来。两项工作都支持继续研究视频预训练对机器人策略的贡献,但尚不能证明大视频模型本身就是充分的世界模型。
LingBot-VA
Causal World Modeling for Robot Control(LingBot-VA)
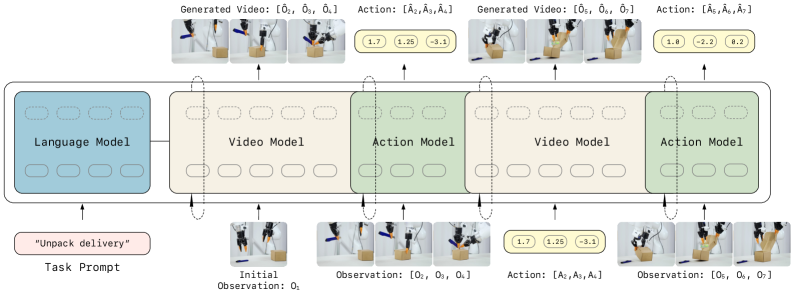
一句话该方法用自回归扩散统一视频世界模型与动作策略:视频流(初始化自 Wan2.2-5B)和动作流采用并行的 Mixture-of-Transformers,通过视频—动作交错序列和因果掩码完成统一的 next-token 预测;模型生成未来视觉状态,再由逆动力学预测动作,并结合异步推理与 FDM grounding 及时吸收真实反馈。其设计目标是改善 chunk 式生成中的反馈时效、历史信息利用和因果一致性。
年份 / Venue arXiv 2026(2601.21998)| 机构 Ant Group(蚂蚁集团 · Robbyant)| 方向 Autoregressive causal WAM | 真机 ✅ 6 任务(每任务仅 50 条演示)
BibTeX
@article{li2026lingbotva,
  title   = {Causal World Modeling for Robot Control},
  author  = {Li, Lin and Zhang, Qihang and Luo, Yiming and Yang, Shuai
             and Wang, Ruilin and Han, Fei and Yu, Mingrui and Gao, Zelin
             and Xue, Nan and Zhu, Xing and Shen, Yujun and Xu, Yinghao},
  journal = {arXiv preprint arXiv:2601.21998},
  year    = {2026},
  url     = {https://arxiv.org/abs/2601.21998}
}
Motivation
现有 VLA 前馈式存在表征纠缠——一个网络同时学视觉理解、物理动力学、运动控制,压进单一表征导致样本效率低、泛化差。而已有的 chunk 式视频-动作扩散(如 UVA、UWM)有三个问题:① reactivity gap(整段开环生成、缺实时反馈,难应对扰动);② 长时记忆有限(段级生成引入长程不一致);③ 因果性问题(段内双向注意力让未来影响过去,违背物理因果)。LingBot-VA 主张用自回归形式做鲁棒闭环。
Method
- 共享隐空间 + MoT:视频流(初始化自 Wan2.2-5B,dim 3072)与动作流(同深度、dim 768)双 backbone 并行,各自 QKV,再跨模态注意力融合;动作 token 投到视频维参与联合自注意力后残差投回,避免模态互扰。
- 视频-动作交错 + 因果自回归:视频按 τ=4 时间下采样,动作高频插入(1 段 K 帧对应 τK 个动作),因果掩码统一 next-token 预测。
- 逆动力学出动作:世界模型先预测未来视觉状态,逆动力学再基于「期望未来观测 + 观测/动作历史」推出动作——即「什么动作能得到期望画面」。
- 闭环 rollout + 噪声历史增强:训练对历史视频加噪;推理时视频只需去噪到 s=0.5(动作到 s=1.0),半量去噪加速。
- 实时异步推理 + FDM grounding:KV cache 加速自回归;异步流水线让「预测」与「电机执行」并行;引入 Forward Dynamics Model 用最新真实反馈重新对齐,避免朴素异步的开环漂移。
- 规模:约 5.3B 参数;预训练约 16K 小时 / 1.4T tokens(Agibot、RoboMind、OXE 子集、UMI 等);统一 30 维双臂动作。
Experiments
- RoboTwin 2.0(50 任务):平均 Easy 92.93 / Hard 91.55,超第二名 Motus(88.7/87.0)与 π0.5(82.7/76.8);长时任务增益更大(作者自报)。
- LIBERO:平均成功率 98.5%(Object 99.6% / Long 98.5% / Spatial 98.5%)。
- 真机(6 任务,每任务 50 条演示):progress 与 success 两项均超 π0.5。
- 消融:异步比同步推理**快 2×**且成功率相当;预训练 LingBot-VA(92.9)显著优于直接微调 WAN(80.6);时序记忆任务 100% vs π0.5 的 47%/50%。
Strengths and Limitations
Strengths:自回归 + 因果直击 chunk 式生成的 reactivity/记忆/因果三洞;逆动力学把「想象画面」干净地转成动作;异步 + FDM 让大视频模型实时闭环还抗漂移;大规模预训练数据配方公开。
局限(分析):约 5.3B + 视频骨干,部署仍重;异步/FDM 工程复杂;论文正文主体未见明确 Limitations 章节(附录未逐页核);30 维双臂表征迁移到其他本体需适配。
Takeaways
LingBot-VA 代表 WAM 的「闭环鲁棒」支线:不满足于「能生成对的视频」,而是把 reactivity、长时记忆、物理因果三件事一次性用因果自回归 + 异步执行补齐。它与 GigaWorld/MotuBrain 一起,把 WAM 从「离线能想象」推向「在线能干活」。
GigaWorld-Policy
GigaWorld-Policy: An Efficient Action-Centered World–Action Model
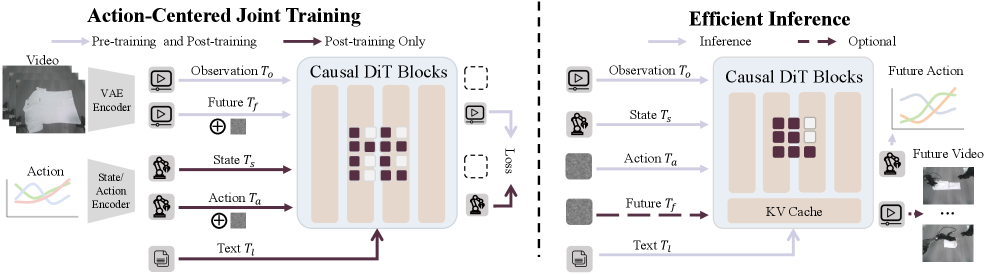
一句话一个以动作为中心的世界-动作模型:从预训练视频生成骨干初始化,训练时把策略拆成两个耦合分支——预测未来动作 + 以「动作 + 观测」为条件生成未来视频,二者互相监督;靠因果设计保证视频 token 不影响动作 token,于是推理时可直接丢掉视频生成分支,只跑轻量动作分支高效解码。
年份 / Venue arXiv 2026(2603.17240)| 机构 GigaAI | 方向 Efficient action-centered WAM | 真机 ✅ 真实机器人平台
BibTeX
@article{ye2026gigaworldpolicy,
  title   = {GigaWorld-Policy: An Efficient Action-Centered World--Action Model},
  author  = {Ye, Angen and Wang, Boyuan and Ni, Chaojun and Huang, Guan
             and Zhao, Guosheng and Wang, Xiaofeng and Chen, Xinze and Zhu, Zheng and others},
  journal = {arXiv preprint arXiv:2603.17240},
  year    = {2026},
  url     = {https://arxiv.org/abs/2603.17240}
}
Motivation
现有 WAM 有两大瓶颈:① 推理开销大——同时对未来视觉动态和动作联合推理很贵;② 表征纠缠——联合建模把视觉表征和运动表征绑在一起,动作精度严重依赖未来视频预测的质量。GigaWorld-Policy 想「以动作为中心」,让视频生成只在训练时提供监督、推理时可省。
Method
- 双分支耦合训练:分支一,给定当前观测预测未来动作序列;分支二,以「预测动作 + 同一观测」为条件生成未来视频。
- 双重监督:策略同时被「动作预测」和「视频生成」监督,用视觉-动态约束提供更丰富信号、鼓励物理合理动作。
- 因果设计→推理可丢视频:因果保证未来视频 token 不影响动作 token,因此显式视频生成在推理时是可选的,部署时只跑动作预测加速。
- 数据/骨干:自建多样大规模机器人数据集,先预训练一个以动作为中心的视频生成模型,再适配为策略学习骨干。
Experiments
- 真机:作者相对论文中的 WAM 基线 Motus 报告约 9× 推理加速和 7 个百分点的任务成功率提升;需要结合相同硬件、动作频率和任务设置理解。
- RoboTwin 2.0:相比 π0.5,性能提升 95%。
Strengths and Limitations
Strengths:视频分支主要作为训练期辅助监督,推理时保留动作分支,从而降低生成视频带来的延迟。论文在指定系统中报告约 9× 加速;代价是推理时不再保留显式未来视频用于可视化或规划。
局限(分析):丢掉视频分支后就失去了「测试时规划/可视化」能力(与 Cosmos-Policy 取向相反);效率数值项目页与摘要冲突,需回原文;自建数据集细节与开放性待查。
Takeaways
GigaWorld-Policy 把 WAM 的效率问题挑明并给出干净答案:训练时用视频监督、推理时把它扔掉。它和「保留视频分支做规划」的 Cosmos-Policy 形成一对张力——视频生成到底是推理时的资产还是负担,是 WAM 的一个根本设计选择。
MotuBrain
MotuBrain: An Advanced World Action Model for Robot Control
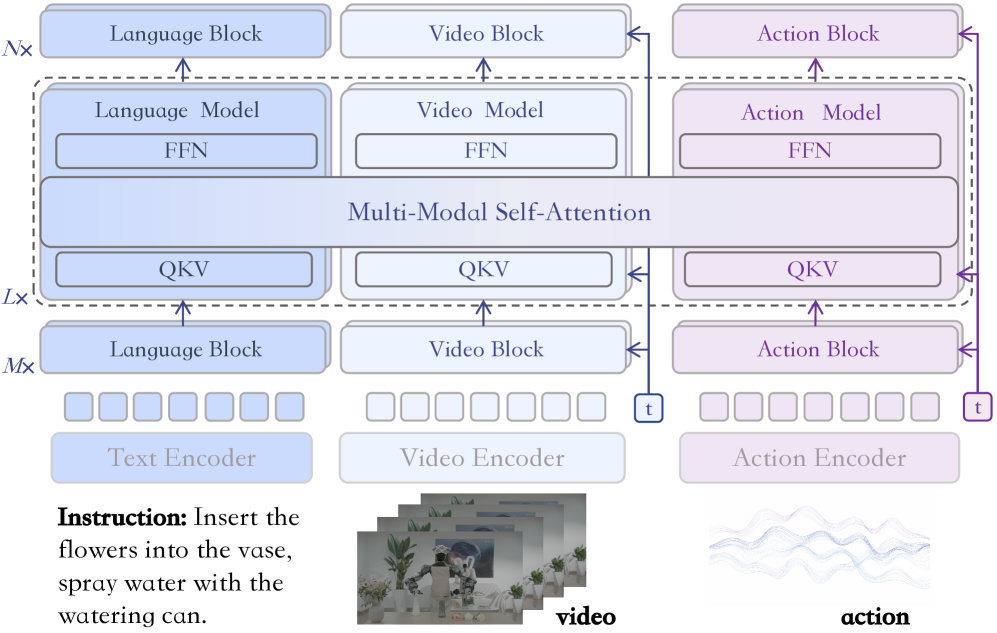
一句话用 UniDiffuser 框架 + 三流(three-stream)Mixture-of-Transformers,把视频、动作、文本联合建进一个统一模型:单模型同时支持 policy learning / world modeling / video generation / inverse dynamics / joint video-action prediction;在前作 Motus 上加统一多视角、独立文本流、共享跨本体动作表示,再配一整套推理加速(step reduction / FP8 / DiT caching / V2A 仅动作推理)做到实时闭环、可部署。
年份 / Venue arXiv 2026(2604.27792)| 机构 ShengShu Technology(生数科技 · Fan Bao、Jun Zhu 等)| 方向 Unified multi-task WAM, deployment | 真机 ✅ 真机 + 少样本 humanoid 适配
BibTeX
@article{motubrain2026,
  title        = {MotuBrain: An Advanced World Action Model for Robot Control},
  author       = {{MotuBrain Team} and Xiang, Chendong and Bao, Fan
                  and Tan, Hengkai and Zhu, Jun and others},
  journal      = {arXiv preprint arXiv:2604.27792},
  year         = {2026},
  organization = {ShengShu Technology},
  url          = {https://arxiv.org/abs/2604.27792}
}
Motivation
VLA 语义泛化好,但缺乏对世界动态的细粒度建模。MotuBrain 想用一个统一的 World Action Model 同时兼顾语义泛化与动态预测,并把「多任务能力 + 长时程真实控制 + 可部署」一次性做到位。
Method
- UniDiffuser + 三流 MoT:在 UniDiffuser 形式下联合建模 video + action + text,采用三流 Mixture-of-Transformers。
- 单模型多任务:一套权重支持 policy learning、world modeling、video generation、inverse dynamics、joint video-action prediction。
- 异构数据可扩展:吃 video-only、task-agnostic、cross-embodiment 机器人数据。
- 在 Motus 上升级:引入统一多视角建模、独立文本流(增强 language-action 耦合)、共享跨本体动作表示,以及 post-training + 部署配方。
- 推理栈优化:step reduction、编译、FP8 量化、DiT caching、V2A 式仅动作推理、实时分块闭环。
Experiments
- 推理加速:作者相对其 naive baseline 报告 50×+ 加速,并在指定硬件、缓存和精度配置下达到最高约 11 Hz;该结果不能跨实现直接比较。
- RoboTwin 2.0:clean 95.8% / randomized 96.1% 平均成功率。
- WorldArena:取得其自述最强 EWMScore。
- 跨本体适配:仅 50–100 条轨迹即可适配新的 humanoid 本体。
Strengths and Limitations
Strengths:同一架构支持世界建模、策略、视频生成和逆动力学等多种训练模式,三流 MoT + UniDiffuser 提供统一接口。作者报告的 50×+ 加速和最高 11 Hz 来自特定优化组合;跨本体结果仍需更多独立实验确认。
局限(分析):统一多任务模型训练/调度复杂;EWMScore/WorldArena 为其自建评测口径,横向可比性需谨慎;摘要层面未见明确 Limitations;数值均作者自报,逐项回原文。
Takeaways
MotuBrain 代表 WAM 的「统一 + 可部署」支线:不追单点最优,而是把「世界建模 + 策略 + 视频生成 + 逆动力学」压进一个可实时部署的模型。它建在 Motus 之上——而 Motus 恰是 LingBot-VA / GigaWorld-Policy 反复对比的强 baseline,可见这条工业界赛道的竞争密度。
RepWAM
RepWAM: World Action Modeling with Representation Visual-Action Tokenizers
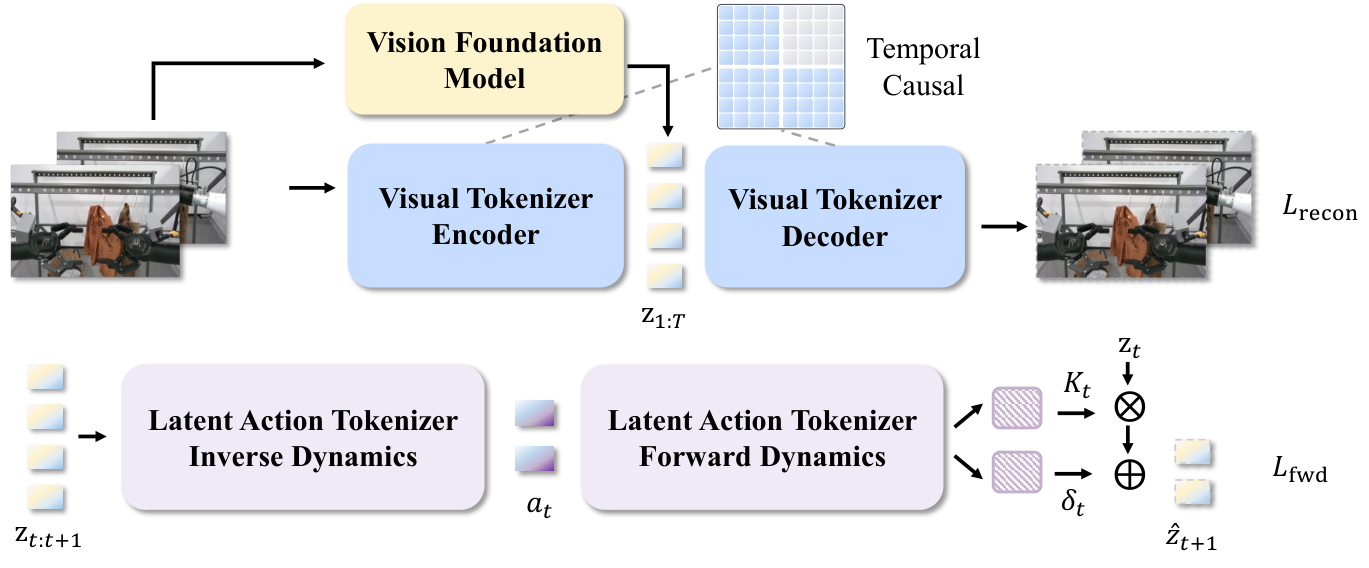
一句话换掉「只做像素重建」的视频 tokenizer:训练一个表征型视觉-动作 tokenizer(RepViTok),把视觉输入映射为对齐的视觉 token + 隐式动作(latent action)token,在这个语义 latent 空间里联合建模「未来视觉状态 + 连接前后状态的隐式动作」,再在真机轨迹上适配成闭环策略——让世界模型的未来预测与机器人控制真正接上。
年份 / Venue arXiv 2026(2606.13674)| 机构 复旦大学 · 蚂蚁 Robbyant · 港科大(Junke Wang 等)| 方向 Representation tokenizer for WAM | 真机 ✅ 真机操作
BibTeX
@article{wang2026repwam,
  title   = {RepWAM: World Action Modeling with Representation Visual-Action Tokenizers},
  author  = {Wang, Junke and Zhang, Qihang and Yang, Shuai and Luo, Yiming
             and Shen, Yujun and Wu, Zuxuan and Jiang, Yu-Gang and Xu, Yinghao},
  journal = {arXiv preprint arXiv:2606.13674},
  year    = {2026},
  url     = {https://arxiv.org/abs/2606.13674}
}
Motivation
现有 WAM 通常直接继承预训练视频生成模型那套以重建为导向的视频 tokenizer。这类 tokenizer 保真度高,但作者指出「仅靠像素重建,对学习『连接未来预测与机器人控制』的指令跟随动态提供的指导有限」——像素细节多,语义/动作信号弱。
Method
- 表征视觉-动作 tokenizer(RepViTok):把视觉输入映射为对齐的视觉 token + 隐式动作 token,结合像素重建与语义对齐(项目页)。
- 语义 latent 里建 WAM:在语言指令下联合建模未来视觉状态与连接它们的隐式动作。
- Causal WAM 主体:一个 diffusion transformer,视频与动作预测共享 attention、但各用 expert-specific FFN(项目页)。
- 真机适配:再在真实机器人轨迹上适配,实现闭环操作。
Experiments
- arXiv 摘要仅笼统称「在真实操作任务和仿真基准上均取得强性能」,摘要本身未给精确数值;消融显示语义视觉-动作 tokenization 优于重建导向方案。
- 项目页给出摘水果、推抽屉、插管和 RoboTwin 2.0 等任务结果;正文不将不同任务、难度与评测协议压缩成一个总体性能数字,具体值以项目页对应表格为准。
Strengths and Limitations
Strengths:指出并针对 WAM 的一个隐藏薄弱环节——tokenizer 只会重建像素;用表征 + 隐式动作 token把语义/控制信号显式化;多机构(复旦 + 蚂蚁 + 港科大)联合、与 LingBot-VA 同一 Robbyant 脉络。
局限(分析):核心增益(tokenizer 语义化)需更多横向消融支撑;精确成功率仅项目页,可比性待原文表格;隐式动作 token 的可解释性/迁移性待考。
Takeaways
RepWAM 代表 WAM 的「表征结构」支线:别人在改怎么耦合视频与动作,它往下一层改「视频 token 本身」——把重建导向的 tokenizer 换成表征导向。这与本篇 World Models 里 JEPA「在表征空间而非像素预测」的赌注遥相呼应。
OA-WAM
OA-WAM: Object-Addressable World Action Model for Robust Robot Manipulation
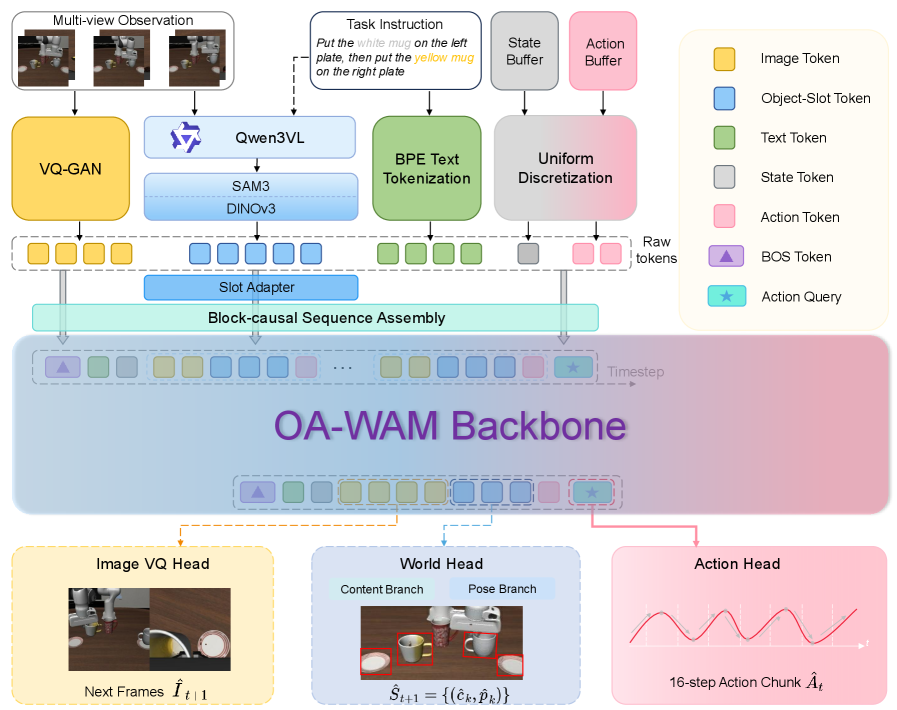
一句话把预测的「世界」从整幅图像/视频 token/全局隐变量,拆成对象可寻址(Object-Addressable)的槽位状态:每个物体一个持久 address 向量 + 时变 content 向量,让动作解码器能精确「寻址」到指令所指的那个物体——把「该对哪个物体动作」和「该物体现在是什么」解耦,从而在场景扰动、物体身份变化下更鲁棒。
年份 / Venue arXiv 2026(2605.06481)| 机构 未在元数据标注(Yushan Liu 等)| 方向 Object-centric slot WAM | 真机 LIBERO / SimplerEnv 基准
材料 Paper
BibTeX
@article{liu2026oawam,
  title   = {OA-WAM: Object-Addressable World Action Model for Robust Robot Manipulation},
  author  = {Liu, Yushan and Sun, Peibo and Li, Shoujie and Xie, Yifan
             and Zhang, Lingfeng and Chao, Xintao and Dong, Shiyuan
             and Chen, Fang and Zhang, Xiao-Ping and Ding, Wenbo},
  journal = {arXiv preprint arXiv:2605.06481},
  year    = {2026},
  url     = {https://arxiv.org/abs/2605.06481}
}
Motivation
现有 WAM 把预测的世界表示为 holistic images / video tokens / global latents。当指令指向某个特定物体、且场景发生变化(物体身份与上下文纠缠)时,动作解码器很难「寻址」到该物体,鲁棒性下降。OA-WAM 想给世界模型一个对象级、可寻址的结构。
Method
- 槽位分解:把每帧分解为 N+1 个 slot 状态——1 个机器人 slot + N 个物体 slot。
- address + content:每个 slot 含一个持久 address 向量 + 一个时变 content 向量;与 text / image / proprioception / past-action token 在 block-causal 序列中融合。
- 双头:world head 预测下一帧 slot 状态;flow-matching action head 在同一次前向中解码 16 步连续动作 chunk。
- 强制可寻址:跨 slot attention 只走 address-only keys,每层 transformer 重置 address 切片——把「该对哪个物体动作」与「该物体当前是什么」解耦,且不新增 token。
Experiments
- LIBERO 97.8%;SimplerEnv 79.3%(称「matches strong VLA/WAM baselines」,作者自报)。
- LIBERO-Plus:在最相关的**几何轴(geometric axes)**上达 SOTA,七轴综合「保持竞争力」。
- 因果 slot 干预(swap-binding cosine):0.87,而 holistic 基线至多 0.09——量化「可寻址」带来的解耦。
- 逐项基线对比与七轴具体分数摘要未给,需回原文表格。
Strengths and Limitations
Strengths:把对象中心结构注入 WAM,契合「指令常指向具体物体」的操作本质;address/content 解耦 + address-only attention 是干净的机制设计;不新增 token、单前向出 16 步动作,效率友好;swap-binding 0.87 vs 0.09 是有力的机制证据。
局限(分析):依赖物体槽发现与绑定质量,杂乱或遮挡场景可能退化;主要在 LIBERO、SimplerEnv 等基准上验证,真机闭环鲁棒性仍需补充。截至 2026-09-11,正文只保留论文能够确认的作者与来源信息,不推测未明确列出的机构。
Takeaways
OA-WAM 代表 WAM 的「对象结构」支线,和 World Models 里的 FOCUS(物体中心世界模型)一脉相承——都在赌「显式的物体归纳偏置能让世界模型更鲁棒」。区别是 OA-WAM 把这一先验直接接到了动作解码的「寻址」上。
DiM-WAM
DiM-WAM: World-Action Modeling with Diverse Historical Event Memory
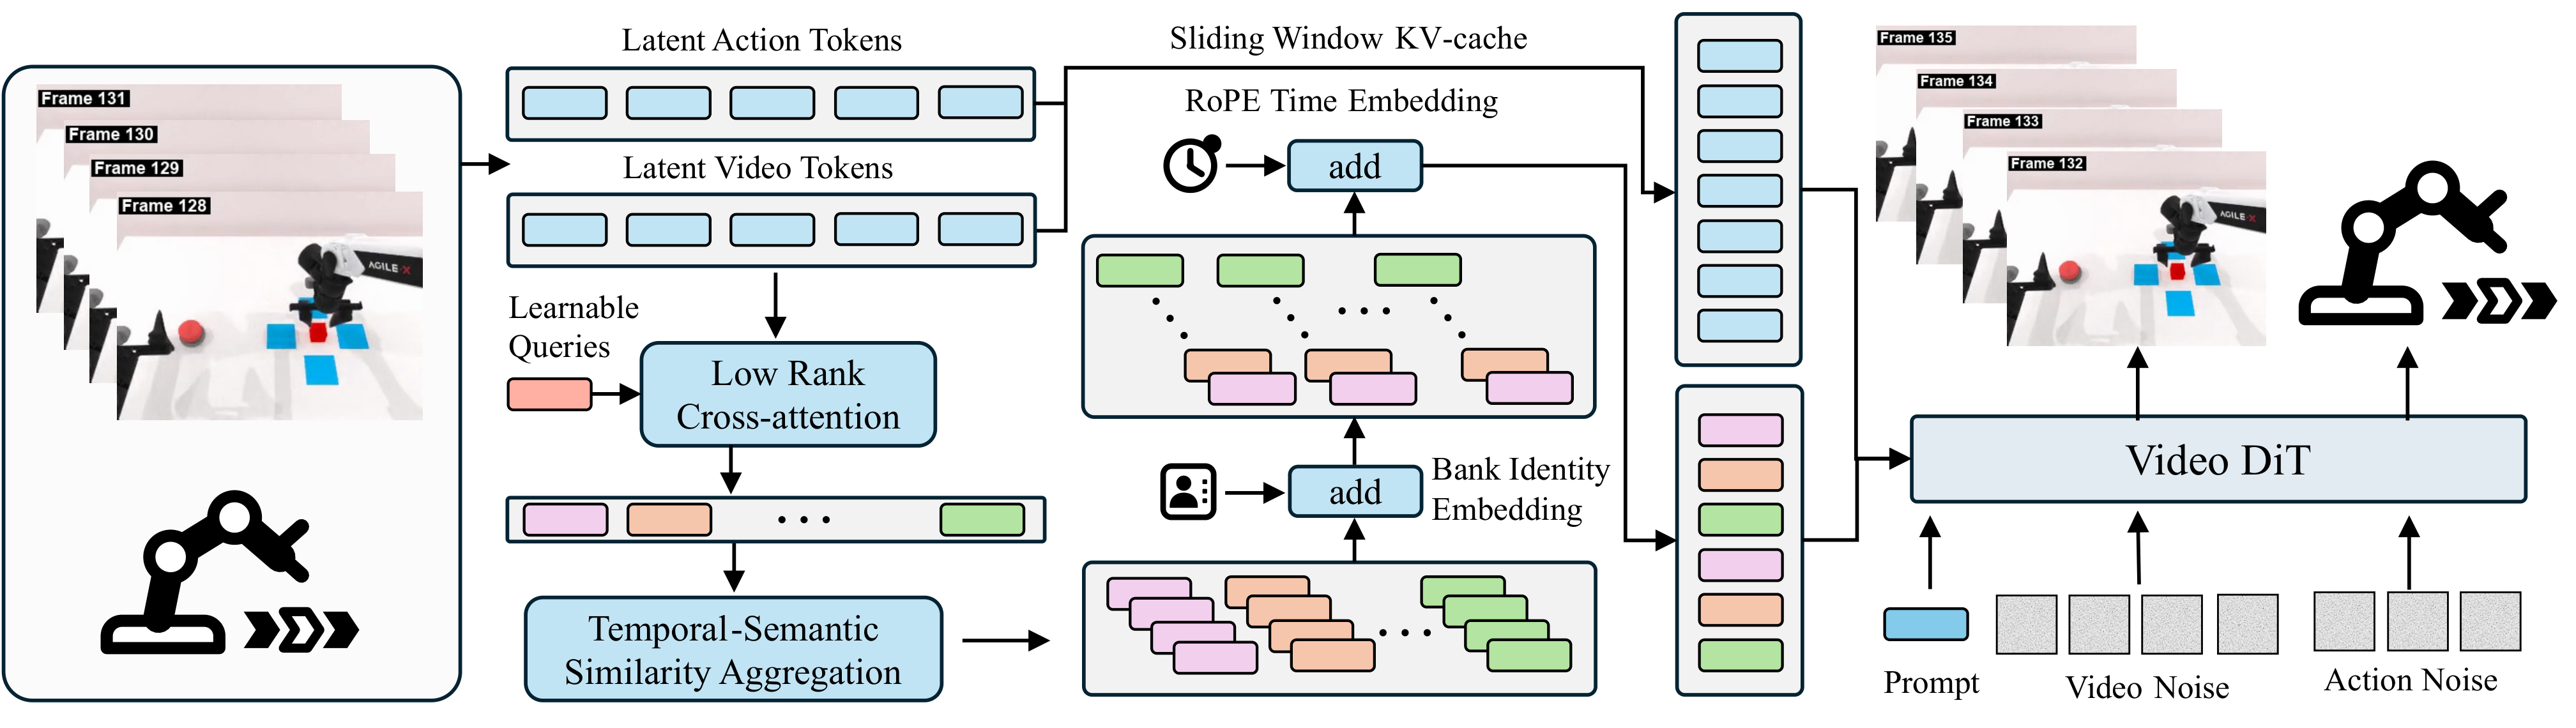
一句话给「世界-动作模型」加多组历史事件记忆库:从观测中抽取、压缩互补的历史事件信息,融合多尺度历史上下文 + 局部未来动态 + 全局任务进度,并用任务进度监督引导记忆 token 编码「已完成阶段/当前目标」,专门缓解**长时程(long-horizon)**操作里的「遗忘」问题。
年份 / Venue arXiv 2026(2606.27677)| 机构 中科院自动化所 CASIA(+ Yinwang · FiveAges,Kai Wang 等)| 方向 Memory-augmented WAM, long-horizon | 真机 ✅ 真机 Franka
BibTeX
@article{wang2026dimwam,
  title   = {DiM-WAM: World-Action Modeling with Diverse Historical Event Memory},
  author  = {Wang, Kai and Gu, Zhaopeng and Chen, Yixiang and Xu, Yuan
             and Ma, Qisen and Su, Peng and Li, Zhaowen and Huang, Yan and Wang, Liang},
  journal = {arXiv preprint arXiv:2606.27677},
  year    = {2026},
  url     = {https://arxiv.org/abs/2606.27677}
}
Motivation
现有 world-action 方法主要依赖短期历史,在长时程操作任务上会丢失关键历史信息,导致阶段推进和任务完成能力下降。DiM-WAM 想用结构化记忆把「久远但关键」的历史事件保住。
Method
- 多专用记忆库:维护多个 memory banks,从观测中抽取并压缩互补的历史事件信息。
- 三类信息融合:多尺度历史上下文 + 局部未来动态 + 全局任务进度。
- 任务进度监督:用 task progress supervision 引导记忆 token 编码「已完成阶段/当前目标」。
- 联合建模:把整合后的记忆用于视频预测 + 动作预测的联合建模。
Experiments
- 仿真 RMBench:平均成功率约 69.8%(作者自报)。
- 真实 Franka:整任务成功率约 52.5% → 80.0%,阶段成功率约 91.5%。
Strengths and Limitations
Strengths:直面 WAM 的长时程遗忘——一个此前较少被专门处理的问题;多记忆库 + 任务进度监督是清晰的结构化解法;真机 Franka 有整任务/阶段两级指标。
局限(分析):多记忆库增加建模与调度复杂度;截至 2026-09-11 代码尚未发布,复现性有限。不同页面曾出现指标或作者展示差异,因此本文只采用 arXiv 当前版本能够直接确认的信息,评测规模和横向口径仍需后续版本补充。
Takeaways
DiM-WAM 代表 WAM 的「记忆结构」支线:当任务变长,短期历史不够用,就给世界模型配一套分尺度的事件记忆。它和 OA-WAM(对象结构)、RepWAM(表征结构)一起,构成「给 WAM 注入结构先验」这条与「堆规模」正交的路线。
Cross-Paper Comparison
| 论文 | 骨干 / 框架 | 视频×动作耦合 | 出动作方式 | 推理效率手段 | 局限(分析) |
|---|---|---|---|---|---|
| Cosmos-Policy | Cosmos-Predict2 视频模型 | 动作/状态/价值→latent frames | 扩散生成 + 测试时规划 | 单阶段后训练;仍需跑扩散 | 推理成本高、规划开销 |
| DreamZero | 14B 自回归视频扩散 | 联合预测未来状态 + 动作 | zero-shot 策略 | 系统优化达 7Hz | 骨干巨大、部署成本高 |
| LingBot-VA | Wan2.2-5B 双流 MoT | 视频-动作交错因果自回归 | 逆动力学反推动作 | 异步 + 半量去噪 + KV cache | 工程复杂、模型仍重 |
| GigaWorld-Policy | 动作中心视频生成骨干 | 双分支互监督 | 动作分支直出 | 因果设计→推理丢视频 | 丢视频=失去规划/可视化 |
| MotuBrain | UniDiffuser 三流 MoT | video/action/text 联合 | 多任务(含 V2A) | 50×+ 加速、FP8、caching | 统一模型复杂、自建评测 |
| RepWAM | Causal WAM + 表征 tokenizer | 语义 latent 里建隐式动作 | 隐式动作 → 闭环适配 | — | 数值仅项目页、增益需更多消融 |
| OA-WAM | block-causal slot Transformer | 物体槽(address+content) | flow-matching 单前向 16 步 | 不新增 token | 依赖物体绑定、以基准为主 |
| DiM-WAM | 记忆增强 WAM | 记忆 + 视频/动作联合 | 联合预测出动作 | — | 长时程专攻、数值待核、未开源 |
Discussion
把八篇放一起,WAM 的版图沿几条轴展开:
-
视频生成是推理时的「资产」还是「负担」? 这是 WAM 最本质的分歧。
- 资产派:Cosmos-Policy 保留视频 + 价值,用来测试时规划;DreamZero 让 14B 视频模型直接实时闭环。好处是可规划、可视化、泛化强,代价是推理贵。
- 负担派:GigaWorld-Policy / MotuBrain(V2A)用因果设计让视频只在训练时监督,推理时丢掉视频分支,只留轻量动作头。好处是快,代价是失去规划/可视化。
- 折中派:LingBot-VA 保留视频但半量去噪 + 异步执行,让「想象」与「执行」并行,既要闭环鲁棒又要实时。
-
视频与动作在哪层、以何种结构耦合?
- latent frames(Cosmos-Policy):动作也当帧,零改架构。
- 多流 MoT(LingBot-VA 双流、MotuBrain 三流):各模态各 backbone,跨模态注意力融合。
- 双分支(GigaWorld-Policy):动作/视频分支耦合训练、解耦推理。
- 换 token(RepWAM):往下一层改 tokenizer,在表征空间建隐式动作。
- 换世界表示(OA-WAM 物体槽、DiM-WAM 记忆库):把「世界」从整幅像素换成对象/事件结构。
-
结构先验 vs 规模化。RepWAM(表征)、OA-WAM(对象)、DiM-WAM(记忆)代表「注入结构先验」的支线;DreamZero(14B)、Cosmos-Policy、MotuBrain 则更靠「通用视频骨干 + 规模 + 工程」——这与 World Models 里「FOCUS/RoboDreamer 结构化 vs Dreamer/V-JEPA 规模化」的张力如出一辙。
-
和 VLA 的关系。 Robot Learning (2) 的 π0 系列直接学习观测到动作的条件分布;本篇 WAM 额外预测未来观测,或把视频作为训练期辅助信号。两类模型正在共享 flow matching、动作专家和视频骨干等组件,但未来系统是否必须同时保留显式世界预测与策略输出,仍是需要实验回答的问题。